[Maeumjigi 心语伴侣毕业设计开发日志 #14] 全模型微调圆满收官与多卡并行推理评估 (Eval) 管线构建
· 阅读需 2 分钟

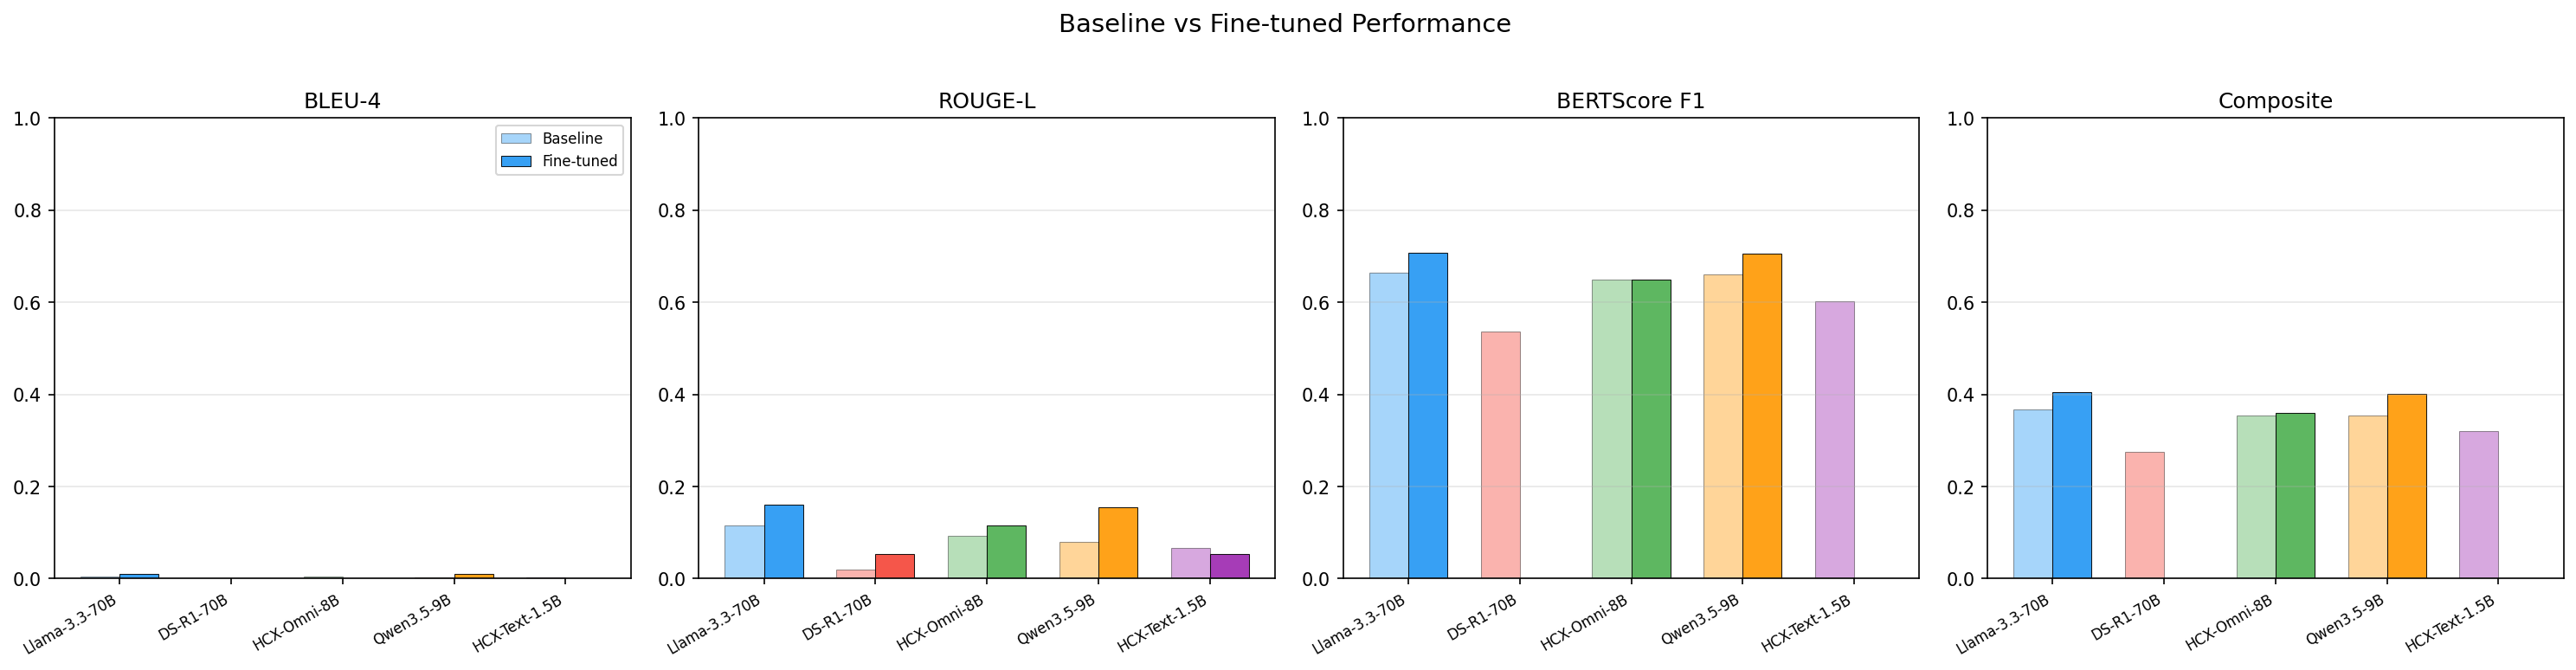
5 月 6 日,历经数个不眠之夜与超参数反复调试,我们终于从漫长的微调泥潭中成功破局! 以 HCX-Omni-8B 与 Qwen35-9B 为代表的中轻量级垂直大模型全量微调顺利收敛完工。
微调圆满收工:收敛日志与损失曲线分析
伴随训练步数稳步推进,系统损失 (Loss) 呈现出极其稳健的单调下降收敛态势:
step= 1200  loss=0.9698  lr=1.88e-04  gpu=7.7GB
step= 1250  loss=0.8523  lr=1.86e-04  gpu=7.7GB
...
step= 1650  loss=0.8783  lr=1.73e-04  gpu=7.7GB
在审视日志期间,团队曾反复向 AI 确认损失打点细节:“当前输出的是 Train Loss 还是 Eval Loss?我们的监控脚本是否同步记录了验证集指标?”鉴于模型已完整完成所有 Epoch 训练(“全量微调全部圆满完工,全面转入结果综合评估”),我们依据生成的最新权重检查点,立即迈向定性推理与定量评估 (Eval) 阶段。
双卡 GPU 负载均衡:构建全自动多卡并行推理流水线
依托 20_eval_ft_models.ipynb 脚本,我们对各大模型针对典型心理倾诉提示词的生成质量展开盲测。为了支持长程共情引导,我们将最大生成长度 (max_new_tokens) 统一放宽至 1024。
但在初测时,单卡推理延迟远超预期:
“训练时我们明明挂载了两块高端显卡,为何推理评测只单卡跑,速度这么慢?”
为了 100% 榨干服务器的算力潜能,在 AI 的协同重构下,我们全新编写了多进程并行推理流水线 run_eval_parallel.sh。此举将基准测试耗时压缩了数倍,更实现了将各模型的生成文本、响应时延与困惑度 (Perplexity) 全自动汇总导出为结构化 Excel 报表的高级流水线。
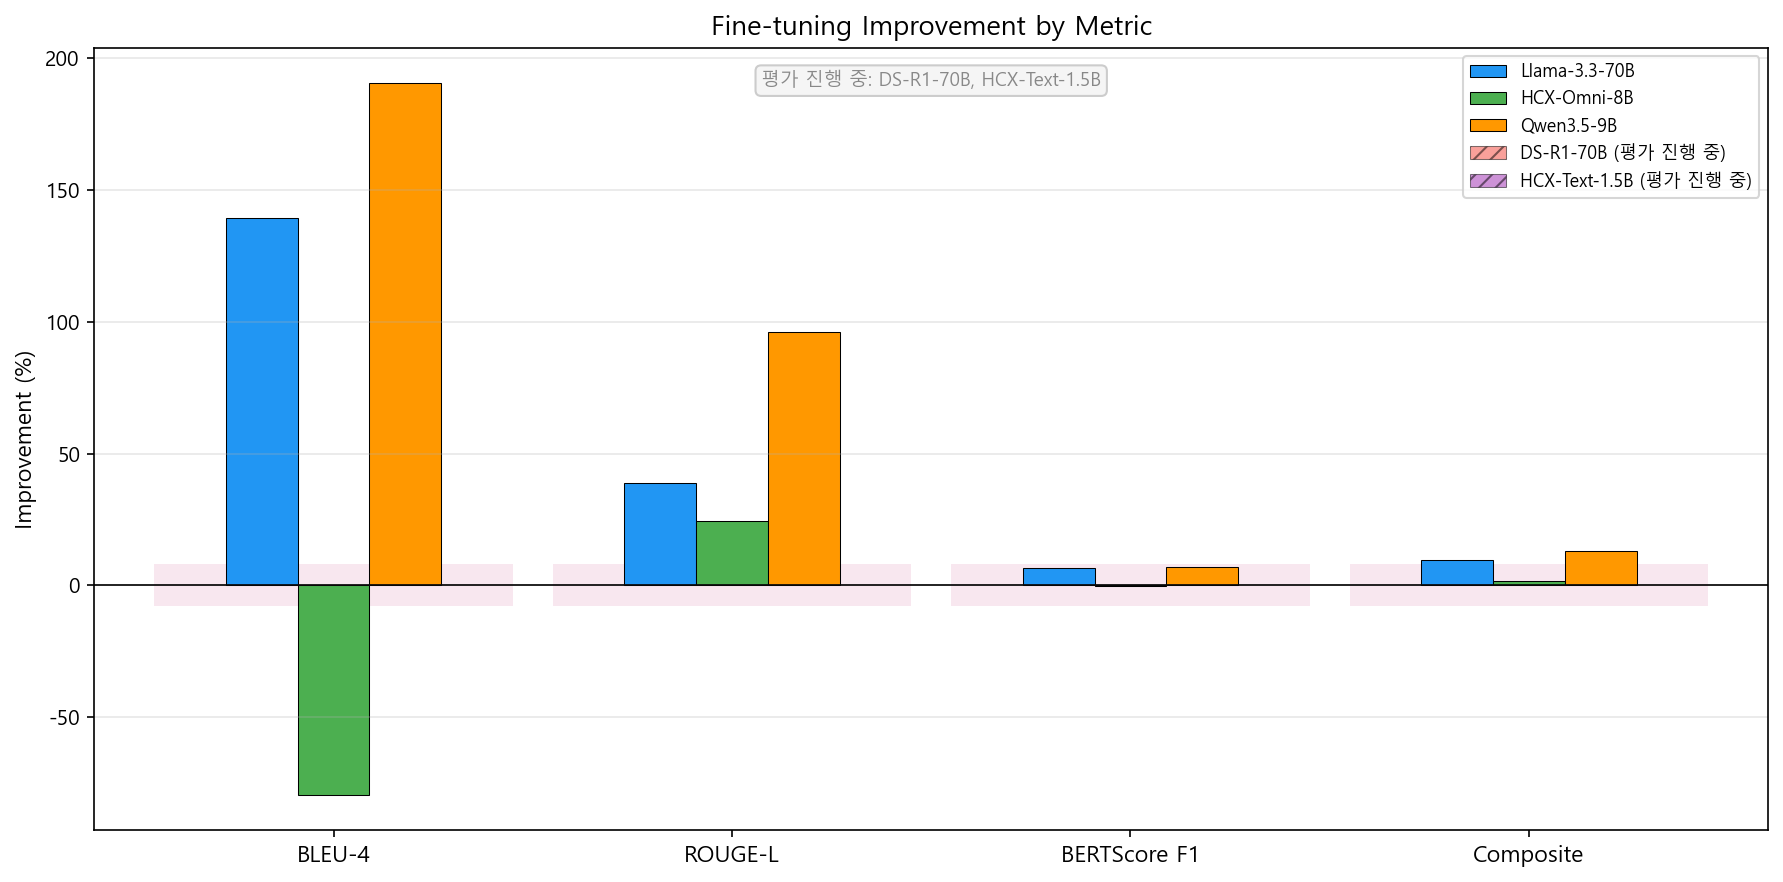
尽管在从 DSR1-70B 切换至下一个模型时曾因 PyTorch 显存未完全垃圾回收 (GC) 抛出显存占用冲突,但通过并行脚本的环境进程隔离设计,该问题被彻底根治。现在,终于到了真刀真枪对比各模型应答水准的决战时刻!