[Maeumjigi 心语伴侣毕业设计开发日志 #15] 5 大模型微调成果全景可视化与本地评测环境搭建

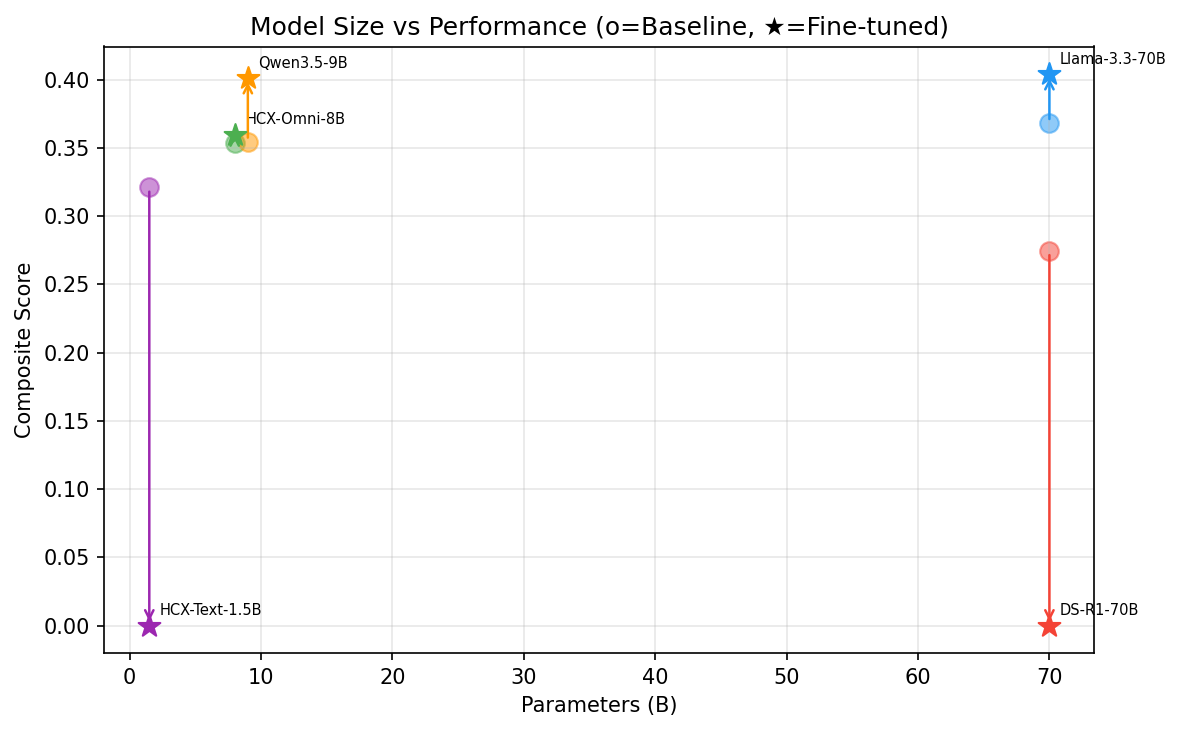
5 月 7 日,我们对倾注心血完成微调的 5 大代表性大模型(Llama 3.3-70B、DSR1-70B、HCX-Omni-8B、Qwen35-9B、HCX-Text-1.5B)的实验数据进行了全景汇总, 并全面展开了深度可视化与轻量化本地评测环境的搭建。
模型多维横向对齐:本地轻量级可视化环境配置
为了在个人笔记本电脑上脱离沉重的 GPU 服务器独立审视对比分析数据,我们全新重构了 31_comparison_local.ipynb 脚本。
“此前在服务器上运行的 30_comparison.ipynb 能否直接在本地工作站无缝执行?” “请给出在当前 VSCode 选定 Jupyter 内核中安装 pandas、matplotlib、seaborn 与 bert_score 的标准化指引。”
在本地环境配置过程中,我们遇到了内核崩溃 (Kernel Crashed) 以及 ModuleNotFoundError: No module named 'ft_utils' 等典型依赖路径异常,但通过精准校准模块寻址顺利化解。针对 DSR1-70B 等模型在训练时偶发的 ft_metrics.json 遗失,也编写反向解析脚本实现了指标数据的完整抢救。
5 大模型全景综合报告与多维收敛图表绘制
核心任务是构建能够一眼洞察 5 大模型性能鸿沟的高清可视化图表。我们与 AI 联合制定了 5MODELS_ORGANIZATION_PLAN_present.md 规范方案,展开了结构化数据制图。
“图表中的虚线与平滑粗线分别代表什么物理意义?请将所有模型的 Training Loss 与 Eval Loss 分别汇聚绘制成两幅横向对比大图。” “剔除平滑拟合粗线,保留更具实验真实细节的高清原始收敛折线并持久化导出。”
我们优化了 AI 输出的 Matplotlib 渲染参数,最终导出了排版极为规整的 03_training_loss_all.png 与 04_eval_loss_all.png。此外,还同步完成了揭示各模型 LoRA 秩分解 (Rank Decomposition) 特性分析图以及 GPU 显存占用对照雷达图 (02_gpu_memory.png)。
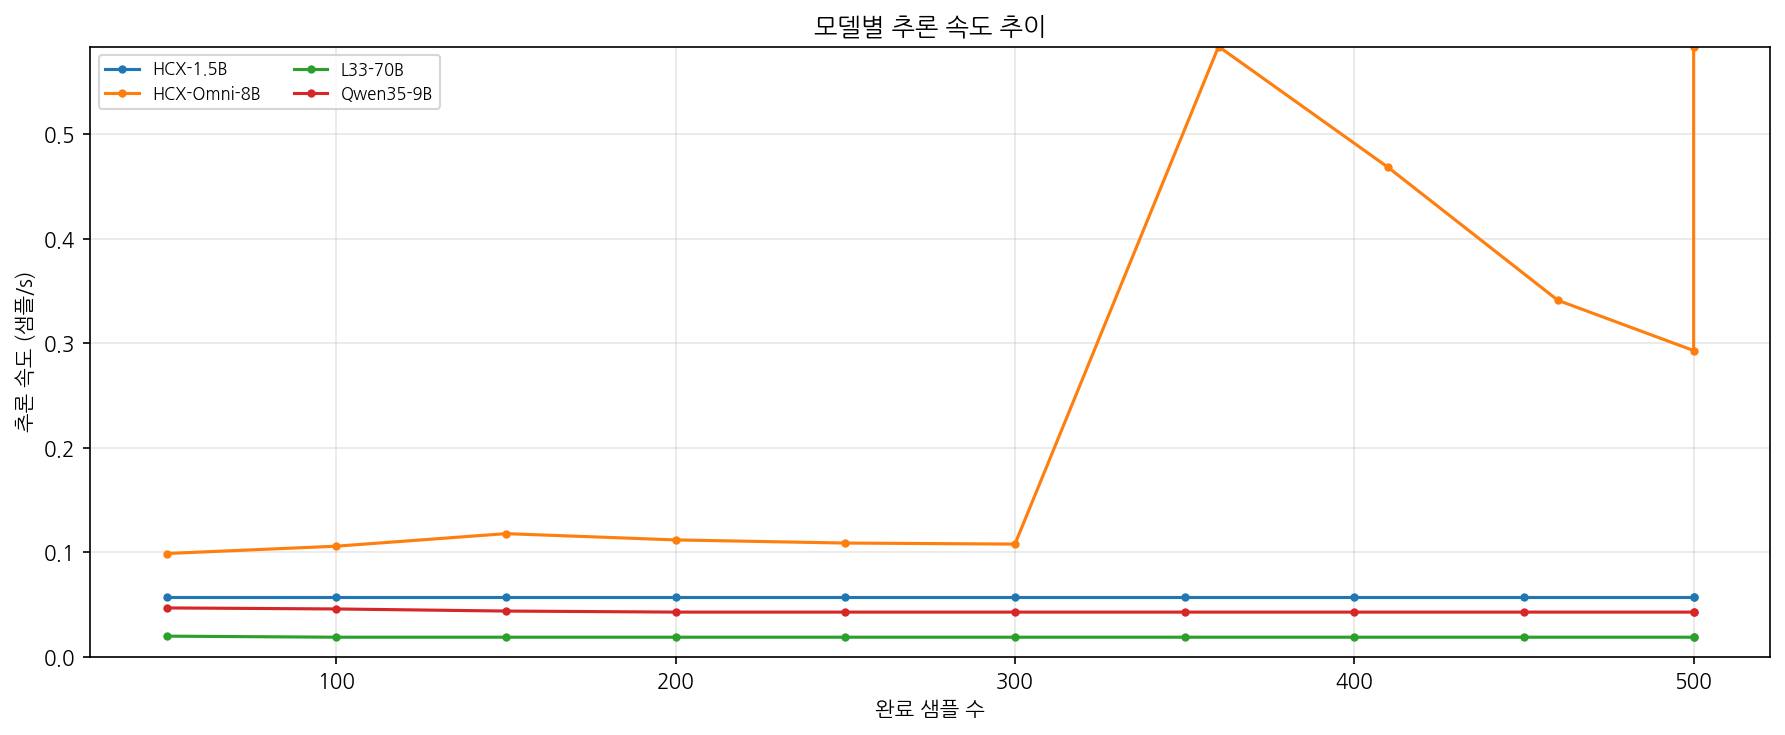
依托这组严密规整的实验图表,我们为下周举行的毕业设计阶段性中期评审准备好了无可挑剔的成果佐证。在这 5 大各具特色的候选模型中,究竟谁能拔得头筹,成为心语伴侣的终极决策大脑?