[Maeumjigi 心语伴侣毕业设计开发日志 #16] 致命参数失误排查、第二轮全量微调与 React Native 移动端首发

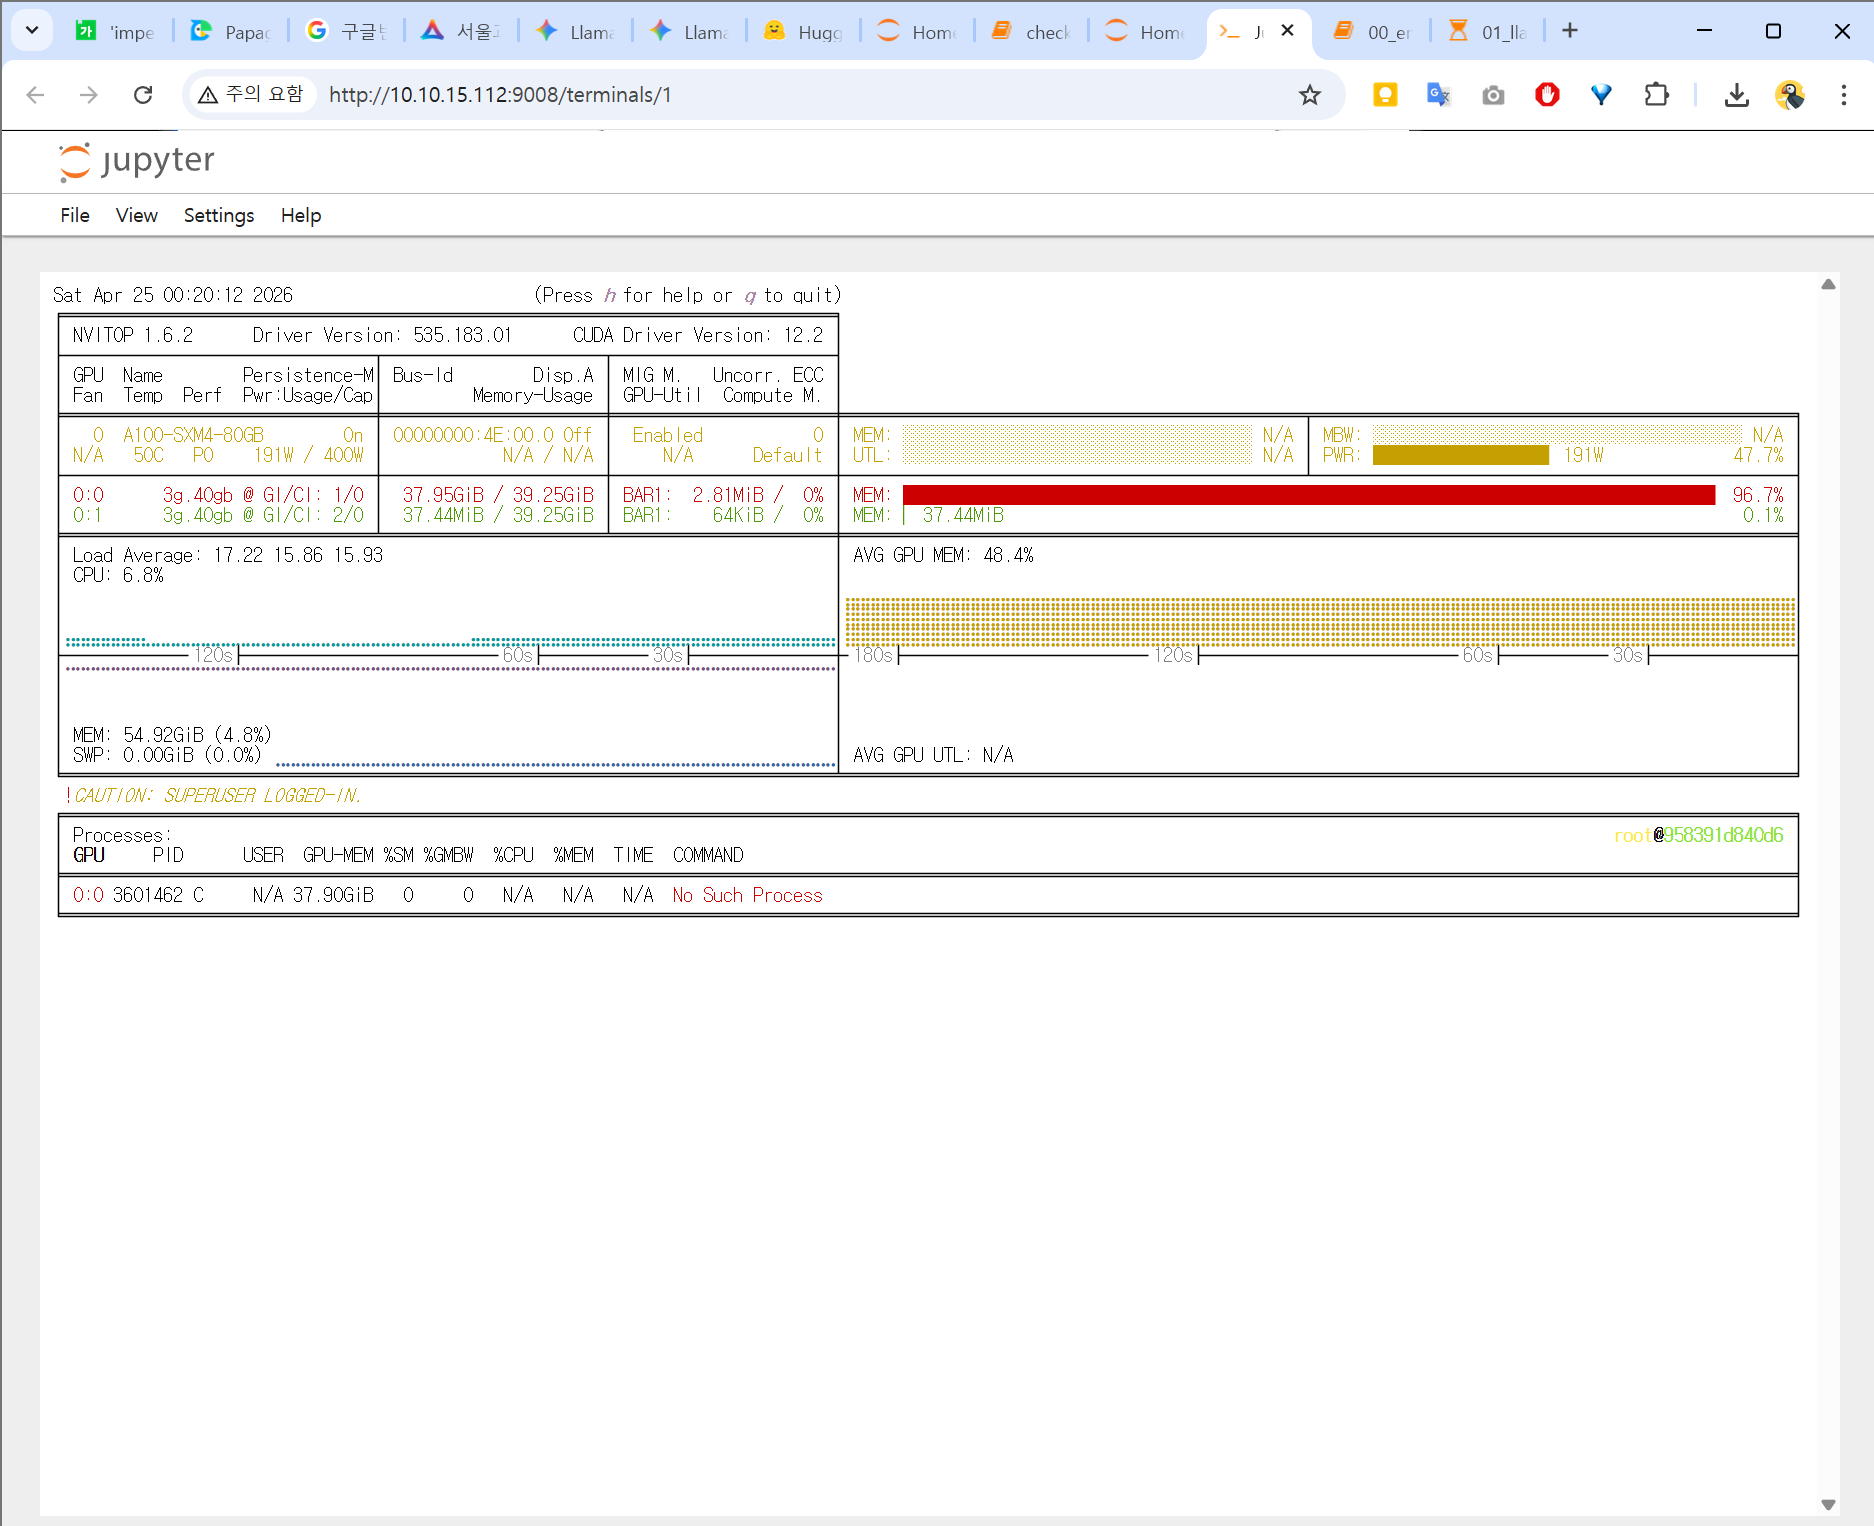
5 月 8 日,原本是我们基于此前的全量微调成果紧锣密鼓赶制毕业设计中期答辩幻灯片 (PPT) 的关键日子。 然而,正在满怀欣喜填充评测表格时,我们却突然揪出了一个令人毛骨悚然、颠覆前期结论的技术暗伤!
触目惊心:排查出 LoRA 超参数配比的致命失误
在与 AI 共同校对即将编入答辩材料的模型架构图与超参数明细时,我们意外注意到了反常端倪:
“仔细审视微调后的回复样本,句式长度居然比未经微调的基座模型还要简短局促。原本以为是将 LoRA 的 r 设为 8、alpha 设为 16 导致瓶颈维度压缩过度……” “等等,缩放因子比例是 $\alpha/r$?天哪,我此前一直当成了 $r/\alpha$ 去配置……?!我到底以怎样扭曲的比例应用了 LoRA 权重?!”
在 LoRA 微调标准实践中,通常将 alpha 设为与 rank 相等或为其 2 倍以保持平滑缩放。然而,由于公式记忆倒置,我们竟无意中以颠倒的缩放系数极大地抑制或暴击了参数梯度更新。难怪微调后的大模型在很多场景下回复短促断裂——祸根恰恰潜伏在最初的配置项中。
绝不妥协:果断打响第二轮深度微调 (fine_tuning_2)
虽已具备第一轮评测数据,但为了追求心语伴侣的极致心理干预水准,绝不能将就掩盖问题。我们当即创建 fine_tuning_2 目录,全面打响第二轮纠偏微调:
“本轮选定模型涵盖 HCX-Text-1p5B、Llama33-70B 与 Qwen35-9B。在 MIG-0 实例上执行 rank=16, alpha=16,在 MIG-1 上对比测试 rank=16, alpha=8。” “从 Daily_train_dataset.jsonl 中筛选出字符长度最长的前 2000 条长程心理对话,单独提炼为 Daily_train_dataset_long.jsonl 强化长文本生成能力。”
为了彻底扭转短回复缺陷,我们专门提炼出长文本高质量子集,并借助 MIG 多实例 GPU 分配方案展开超参并行对照微调。
算力训练与移动端 App 开发双线狂飙
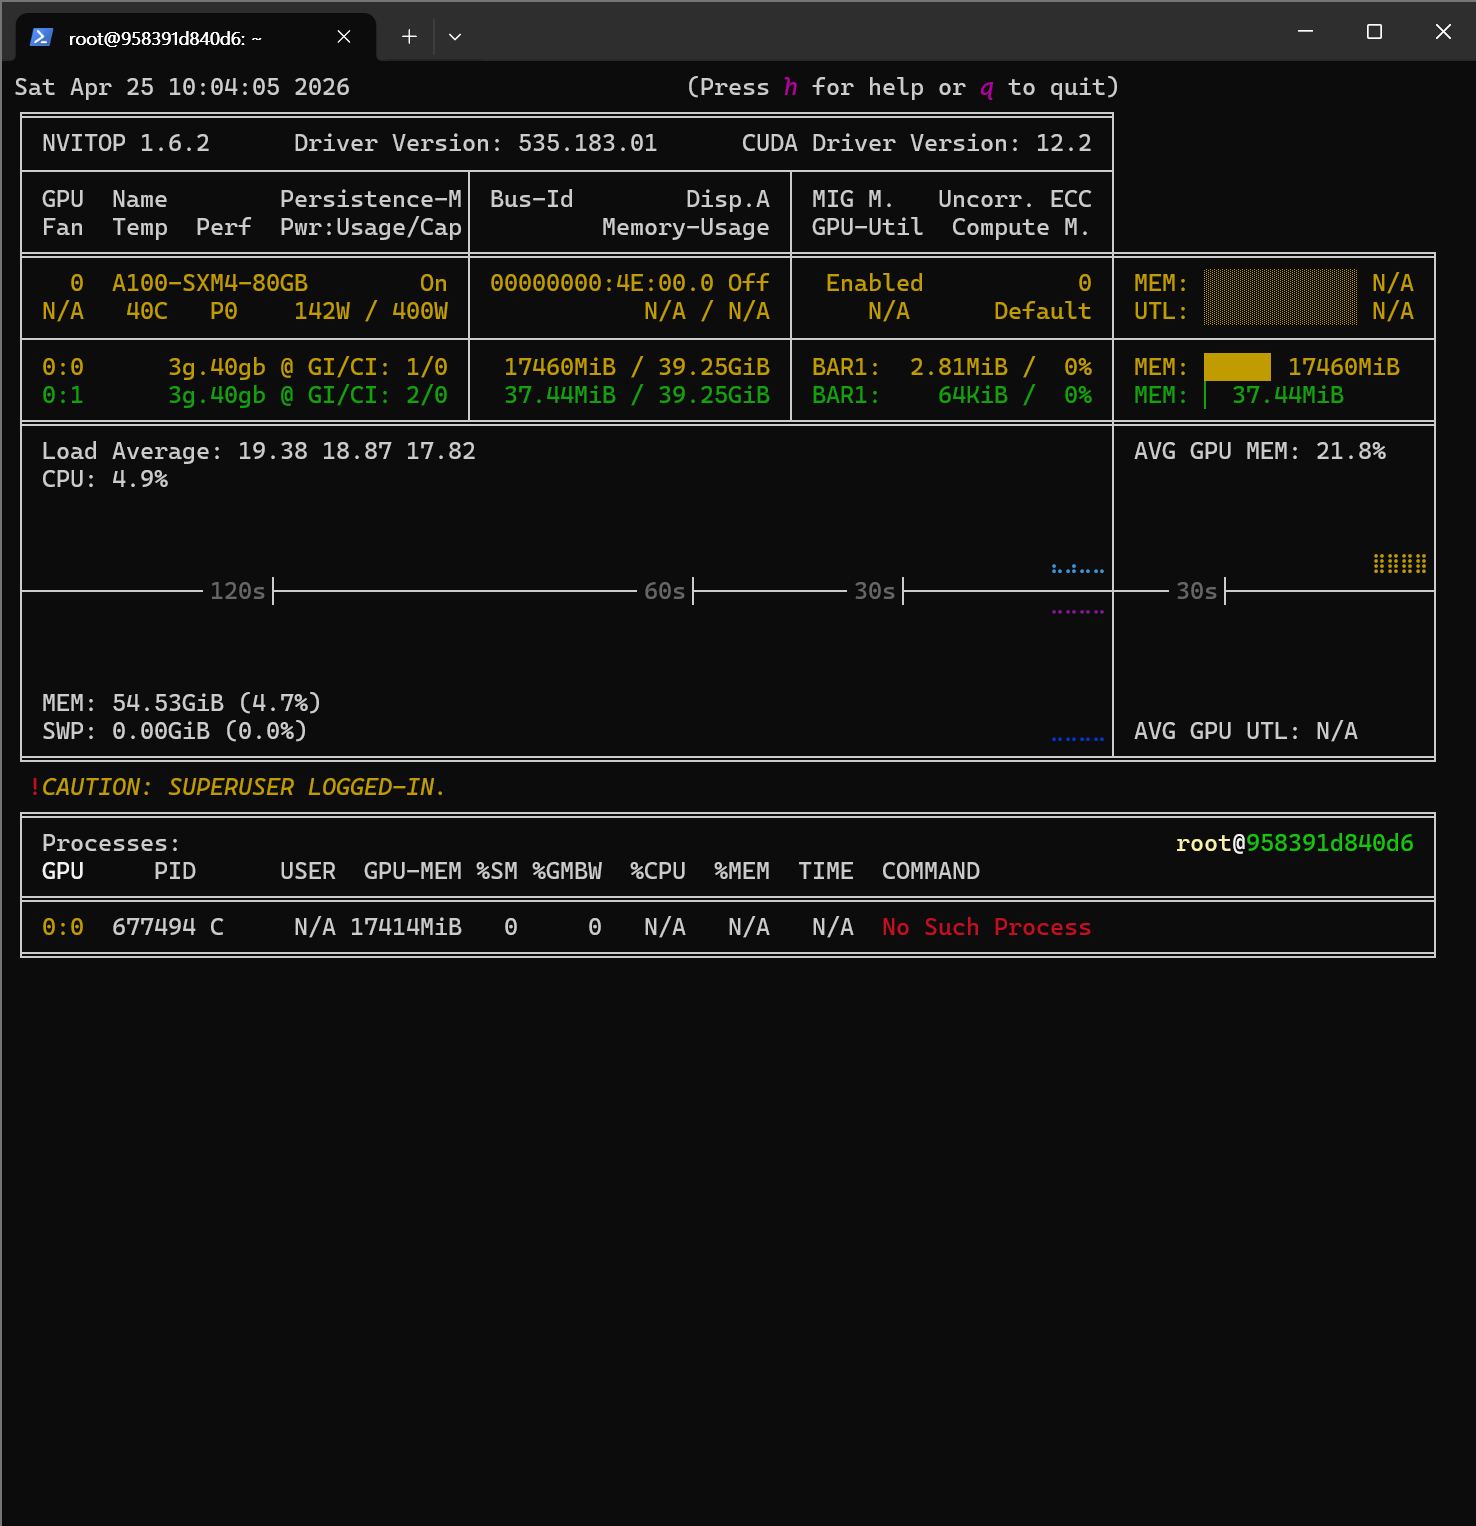
在模型在服务器集群中全速重新微调的同时,研发脚步一刻不停——正式启动让真实用户能够随身使用的前端移动端 App 工程!
“在本地拉起 maeum-app 移动端需要展示二维码……但我误敲了 npx go start 导致报错频出。请指导如何正确调出 Expo 调试二维码并在真机上预览?”
我们利用 React Native (Expo) 初始化了移动端应用 maeum-app,成功调出调试控制台并配置了品牌图标 (assets/logo.png)。后端的 AI 大脑与前端的用户门面正同步孕育破茧,这是充满技术激情的一天!