[Maeumjigi 心语伴侣毕业设计开发日志 #17] 第二轮微调胜利收官与自动化评估流水线的硬编码陷阱

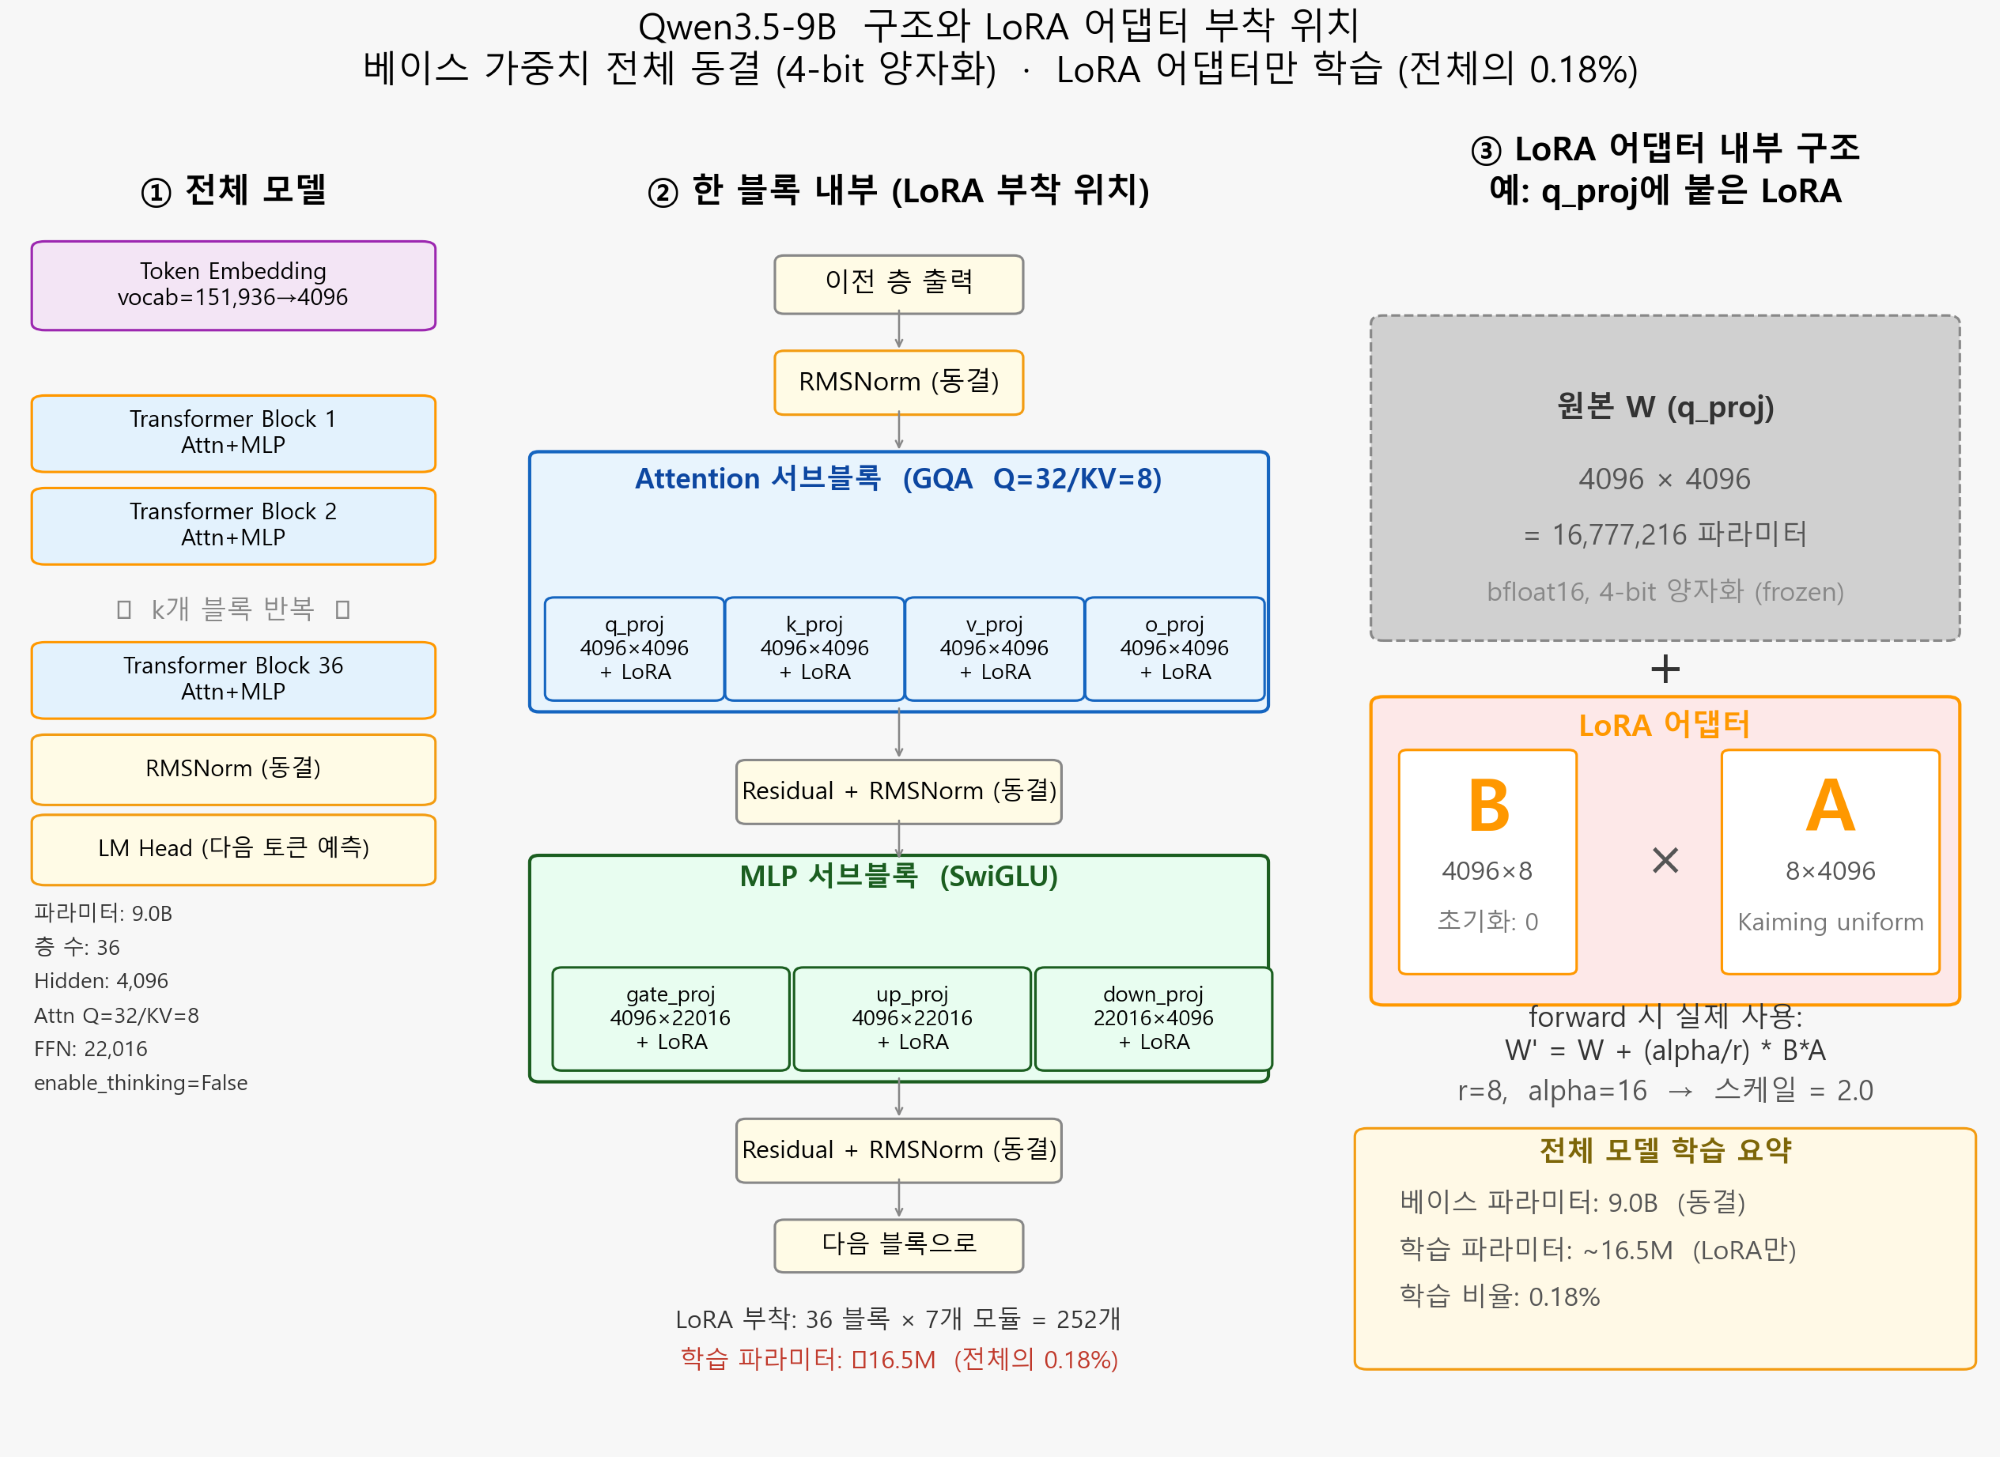
为了拨乱反正、纠正 LoRA 超参数配比倒置而仓促启动的第二轮微调 (fine_tuning_2) 多卡并行长跑,终于在 5 月 12 日迎来了胜利的曙光!
萃取最佳检查点 (Best Checkpoint) 与端到端推理管线组装
覆盖 3 大模型、6 组超参数组合的矩阵微调全量收敛。我们比对验证集损失 eval_loss,提取出泛化能力最强的第一梯队检查点,归档至各模型对应的 adapter 目录。
为了在后台全自动串接批处理推理 (Eval) 与结果对比 (Comparison),我们编写了 run_test_20_30.sh 脚本:
“当前 HCX-Text-1p5B 模型在 15 分钟内仅输出了 12 条生成结果,GPU 显存利用率仅有 1.6GB……”
推理吞吐却再次陷入令人绝望的龟速泥潭。即便针对参数量仅 1.5B 的极轻量模型,平均每分钟也吐不出完整的一句话。显存利用率长期徘徊在 1.6GB 低位,究其根源在于推理端 Batch Size 被死死锁死为 1。加之服务器磁盘空间告警,被迫紧急将工程根目录整体迁移至 ~/home/data/temporary/,修改了全套脚本路径。
乐极生悲:跌入自动化流水线的“硬编码陷阱”
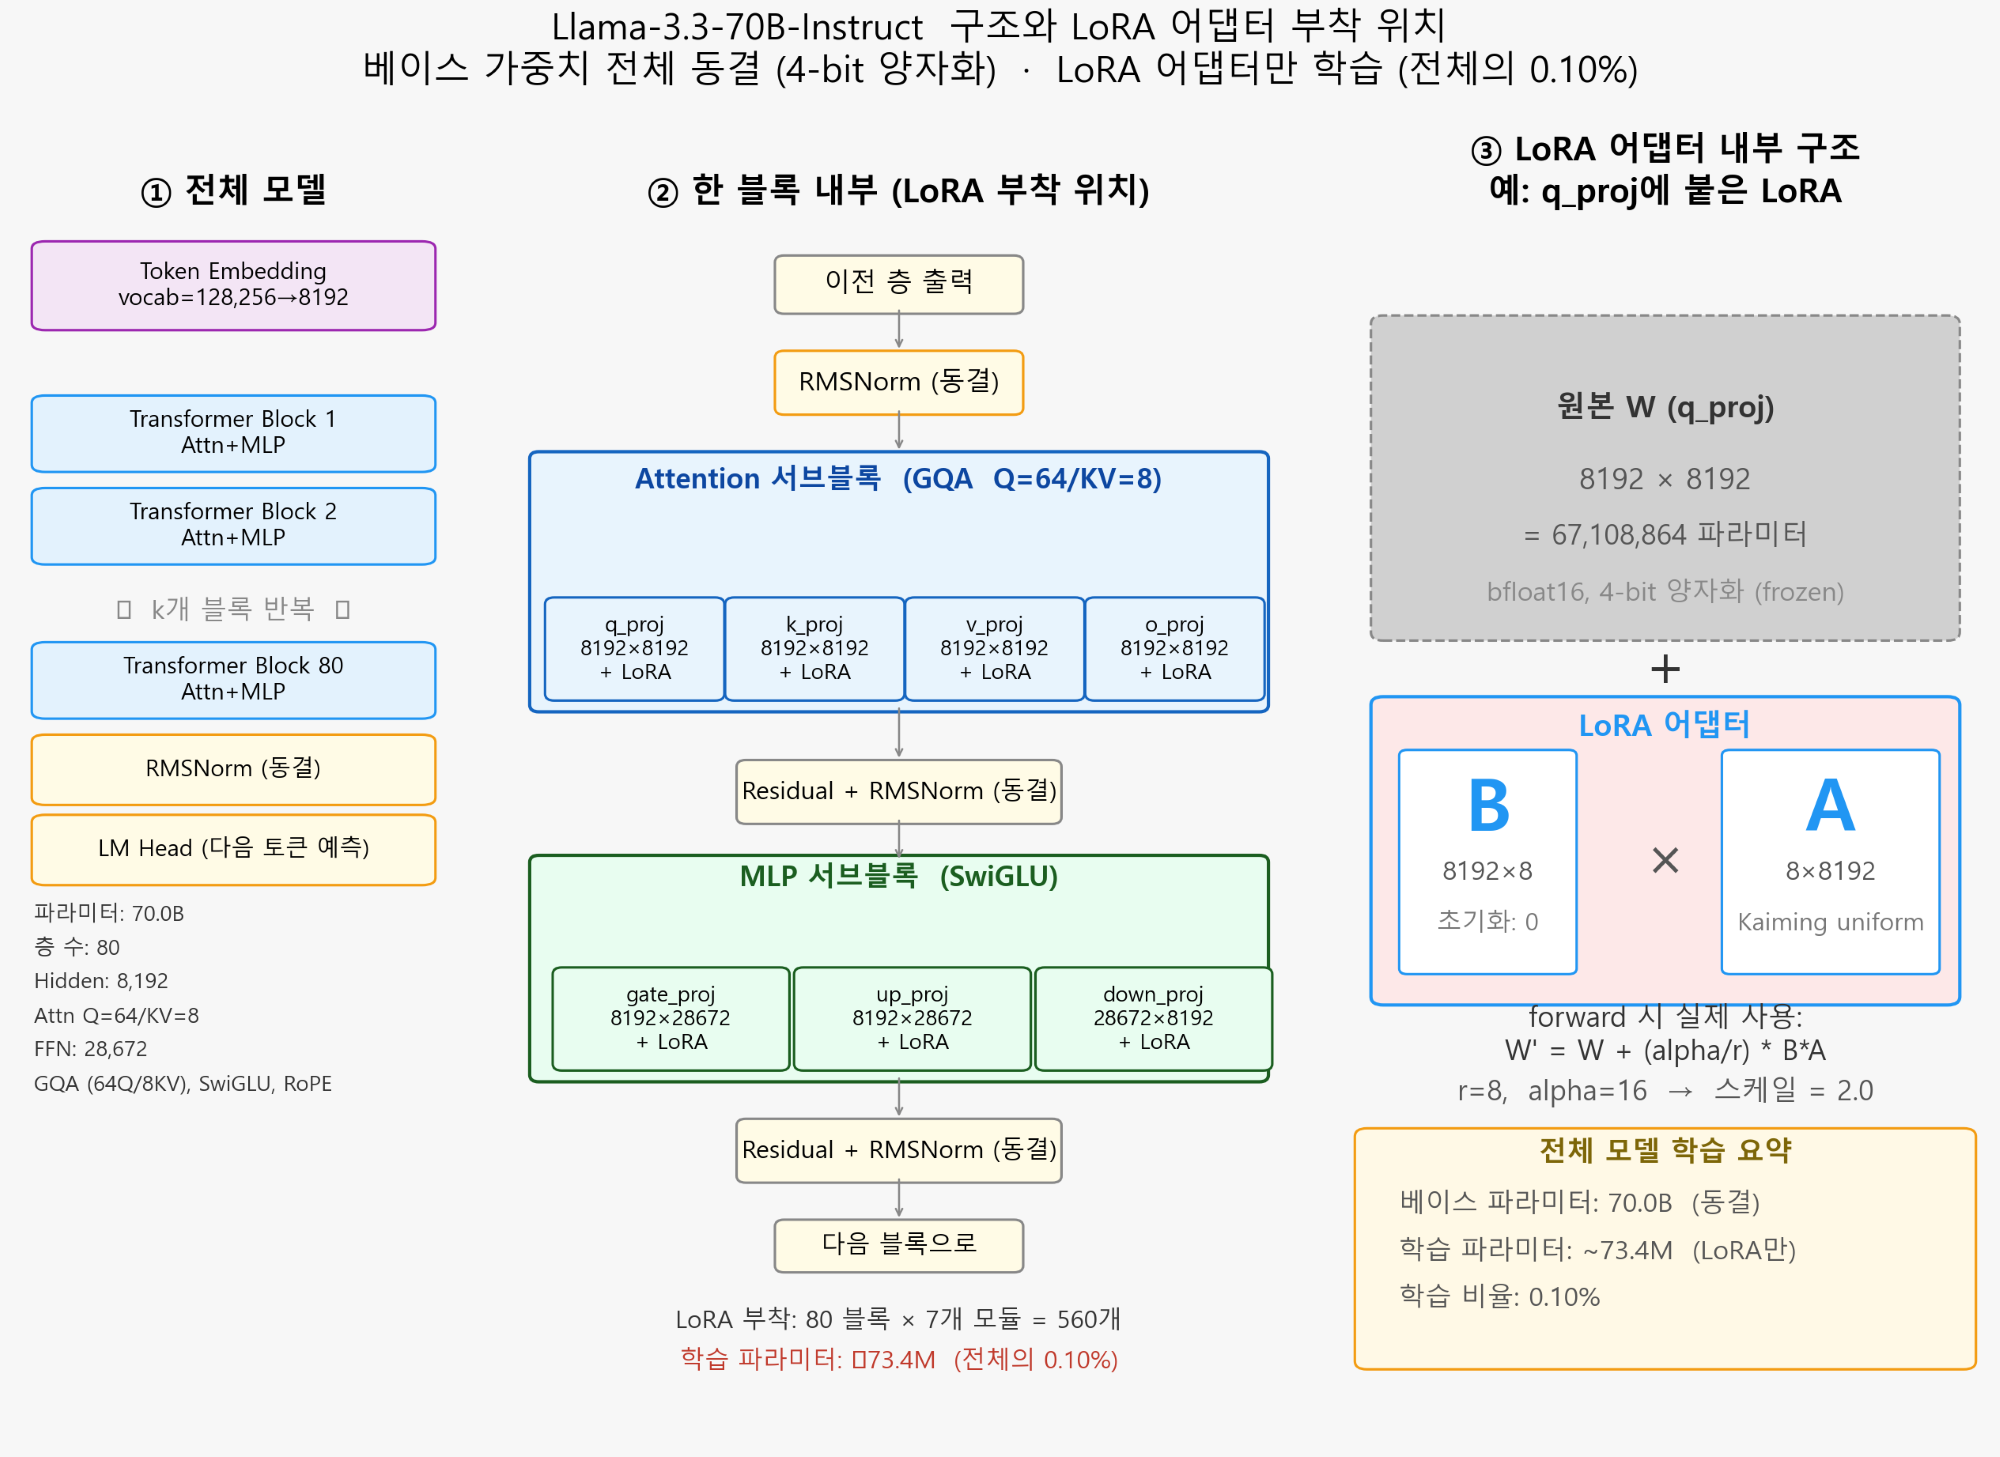
在费尽周折将所有耗时评估脚本跑完后,团队却在代码审查时赫然发现了一个令人窒息的隐蔽 Bug:
“为什么在 20_eval_ft_models.ipynb 中,模型别名居然被死死硬编码为了 MODEL_ALIAS = 'Qwen35-9B_a16'?!” “这意味着在服务器日志中,即使执行的是 20_eval_HCX-Text-1p5B_a8.ipynb,代码底层加载的仍然是 Qwen35-9B_a16?!脚本文件名和实际推断模型完全两码事?!”
是的,在编写自动化批处理模板时,开发者一时疏忽遗留了固定别名硬编码。表面上脚本为 HCX 每次都克隆并派生了独立的 Notebook,但底层代码却始终单调地加载着 Qwen35-9B_a16 的权重反复进行着无效重复推测!
这再次印证:大模型深度微调不仅是高深的科学探索,更是对工程细致度的终极考验。立刻动手扑灭硬编码 Bug,重跑推理流水线!