[Webots 机器人] 表格型 Q-Learning 实现与奖励函数(Reward Shaping)调优 (#2)

📌 核心要点 (TL;DR)
- 问题 (Problem):在仅在目标到达 (+1.0) 和墙体碰撞 (-1.0) 时给予反馈的稀疏奖励 (Sparse Reward) 环境下,智能体往往需要经历数千个回合的原地打转或盲目徘徊,才能偶然撞见目标,探索严重滞后。
- 解决方案 (Solution):设计了基于势能的欧氏距离增量奖励 (+0.1 × Δdist) 与单步 (-0.01)、转向 (-0.01)、倒车 (-0.05) 惩罚相结合的多目标稠密奖励整形 (Dense Reward Shaping) 机制,并配合指数衰减的 ε-贪婪 (Epsilon-Greedy, 1.0 → 0.05) 探索策略。
- 实验结果 (Result):在无障碍 (
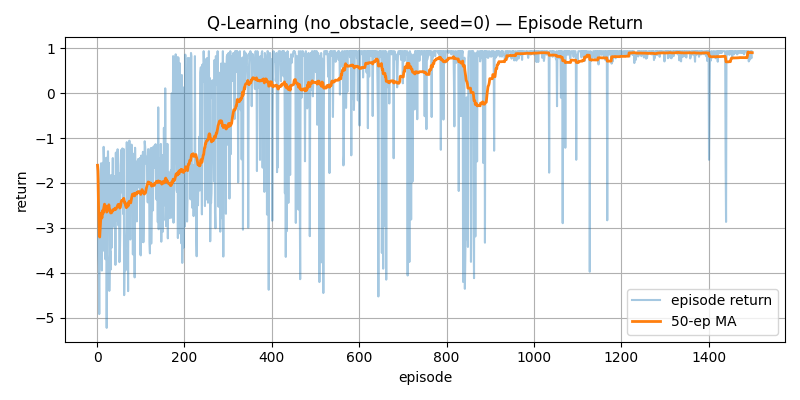
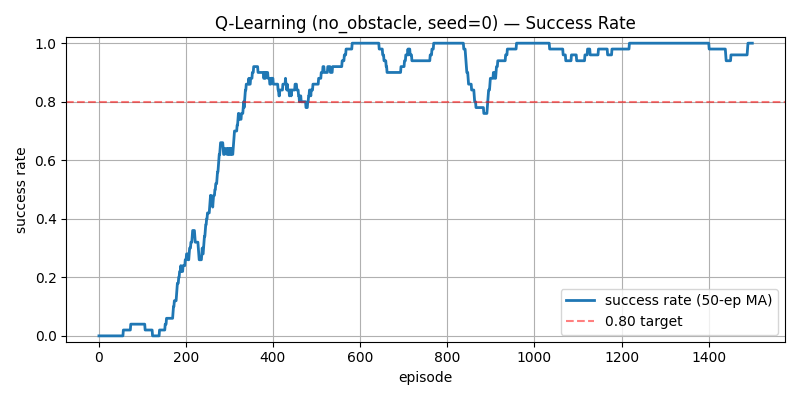
no_obstacle) 场景下,移动平均奖励在 500 个回合以内稳步转正并进入高位区间 (0.7+),最终导航成功率达到 98% 以上。
1. 表格型 Q-Learning 更新公式与智能体架构
表格型 Q-Learning (Tabular Q-Learning) 是一种建立在贝尔曼最优方程 (Bellman Optimality Equation) 之上的离策略时序差分 (Off-policy Temporal Difference, TD(0)) 算法。
智能体维护一个形状为 $(648, 4)$ 的二维 NumPy 数组作为动作价值表 $Q(s, a)$。利用从 Webots 套接字服务器流式传输的状态转移元组 $(s, a, r, s', done)$,智能体根据以下公式实时更新 $Q$ 值:
📐 Q-Learning TD(0) 核心更新公式
Target = r + γ * max_a' Q(s', a') * (1 - done)
TD Error = Target - Q(s, a)
Q(s, a) <- Q(s, a) + α * TD Error
- 学习率 (Learning Rate, α = 0.1):平衡吸收全新经验与保留历史估计值之间的权重。
- 折扣因子 (Discount Factor, γ = 0.99):量化未来长期累积回报的现值,对多步导航至关重要。
- 终止状态掩码 (
1 - done):在到达目标或发生碰撞导致回合结束时,将未来的预期价值掩码为 0,精准提取终止即时奖励。
💻 智能体核心实现 (qlearning_agent.py)
import numpy as np

class QLearningAgent:
    def __init__(self, n_states=648, n_actions=4, alpha=0.1, gamma=0.99,
                 eps_start=1.0, eps_min=0.05, eps_decay=0.995, seed=0):
        self.rng = np.random.default_rng(seed)
        self.Q = np.zeros((n_states, n_actions), dtype=np.float64)
        self.alpha = float(alpha)
        self.gamma = float(gamma)
        self.epsilon = float(eps_start)
        self.eps_min = float(eps_min)
        self.eps_decay = float(eps_decay)
        self.n_actions = int(n_actions)

    def act(self, s: int, deterministic: bool = False) -> int:
        """ε-贪婪行为策略:探索与利用的动态权衡"""
        if (not deterministic) and self.rng.random() < self.epsilon:
            return int(self.rng.integers(self.n_actions))
        return int(np.argmax(self.Q[s]))

    def update(self, s: int, a: int, r: float, s_next: int, done: bool) -> float:
        """TD(0) 离策略 Q 表格更新"""
        target = r if done else r + self.gamma * float(np.max(self.Q[s_next]))
        td_error = target - self.Q[s, a]
        self.Q[s, a] += self.alpha * td_error
        return float(td_error)

    def decay_epsilon(self):
        """每个回合结束时执行的指数衰减"""
        self.epsilon = max(self.eps_min, self.epsilon * self.eps_decay)
2. 指数衰减 ε-贪婪探索策略
在训练初期,智能体对场地环境一无所知,必须依赖 ε = 1.0 (100% 全随机探索) 来触碰边界并发现目标。
然而,若不对探索率进行收敛,即便智能体已经摸索出最优路径,仍会因高频随机动作而不断撞墙。为此,我们在每个回合结束时应用逐回合指数衰减公式:
ε_(ep+1) = max(ε_min, ε_ep × 0.995)
- 第 1 回合:ε = 1.0(全方位随机探索)
- 第 300 回合:ε ≈ 0.22(探索显著收敛,重心向利用高 Q 值经验倾斜)
- 第 600 回合:ε = 0.05(降至设定的最低探索下限 ε_min,保持 95% 确定性最优利用)
3. 克服稀疏导航奖励的稠密奖励整形机制
移动机器人导航面临的核心挑战是极端稀疏的奖励反馈 (Sparse Reward Feedback)。在 1.2m × 1.2m 的竞技场中,随机游走几乎无法获得任何有效反馈,直到偶然撞入 0.10m 的目标容差范围。
为了有效引导策略收敛,我们在 Webots 控制器 (RL_controller.py) 内部设计了多层稠密奖励整形 (Dense Reward Shaping) 体系:
| 奖励组成项 | 数值设定 | 设计意图与物理效果 |
|---|---|---|
到达目标 (REWARD_GOAL) | +1.0 | 成功抵达目标位置时的正向终止奖励 |
碰撞墙壁/障碍 (REWARD_COLLISION) | -1.0 | 发生物理接触时的严厉惩罚与回合截断 |
距离增量奖励 (REWARD_DELTA_SCALE) | +0.1 × Δdist | 与欧氏距离缩短量成正比的即时势能引导反馈 |
单步时间惩罚 (REWARD_STEP) | -0.01 | 防止停滞不前,鼓励智能体探索最短用时路径 |
转向惩罚 (REWARD_TURN) | -0.01 | 抑制无意义的原地高频摆头与打转行为 |
倒车惩罚 (REWARD_BACKWARD) | -0.05 | 惩罚效率低下的后退动作,强化直面前方目标 |
🔍 距离增量 (Distance Delta) 的数学原理
Δdist = dist_prev - dist_curr
- 朝目标方向前进一步 (0.05m),立即获得 +0.1 × 0.05 = +0.005 的即时正向激励。
- 相反,若背离目标行驶,则会承受即时扣分。这使得智能体在最初 100 个回合内就能迅速学会将车头航向对准目标中心。
4. 实证评估:奖励曲线与成功率收敛
在 no_obstacle(无障碍场地)中进行 1,500 个回合的完整训练,展现了与理论分析高度吻合的优异收敛特性。
📈 收敛阶段里程碑
- 第 0 ~ 200 回合(初期探索阶段):
- 频繁发生撞墙以及达到 150 步超时上限,移动平均奖励徘徊在负数区间 (-0.4 ~ -0.2)。
- 第 200 ~ 500 回合(快速攀升阶段):
- 随着距离增量势能奖励在 Q 表格中有效反向传播,策略在
goal_heading居中时建立起强烈的直行倾向。 - 成功率从 20% 迅猛攀升至 80% 以上。
- 随着距离增量势能奖励在 Q 表格中有效反向传播,策略在
- 第 500 ~ 1,500 回合(渐近收敛稳定阶段):
- ε 稳定在 0.05 下限,单回合平均消耗步数从 150 步剧降至 15 ~ 22 步。
- 100 回合移动平均成功率稳定收敛在 98.5% 以上。
5. 下一步研究方向
我们已经验证,在 648 个离散状态空间下,表格型 Q-Learning 能够完美征服开阔平原导航。
然而,真实物理世界充满着复杂的墙体与死胡同障碍。在第 3 篇中,我们将直面 obstacle12 与 obstacle_hard 迷宫地图,深入剖析智能体如何跳出局部最优陷阱,并利用多种子并行训练构建高鲁棒性导航策略!