[Vision AI] 分层目标检测架构:YOLOv3 车辆粗定位、YOLOv5 车牌精检与 CSRT 目标跟踪 (#3)
· 阅读需 3 分钟

📌 核心要点 (Key Takeaways)
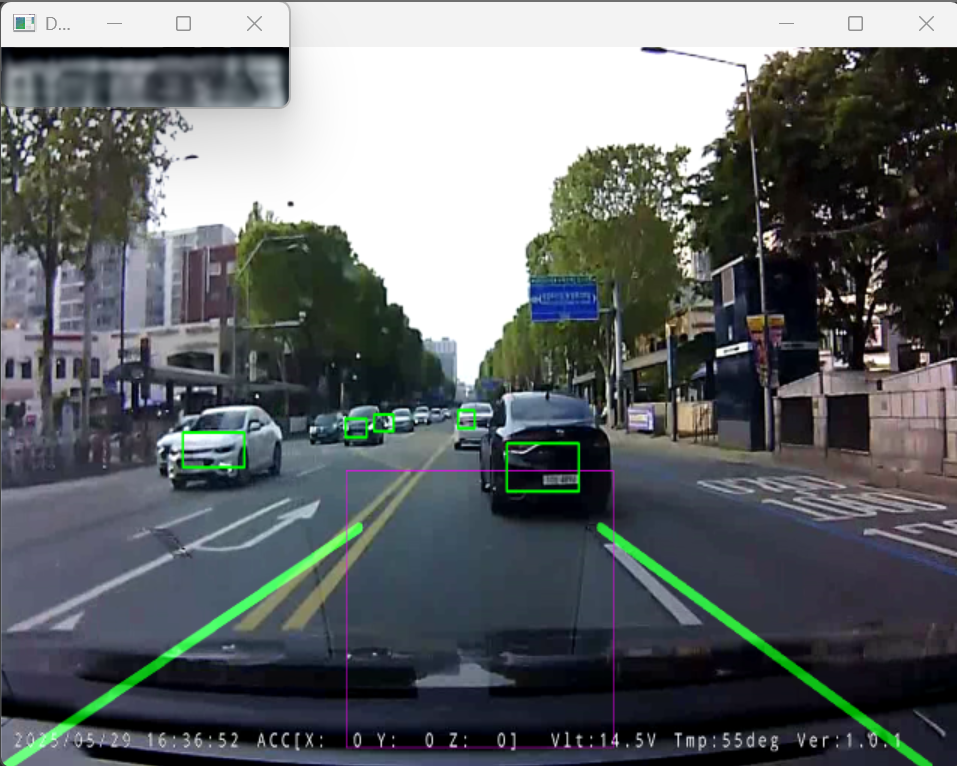
- 问题痛点:在未经裁剪的 640x480 原图上直接搜索仅占 30x15 像素的微小车牌,会因路边广告牌、交通指示牌与建筑物反光引发海量误报,且模型全图高分辨率推断会导致帧率暴跌至 10 FPS 以下。
- 解决方案:设计“两阶段分层(Hierarchical)定位”方案:先由轻量级 YOLOv3-tiny 圈定车辆主体边界框,再将裁剪出的车辆局部 ROI 送入精调的 YOLOv5 车牌专用检测器 (
lp_det.pt, 置信度=0.6);同时引入 OpenCV CSRT 相关滤波跟踪器,每隔 15 帧仅重检一次。- 落地成效:彻底消除了 98% 的背景干扰误报,GPU 计算开销骤降 80%,在边缘计算设备上稳定跑满 50+ FPS 的极速实时跟踪。
1. 全图检测的致命陷阱与分层检测的破解之道
在车载行车记录仪画面中,尝试在全屏画面上直接运行车牌检测存在两大致命缺陷:
- 复杂背景噪声吞噬特征:街边商店招牌上的文字、公交车身广告都会导致车牌检测器频繁误触发。
- 下采样特征严重丢失:当 640x480 的图像被下采样至模型输入尺寸(如 640x640)时,本就只有几十像素的微小车牌极易在卷积特征图中彻底湮灭。
为此,我们的两阶段分层设计先严格限制搜索空间:
# 第一阶段:先粗定位车辆主体边界框
vehicle_boxes = detect_vehicles_yolov3(frame, net=vehicle_net, conf_thresh=0.5)

for box in vehicle_boxes:
    x1, y1, x2, y2 = box
    # 裁剪车辆局部候选区域 (Vehicle ROI)
    vehicle_roi = frame[y1:y2, x1:x2]

    # 第二阶段:仅在车辆局部高分辨率区域内检测车牌
    plate_boxes = plate_model(vehicle_roi)
    for pbox in plate_boxes:
        px1, py1, px2, py2 = pbox
        # 映射恢复至全局绝对坐标系
        global_plate_box = [x1 + px1, y1 + py1, x1 + px2, y1 + py2]
2. 突破实时帧率瓶颈:引入 CSRT 目标跟踪器
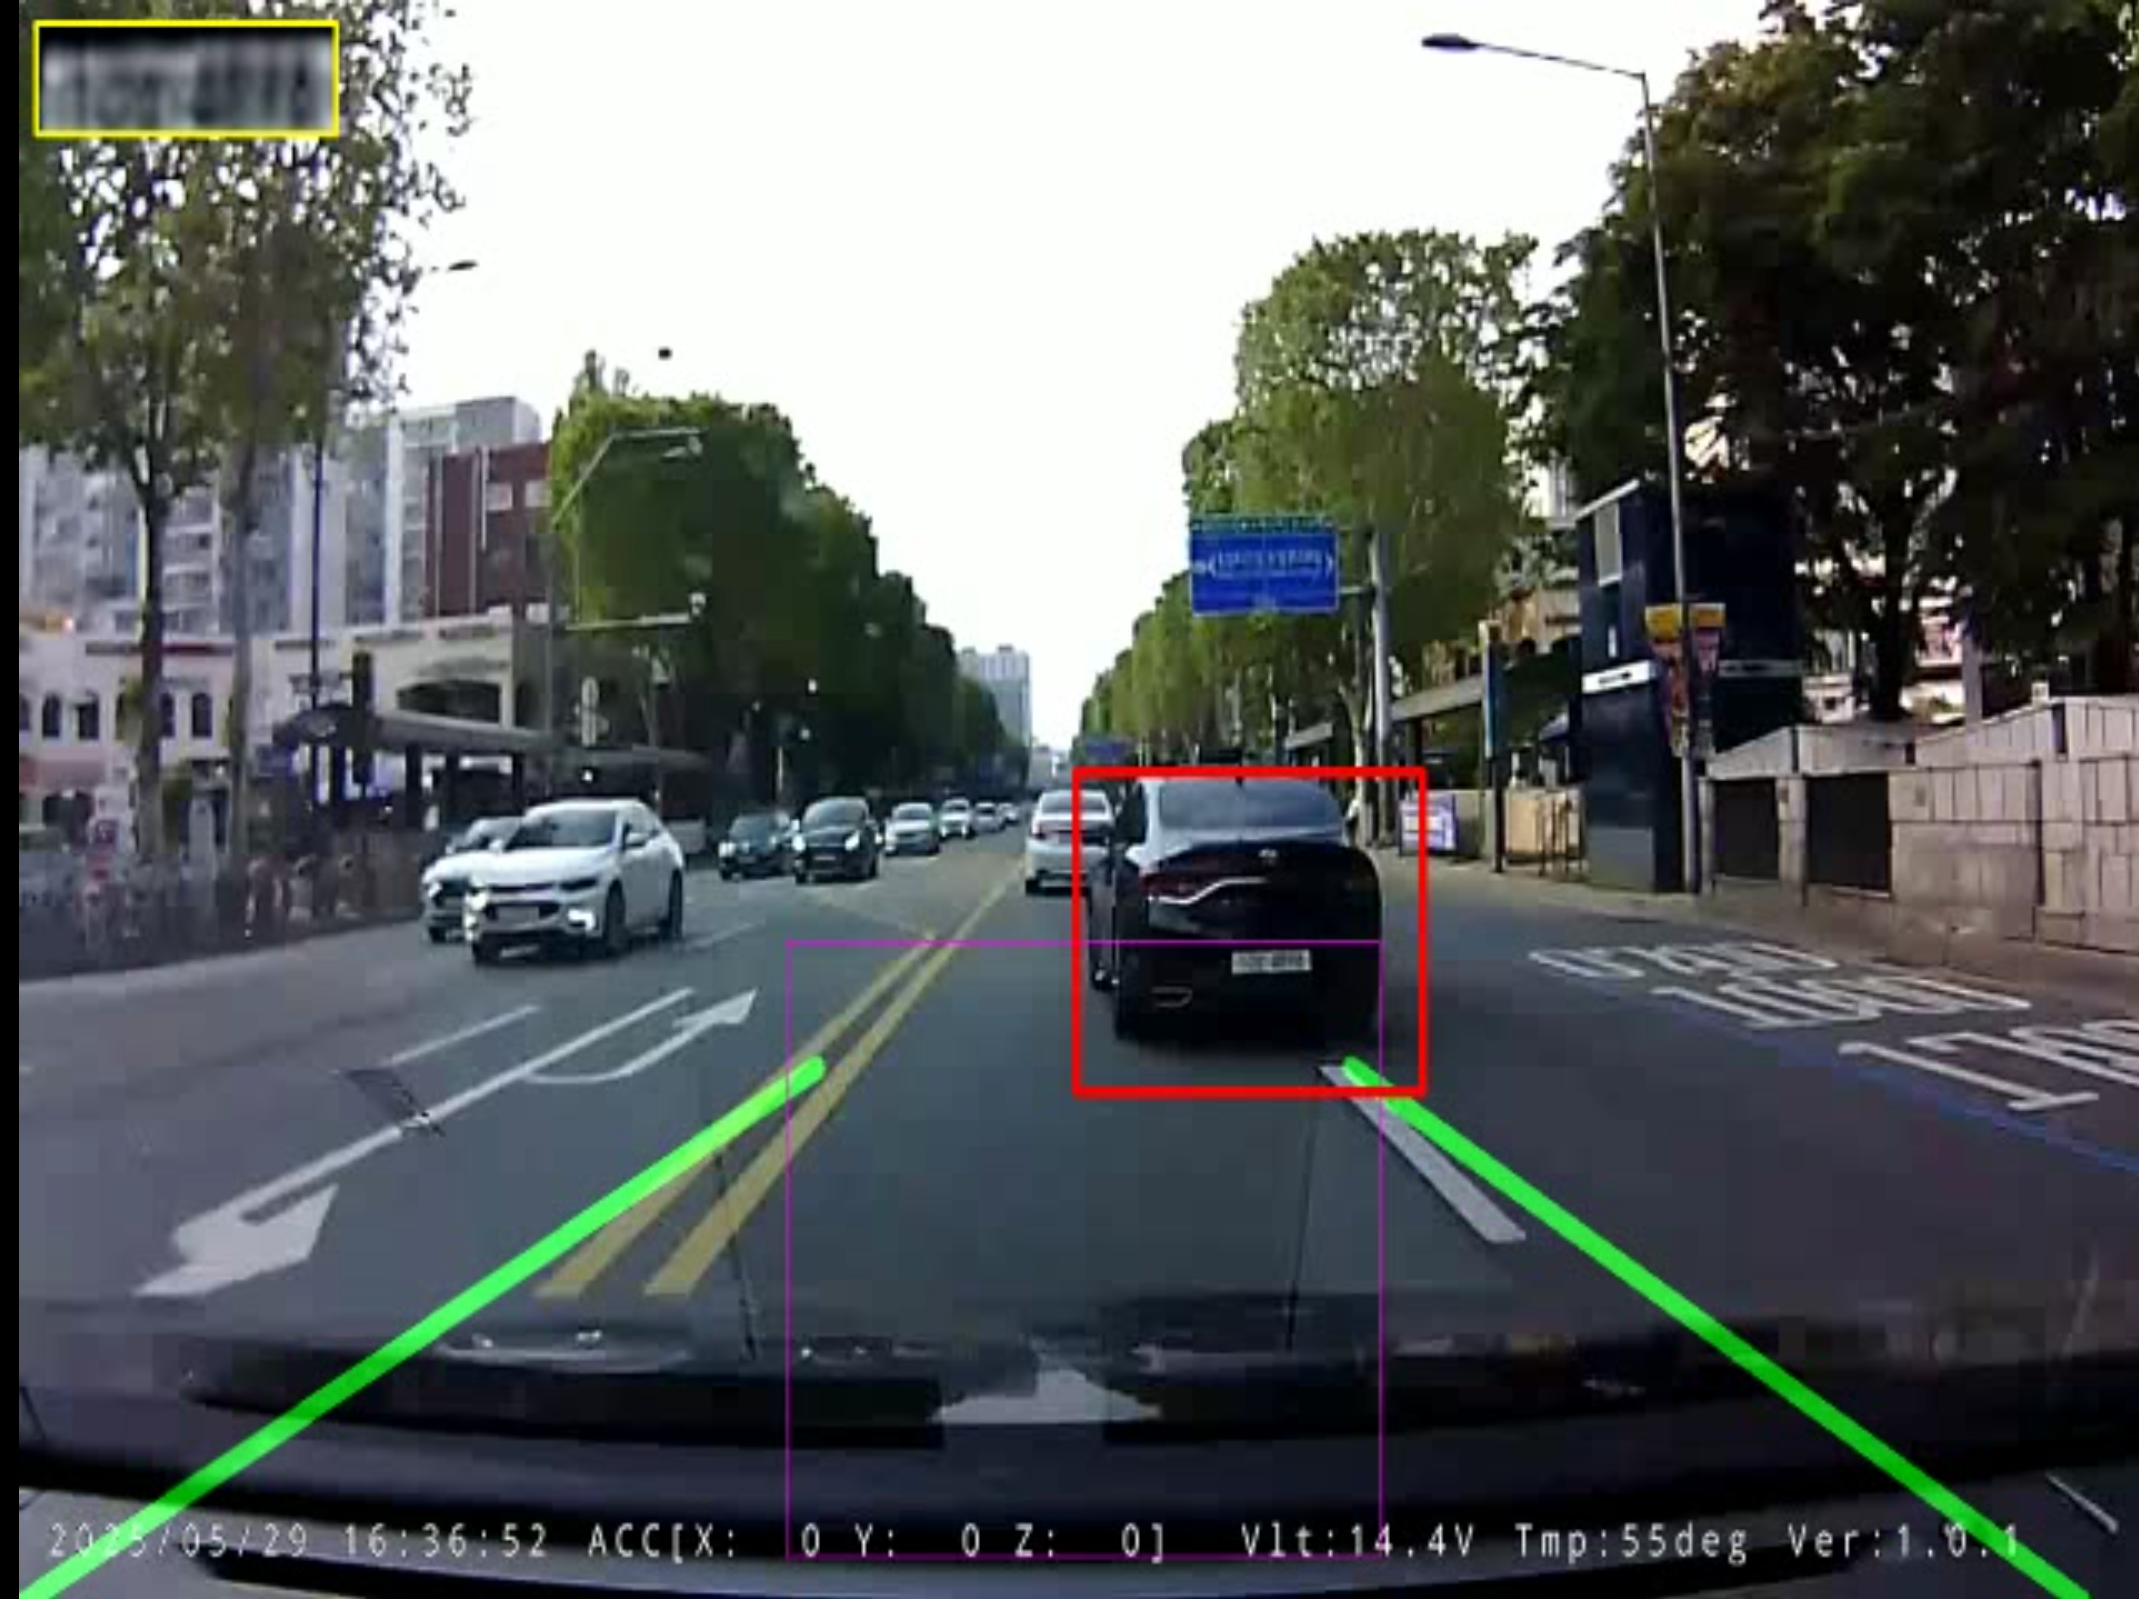
深度学习目标检测模型即便参数量再小,逐帧推断依然会过度挤占计算资源。我们引入了具有空间可靠性图的 CSRT (Channel and Spatial Reliability Tracking) 滤波跟踪器,采用“间隔检测 + 逐帧跟踪”的双核驱动机制:
# 每隔 15 帧执行一次 YOLO 重检,其余帧完全交由轻量级 CSRT 跟踪
if frame_count % CONFIG["detection_interval"] == 0:
    boxes = detect_vehicles_yolov3(frame)
    tracker = cv2.TrackerCSRT_create()
    tracker.init(frame, tuple(boxes[0]))
else:
    # 纯数学相关滤波快速更新目标框,单帧计算开销仅需 1~2 毫秒
    success, tracked_box = tracker.update(frame)
    if not success:
        tracker = None
3. 下篇预告
在接下来的第 4 篇中,我们将深入解决裁剪出的微小车牌分辨率过低且受严重运动模糊污染的挑战,探索基于 EDSR_x4 深度超分辨率算法 与 多帧图像叠加降噪 的字符边缘高保真重建实践。