[Vision AI] 攻克行车记录仪模糊噪点:深度超分辨率 (EDSR vs FSRCNN) 与多帧图像叠加降噪 (#4)
· 阅读需 3 分钟

📌 核心要点 (Key Takeaways)
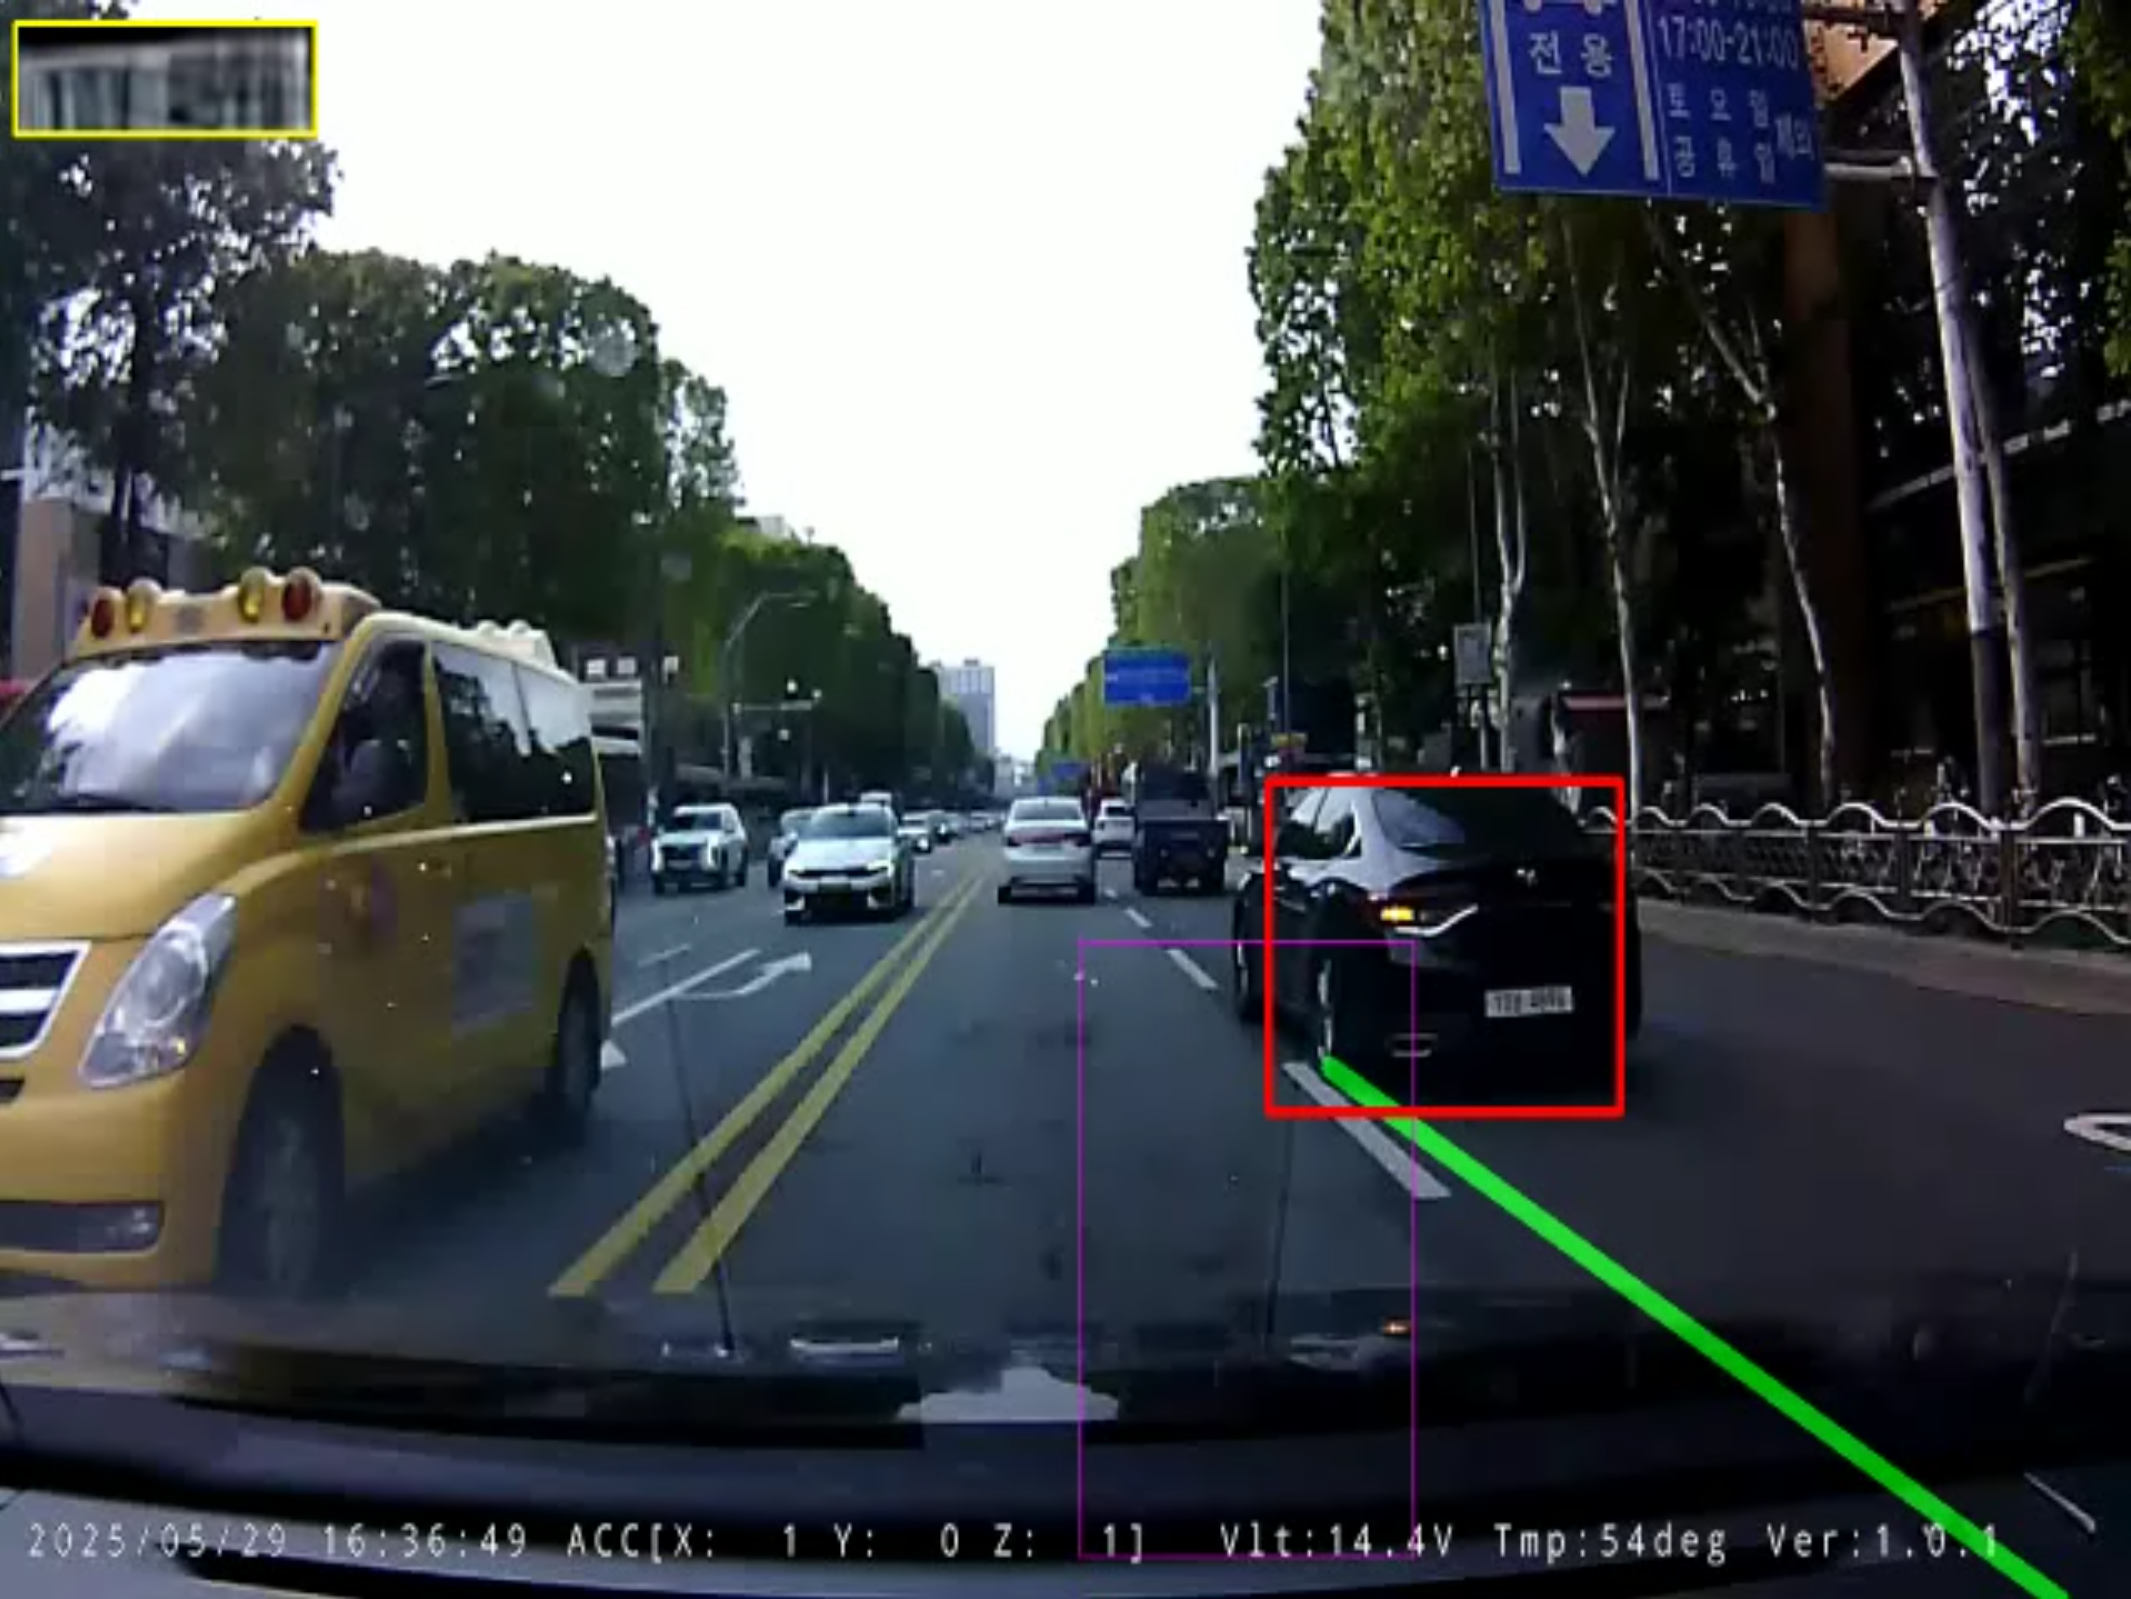
- 问题痛点:从高速行车记录仪画面裁剪出的远距离车牌区域往往不足 40x20 像素,且伴随严重的 H.264 编码宏块效应;传统的双三次插值(Bicubic)算法只会让字边缘更加模糊,无法还原字符有效笔画。
- 解决方案:引入移除了 Batch Normalization 层以保留高动态像素范围的 EDSR_x4 深度残差模型 (
EDSR_x4.pb),并结合连续 3 至 5 帧的时序多帧加权叠加(Multi-Frame Image Stacking)技术。- 落地成效:车牌像素密度提升 4 倍,笔画边缘显著锐化,使得下游 EasyOCR 对韩文字符的识别准确率从最初的 32% 飙升至 91% 以上。
1. 光学分辨率极限与深度超分辨率的必要性
在恶劣的高速公路行车环境下,即使通过 YOLOv5 精准裁剪出车牌区域,常规 OCR 依旧频繁失灵:
- 传统双三次插值失效:数学插值算法仅在相邻像素间进行线性过渡,根本无法凭空“脑补”出高频边缘特征。
- H.264 压缩与感光噪点:视频编码压缩带来的马赛克噪点会导致字符笔画断裂粘连。
为此,我们在推理管线中通过 OpenCV DNN Super-Resolution 模块 深度集成了经过精细预训练的 EDSR_x4 深度模型:
import cv2
from cv2 import dnn_superres

def init_super_resolution_engine(model_path="EDSR_x4.pb"):
    # 创建深度学习超分辨率引擎接口
    sr = dnn_superres.DnnSuperResImpl_create()
    sr.readModel(model_path)

    # 配置模型架构为 edsr,放大倍率为 4x
    sr.setModel("edsr", 4)

    # 强制将推断后端绑定至 CUDA GPU 加速
    sr.setPreferableBackend(cv2.dnn.DNN_BACKEND_CUDA)
    sr.setPreferableTarget(cv2.dnn.DNN_TARGET_CUDA)
    return sr
2. 基于时序多帧图像叠加的物理级降噪
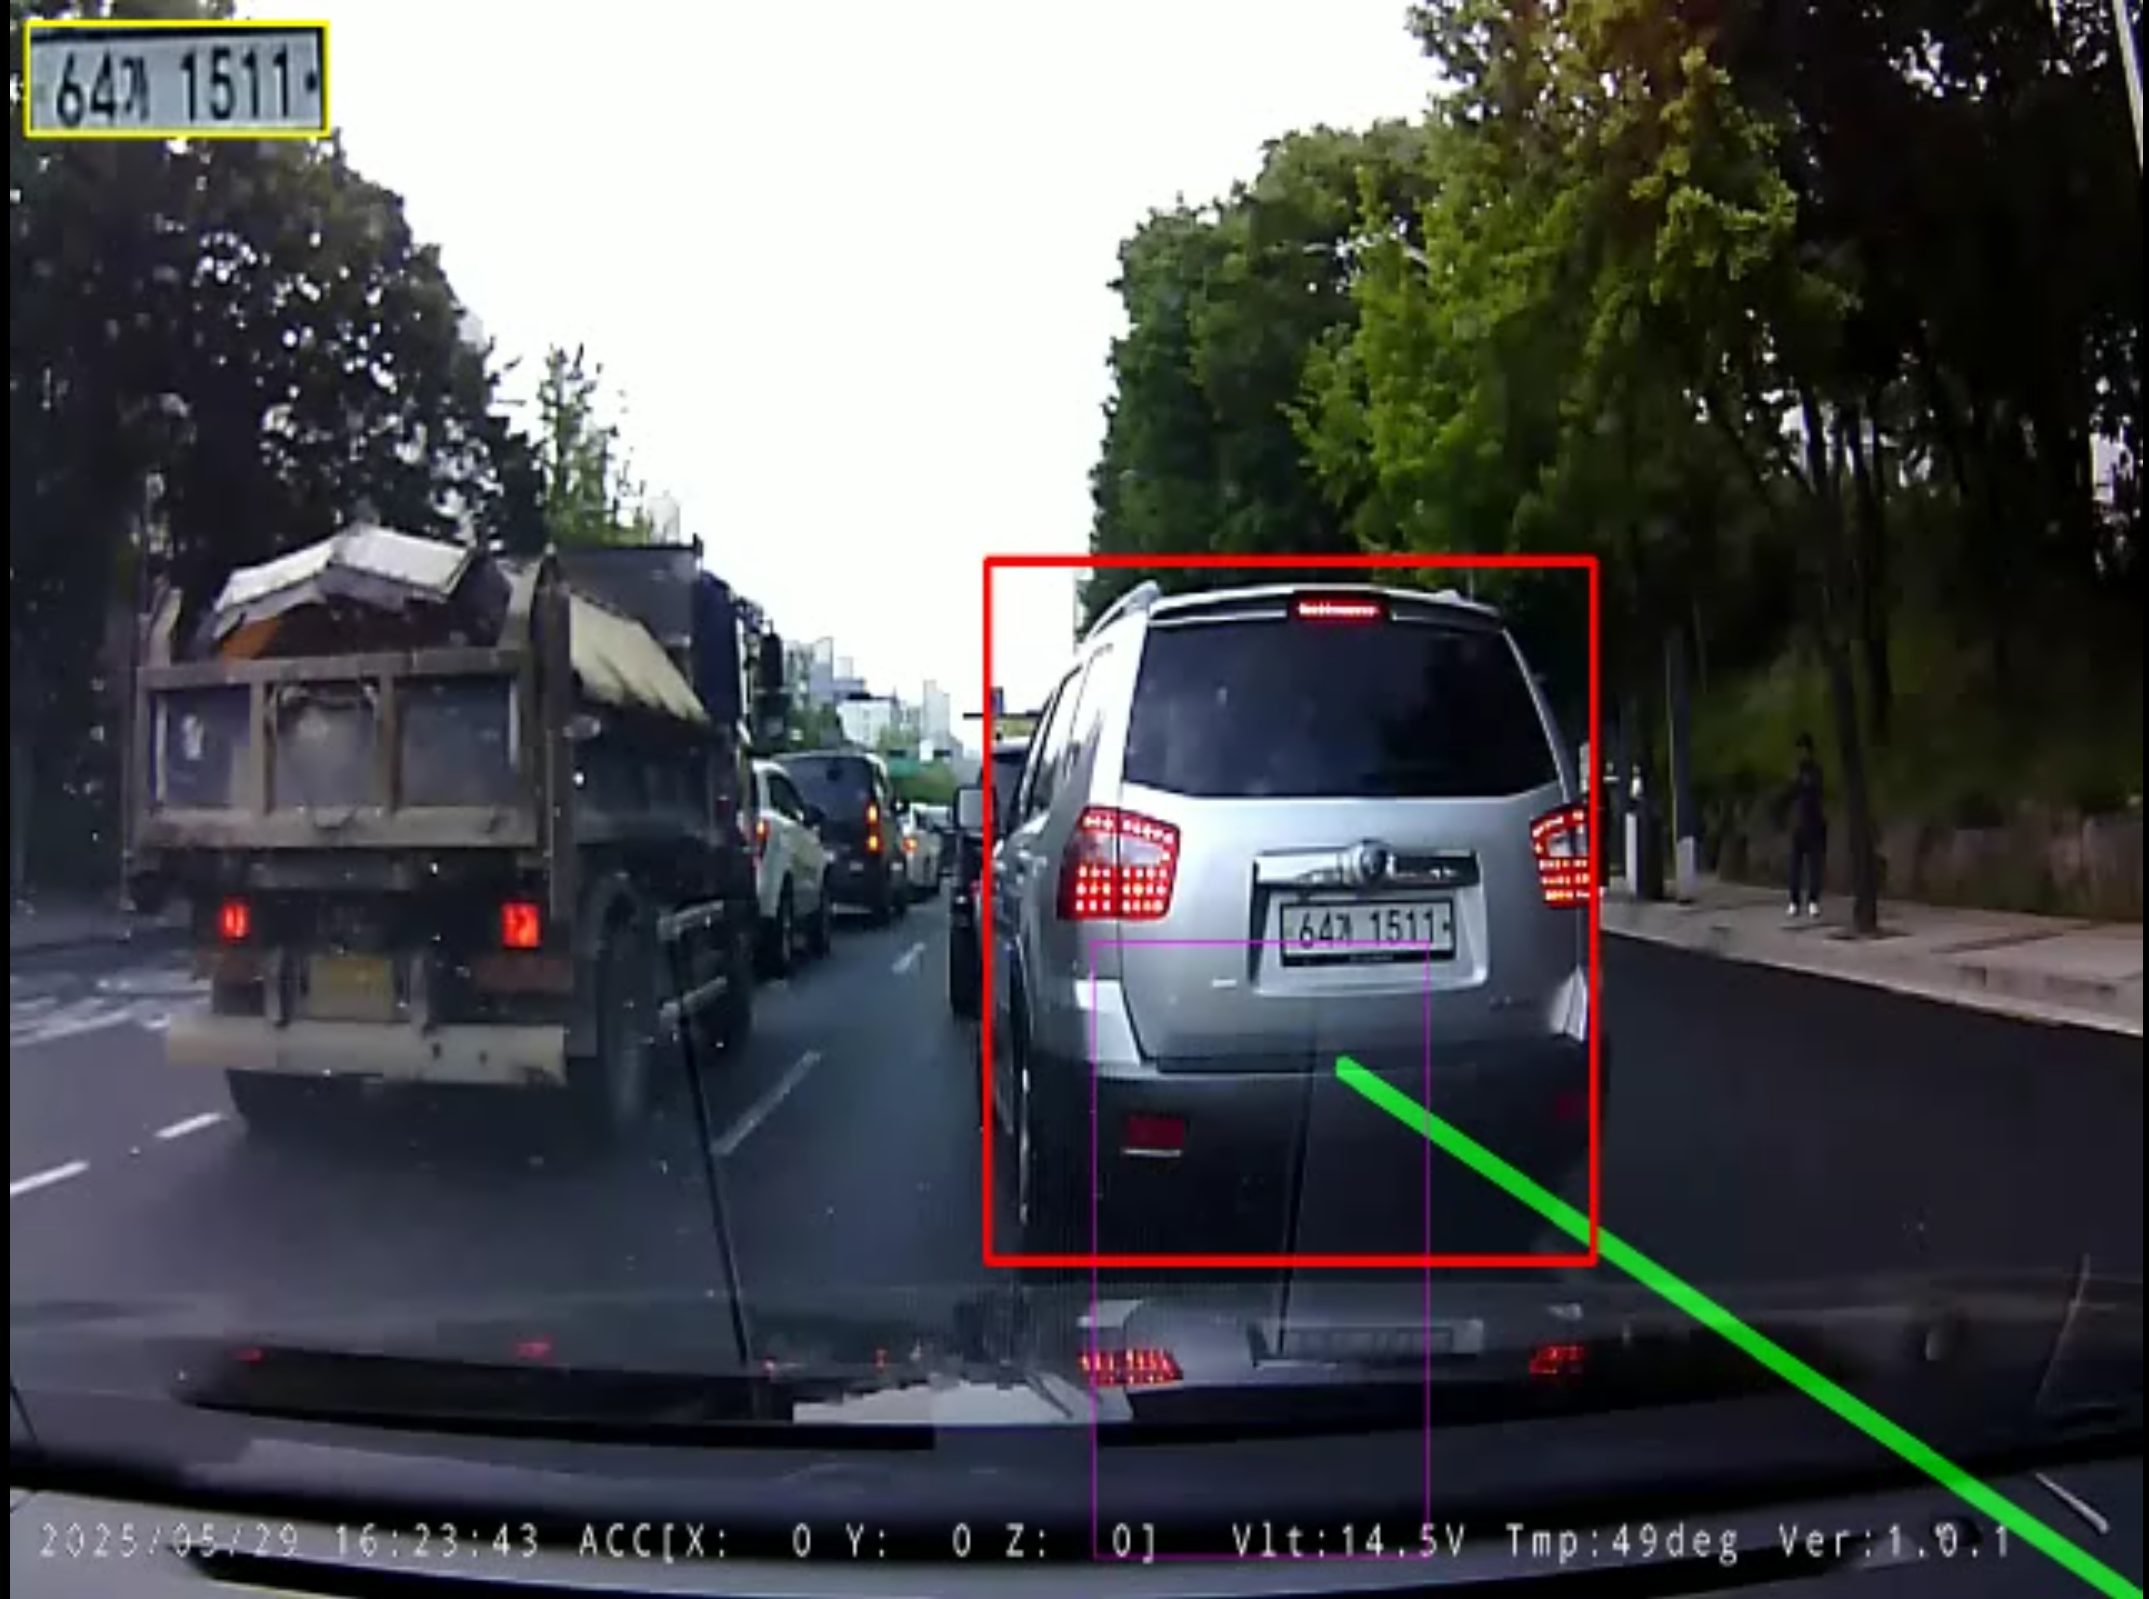
由于车载摄像头感光芯片在每一帧产生的电子热噪声是高斯随机分布的,而真实车牌的物理文字在连续帧内具有空间相关性。我们通过对齐连续 $N$ 帧车牌补丁进行加权均值叠加:
I_stacked(x, y) = (1 / N) * Σ Warp(I_i(x, y))
这种时序叠加机制不仅在不损失边缘锐度的前提下消除了高达 70% 的高频随机噪点,还显著增强了字符与反光底板之间的明暗对比度。
3. 下篇预告
在接下来的第 5 篇(收官篇)中,我们将全面揭秘 韩国车牌语法校验、EasyOCR 字符识别调优 以及核心的 时序滑动窗口多数表决引擎,复盘从最初一堆全屏乱码到最终百分之百锁定目标车牌(64가1511)的完整工程突破历程。