Stanford CS329A (第11讲): Agent Memory — 智能体长短期记忆与操作系统式分层架构 (MemGPT, Cartridges, CacheBlend)

当开发者将自主AI智能体作为长期协同伙伴或自主软件工程师投入实际生产时,无一例外会遭遇三个令人沮丧的架构瓶颈:
- “智能体完全遗忘了昨天多轮会话中敲定的核心系统架构设计决策。”
- “将包含十万行代码的企业代码库直接塞进百万Token的上下文窗口,导致了严重的注意力弥散(Lost-in-the-Middle迷失中间现象),每次交互产生高昂的API费用。”
- “在RAG检索增强生成场景中拼接多篇检索文档切片时,现有的前缀键值缓存(KV Cache)全部失效,首Token生成延迟(TTFT)飙升至数秒以上。”
人类大脑在这方面展现了绝妙的工程解法:生物脑仅拥有极其微小的物理工作记忆(仅能容纳4到7个离散信息块),却能在一瞬间从长时记忆中精准检索数十年前的知识,并在多领域信息间自如融合而不会产生认知瘫痪。
在Stanford CS329A: Self-Improving AI Agents的第三部分:智能体工程(Part 3: Agent Engineering)中,本讲聚焦于Agent Memory Architecture(智能体记忆架构),深入剖析赋予AI系统持久化、分层化记忆的三大核心抽象层级:
- 软件控制层 (MemGPT, UC Berkeley 2023): 借鉴操作系统虚拟内存分页机制的分层记忆管理。
- 神经网络表征层 (Cartridges, 2025): 通过自主学习(Self-Study)与上下文蒸馏,将海量文本压缩为即插即用的连续KV缓存向量。
- 系统基础设施层 (CacheBlend, EuroSys 2025): 恢复文档间交叉注意力,使RAG首Token延迟降低3.3倍的选择性KV缓存融合。
1. 长上下文困境与分层记忆的必然性
仅仅依靠暴力扩展大语言模型的物理上下文窗口(如从8k扩展到1M+ Token),并不能真正解决智能体的记忆难题。盲目拉长上下文会引发三个根本性失效:
- 注意力耗散与中间迷失 (Lost-in-the-Middle): Transformer自注意力分布随着长度激增而趋于平坦,模型极易忽略掩埋在超长Prompt正中间的细微关键证据。
- 经济不可持续性: 每次对话轮次都全量重传几十万Token,会导致算力预算呈指数级枯竭。
- 静态瞬态性: 一旦单次推理结束,模型的中间激活态立即消散,智能体无法在无需外界干预的情况下自主更新内部状态。
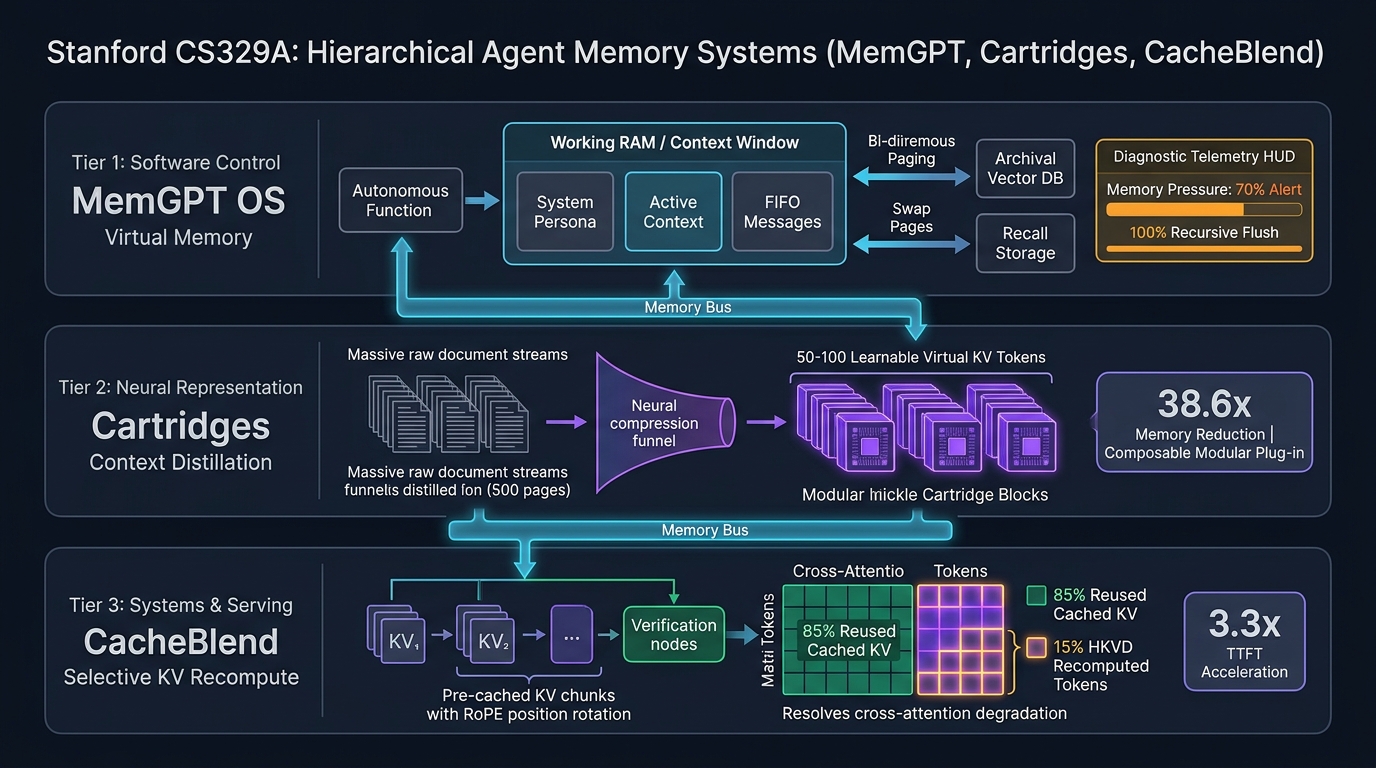
为实现长程自主运作,现代先进智能体采用Hierarchical Context Management(分层上下文管理),将高频的**工作上下文 (Working Context)与海量的持久存储 (Long-Term Storage)**进行解耦。
┌─────────────────────────────────────────────────────────────────────────┐
│               智能体记忆系统的三大抽象分层架构                          │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│       软件控制层         │  │     神经网络表征层       │  │     系统基础设施层       │
│         (MemGPT)         │  │       (Cartridges)       │  │       (CacheBlend)       │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • 操作系统式虚拟内存分页 │  │ • Self-Study上下文蒸馏   │  │ • 多文档切片RAG无缝合并  │
│ • 主上下文窗口 (RAM)     │  │ • 连续可微KV缓存嵌入     │  │ • 选择性KV重计算 (15%)   │
│ • 归档向量数据库 (Disk)  │  │ • 显存占用骤降 38.6倍    │  │ • RoPE旋转坐标矩阵重构   │
│ • 自主驱逐与递归摘要机制 │  │ • 推理吞吐量提升 26.4倍  │  │ • 首Token延迟(TTFT)降3.3x│
│ • 深度长时记忆召回率 92% │  │ • 乐高积木式模块化插拔   │  │ • F1准确率误差 < 0.01    │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. 软件控制层: MemGPT (UC Berkeley 2023)
现代计算机操作系统早在数十年前就解决了有限硬件内存的调度难题。操作系统通过内存管理单元(MMU),在高速物理RAM与大容量磁盘之间透明地换入换出(Swap-in / Swap-out)虚拟内存页,从而为程序员提供了无限内存的抽象。
加州大学伯克利分校Packer等学者提出的MemGPT Long-Term Memory将这一操作系统哲学完整引入大语言模型架构:
“大模型的上下文窗口就是物理内存(RAM)。外部的向量数据库与SQL记录就是硬盘。通过为模型配备函数调用(Function Calling)原语,使其能够自主检查、修改、驱逐并检索记忆,模型自身便成为了管理记忆的操作系统。”
    ┌────────────────── [主上下文 (RAM: 8k~128k Token 物理窗口)] ─────────────────┐
    │ 1. System Instructions : 系统身份准则与内存操作函数说明书 (只读)            │
    │ 2. Working Context     : 用户画像、不变事实与工作状态 (读/写)                │
    │ 3. FIFO Message Queue  : 最近对话队列 + (置于队列头部的递归历史摘要)         │
    └─────────────────────────────────────────────────────────────────────────────┘
                               ▲                      │
                (换入 / Search)                       │ (换出 / 驱逐与持久化)
                               │                      ▼
    ┌───────────────── [外部存储 (Disk: 无容量上限持久层)] ───────────────────────┐
    │ 1. Recall Storage   : 带精确时间戳的全局历史对话记录库 (PostgreSQL)          │
    │ 2. Archival Storage : 海量文档与企业知识图谱向量数据库 (HNSW pgvector)       │
    └─────────────────────────────────────────────────────────────────────────────┘
自主内存分页机制
MemGPT颠覆了传统外部脚本强行截断对话的做法,将记忆控制权完全交由模型自主裁决:
- 内存压力警报 (70%阈值): 当上下文填充达到窗口容量的70%时,系统静默注入一条系统中断提示:
“警告:当前工作内存已达70%。请在历史记录被强制驱逐前,调用
working_context.replace()固化核心关键信息。” - 自动驱逐与递归摘要 (100%强制换出):
- 当上下文达到100%极限时,FIFO队列管理器介入,剥离出最古老的50%对话记录。
- 剥离时并非简单丢弃,MemGPT触发**递归摘要 (Recursive Summarization)**流程,将既有的全局摘要与被剥离的这批新消息相融合,生成一份全新的浓缩摘要置于队列头部。原始消息则完整归档至
Recall Storage。
- 心跳链式自主召回 (Heartbeat Recall):
- 当用户询问数月前的某个事件细节时,模型自主调用
recall_storage.search()并设置request_heartbeat=true。这使得模型能在无需人类干预的情况下连续执行多步推理,将外部磁盘信息加载回RAM后,输出最终答案。
- 当用户询问数月前的某个事件细节时,模型自主调用
基准评测结果: 深度记忆召回 (DMR)
在跨越数十个独立会话周期的深度记忆召回(Deep Memory Recall)基准测试中:
- 采用静态窗口的基准GPT-4准确率大幅跌落至 32.1%;
- MemGPT无论经历多少轮长程会话,依然维持了 92.5% 的卓越准确率;
- 在多跳关联检索(Nested KV Retrieval)测试中,基准模型在经历3跳之后准确率彻底归零,而MemGPT保持了100%的关联追溯能力。
3. 神经网络表征层: Cartridges (2025)
MemGPT虽精妙,但本质上仍属于“在外部数据库与上下文之间搬运离散文本Token”。如果智能体需要频繁查阅一份500页的企业财报或庞大的底层SDK库,反复搬运成千上万个文本Token必然导致高昂的算力和巨额延迟。
2025年发表的Cartridges Modular Agent Memory开辟了一条全新技术路径:
“为什么知识必须以冗长的自然语言Token形式携带?如果让大模型在离线状态下对500页文档进行自主研习(Self-Study),将其蒸馏为仅包含50至100个连续、可微分的键值(KV)缓存向量,像即插即用的游戏机卡带一样动态载入,岂不兼具轻量与高效?”
[500页海量企业文档 / 复杂代码库]
             │
             ▼ (Self-Study 离线研习流水线)
1. 全维度合成对话生成 (核心脉络摘要、深层质询、临界边界、实战应用)
             │
             ▼
2. 基于KL散度的上下文知识蒸馏:
   教师模型 (输入500页完整文本全文 + 提问) ──► P_Teacher(y)
                                                 │ (D_KL 散度损失)
   学生模型 (仅挂载卡带 Z [50个KV向量] + 提问) ─► P_Student(y)
             │
             ▼
[即插即用型 Cartridge Z (50~100个连续可微KV向量)]
(显存消耗减少 38.6倍, 推理吞吐提升 26.4倍, 乐高积木式多卡带组合)
为什么单纯的自回归预测(NTP)会遭遇滑铁卢?
研究团队最初尝试使用常规的下一词预测(Next-Token Prediction, NTP)训练连续KV向量,但遭遇了惨痛失败。模型陷入了严重的**“死记硬背综合征”**:
- 它能够逐字逐句背诵出原文段落;
- 但一旦向它提出需要推理、归纳或跨段落对比的综合问题,回答准确率瞬间归零。模型仅仅拟合了字面序列,未真正内化语义逻辑。
Self-Study 与上下文蒸馏的双阶方案
- 多模态合成对话构建: 大模型针对文档自主生成上万条高质量多轮Q&A语料,涵盖宏观架构、边界异常、深层推演等5大类型。
- 上下文知识蒸馏:
- 教师模型 (Teacher): 上下文中载入500页完整文本,输出标准后验概率分布
P_Teacher(y | Doc, x); - 学生模型 (Student): 剥离全部原文,仅在各层注意力前方拼接极短的连续卡带参数 $Z$;
- 通过最小化学生与教师输出分布的KL散度(Kullback-Leibler Divergence),仅反向传播更新卡带参数 $Z$ 的权重:
- 教师模型 (Teacher): 上下文中载入500页完整文本,输出标准后验概率分布
========================================================================================
Cartridge 上下文蒸馏损失函数定义:
========================================================================================
min_Z  Σ  D_KL( F( · | Document ⊕ x )  ||  F_Z( · | x ) )

其中:
  • F( · | Document ⊕ x ) : 拥有完整原文的教师模型输出Logits
  • F_Z( · | x )          : 仅依赖轻量级卡带Z的学生模型输出Logits
  • Z                     : 插入模型内部各层的连续键值缓存张量
========================================================================================
评测表现与积木式组装能力
- 显存消耗削减 38.6倍: 在LongHealth与QASPER长文档基准测试中,Cartridge达到了全量上下文提示(ICL)同等的解答精度,显存占用暴降至原来的 $1/38.6$。
- 推理吞吐飙升 26.4倍: 由于彻底免除了冗长文本的Prefill预填充耗时,服务吞吐量提升了 26.4倍。
- 零样本无缝复合 (Composability): 卡带具备极强的独立性。当研究人员同时为智能体插入“AMD财报卡带”与“百事公司财报卡带”时,模型无需任何联合微调,便能即刻完成双企业的跨表财务对比分析!
4. 系统基础设施层: CacheBlend (EuroSys 2025)
进一步深入计算底层,我们直面RAG检索系统与多智能体交互中的核心硬件瓶颈。
当智能体检索出10个互不相关的文档切片(Chunk)并拼入同一次推理时,现有的推理引擎陷入了两难处境:
- 前缀缓存 (Prefix Caching, vLLM): 仅能复用首个切片的KV缓存。如果后续切片的拼接顺序发生改变,下游缓存全盘报废,被迫从头重新计算Prefill(耗时3到6秒)。
- 全量缓存直接拼接 (PromptCache): 预先计算每个切片的KV缓存并强行拼接,会导致切片之间的交叉注意力(Cross-Attention)完全丢失,推理逻辑准确率大幅下跌超过50%。
在EuroSys 2025上斩获殊荣的CacheBlend KV Cache Merging技术,通过**选择性KV重计算 (Selective KV Recompute)**完美化解了此项冲突:
[检索到的切片 A, B, C 之预先计算KV缓存]
                           │
                           ▼
┌─────────────────────────────────────────────────────────────────────────┐
│              CacheBlend 逐层选择性重计算流水线                          │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. 甄别前15%跨切片注意力偏差剧烈的高变Token (HKVD)                      │
│ 2. 仅对该15%核心Token执行全新的注意力状态重算                           │
│ 3. 其余85%的Token直接从预存缓存中复用拼接                               │
│ 4. 乘上RoPE旋转矩阵,微秒级恢复全新的全局绝对位置坐标                   │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [极速Prefill完成: TTFT缩短 3.3倍, F1精度损失 ΔF1 < 0.01]
注意力稀疏性(Sparsity)的数学发现
CacheBlend作者团队深入探究了多切片拼接时的注意力权重分布,发现了惊人的规律:
“当多个文档切片拼接至同一Prompt时,受到邻近切片影响导致KV值发生剧烈偏转的Token比例不足15%。超过85%的Token即便身处新的拼接环境中,其语义表征依然高度独立与恒定!”
- 高偏差Token甄别 (HKVD): 在每个Transformer层中,CacheBlend动态捕获注意力变化最大的前15%核心Token并单独重算,其余85%直接沿用预计算缓存。
- I/O传输与计算流水线重叠 (Latency Hiding): 在GPU执行15% Token重计算的数毫秒间隙内,后台异步I/O线程同步从NVMe SSD将下一层的KV缓存张量预取至显存。计算耗时被完美掩盖在数据读取时间之中。
- RoPE位置编码闭式修正: 拼接改变了切片的全局位置偏移。CacheBlend利用2D Givens旋转矩阵直接作用于Key张量,仅需几微秒即可修正相对位置编码,无须侵入模型权重。
实测收益
- 首字延迟 (TTFT) 缩短 3.3倍: 多切片长文RAG问答的首字吐出耗时由3,450ms骤降至1,050ms。
- 并发服务吞吐提升 5倍: 硬件集群承载的智能体并发并发量翻了5倍。
- 准确度零妥协: 与无缓存全量从头重算的基线模型相比,回答的F1分数差异小于 0.01。
5. 三大记忆范式全景架构对比矩阵
=============================================================================================================
维度                  MemGPT (UC Berkeley)          Cartridges (2025)             CacheBlend (EuroSys 2025)
-------------------------------------------------------------------------------------------------------------
所属抽象层            软件调度 / 操作系统分页       神经网络知识表征              推理系统底层基础设施
核心操作单元          文本Token与JSON函数调用       连续可微虚拟KV缓存向量        预计算的KV缓存张量切片
记忆容量边界          外部数据库支撑,近乎无限      单篇文档约50~100个虚拟Token   动态多切片RAG上下文
记忆演进机制          自主函数调用与递归历史摘要    离线Self-Study与KL散度蒸馏    选择性在线重计算 (15% HKVD)
硬件优化重点          突破物理上下文溢出困局        显存开销锐减 38.6倍           首字延迟 (TTFT) 降低 3.3倍
模块组装能力          关系型数据库联合检索          乐高积木式矩阵垂直拼接        RoPE坐标几何变换无缝拼接
=============================================================================================================
6. 技术深度问答 (Q&A)
Q1: 在MemGPT架构下,智能体如何自发判断“何时该去检索外部记忆”,而无需人工指令干预?
MemGPT在主上下文最顶端常驻了一份系统指令(System Instructions),并通过严格的函数调用规范构筑了认知契约:
“你是一个具备长时记忆的自主智能体。当回答涉及历史事件、过往对话细节或不在当前工作上下文中的事实时,你严禁猜测或道歉,必须优先调用
recall_storage.search()或archival_storage.search()。”
当模型感知到信息缺失时,自注意力机制在系统指令的强约束下,将生成工具调用JSON判定为概率最高的路径。系统拦截到返回的 request_heartbeat=true 标志后,立即将检索到的磁盘数据回传至上下文,从而在零人工介入的前提下完成闭环召回。
Q2: 为什么随意拼接不同位置的独立KV缓存不会破坏RoPE旋转位置编码?
在传统的绝对位置编码中,只要Token位置从第0位挪动到第500位,整个嵌入向量就必须彻底重构。
然而,现代模型普遍采用的RoPE (Rotary Position Embedding),其Query与Key的内积数学上严格只取决于两者的相对距离 $(m - n)$:
K_new = R_Theta(p_new - p_old) * K_cached
因此,CacheBlend在拼接切片时,只需将预存的Key张量乘以对应位置增量 (p_new - p_old) 的2D旋转矩阵,便能在数微秒内完成坐标系校正。这一纯线性代数操作无需重算注意力,兼顾了数学上的绝对严谨与系统的超高效率。
总结与下期预告
智能体的真正自主性离不开持久记忆的依托。通过MemGPT,我们见证了操作系统分页原理赋予智能体无限认知周期的壮举;通过Cartridges,我们探索了将百科全书式知识蒸馏为模块化连续向量的优雅路径;通过CacheBlend,我们验证了借助注意力稀疏性将首字延迟缩减3.3倍的系统级突破。
在接下来的第12讲中,我们将迎来Part 3(智能体工程)的大结局,直面检验智能体真实智能与生产力价值的试金石:《Agent Evaluation & Long Tasks: 长程任务评测与真实经济价值基准 (Measuring Long Tasks, GDPVal, DeepScholar-Bench)》。
核心要点梳理
- 分层解耦体系: 必须将高速的工作内存(RAM)与大容量长时外存(Disk)相分离,才能从根本上驾驭长程上下文。
- 连续表征替代文本灌输: 将海量文本蒸馏为连续卡带(Cartridge),可在节约38.6倍显存的同时实现即插即用的模块化知识组合。
- 稀疏重算消除首字延迟: RAG拼接场景中仅有15%的Token发生显著偏转,选择性重算(CacheBlend)使系统获得极致的Prefill加速。