Stanford CS329A (第12讲): Agent Evaluation & Long Tasks — METR时间地平线, OpenAI GDPval与DeepScholar-Bench

当工程团队构建出一套自主编程智能体向企业管理层或投资人汇报时,单方面宣称“该模型在MMLU选择题中取得了92分”往往得不到实质性的商业共鸣。现实商业战场抛出的质询远比选择题冷酷而具体:
- “这个自主智能体在没有人类介入纠错的前提下,究竟能否独立搞定需要耗时数小时的端到端复杂工程任务?”
- “人类资深工程师需要花费8小时完成的底层微服务重构或深度财务估值模型,这个智能体能否给出媲美人类的质量?其带来的净经济价值究竟是多少美元?”
传统的静态客观题基准(MMLU, GSM8K, HumanEval)早已普遍超过90分而步入饱和(Saturation),并因互联网训练数据污染(Contamination)沦为死记硬背的作秀。更本质的是,回答耗时5秒的单选题,与在数小时内连续执行数百步具备状态依赖的决策——即长程智能体任务 (Long-Horizon Agent Tasks)——存在着维度上的根本鸿沟。
作为Stanford CS329A: Self-Improving AI Agents的第三部分:智能体工程(Part 3: Agent Engineering)的大结局,本讲深入探讨现代Agent Evaluation Benchmarks(智能体评估基准)的核心前沿——不再以虚浮的百分比论英雄,而是以**人类时间 (Human Time)和经济美元 ($)**作为衡量智能的物理基准:
- 人类时间地平线标定 (METR, 2025): 50%成功率时间地平线 (h_agent) 与每7个月翻番定律。
- 真实经济价值量化 (OpenAI GDPval, 2025): 覆盖美国GDP 9大产业44个数字岗位的双盲评测与“试错修复(Try-n-then-fix)”时间成本经济学。
- 杜绝数据污染的实时学术研究评测 (DeepScholar-Bench, 2025): 3维度7指标体系与LLM裁判(Judge)的位置偏见消除算法。
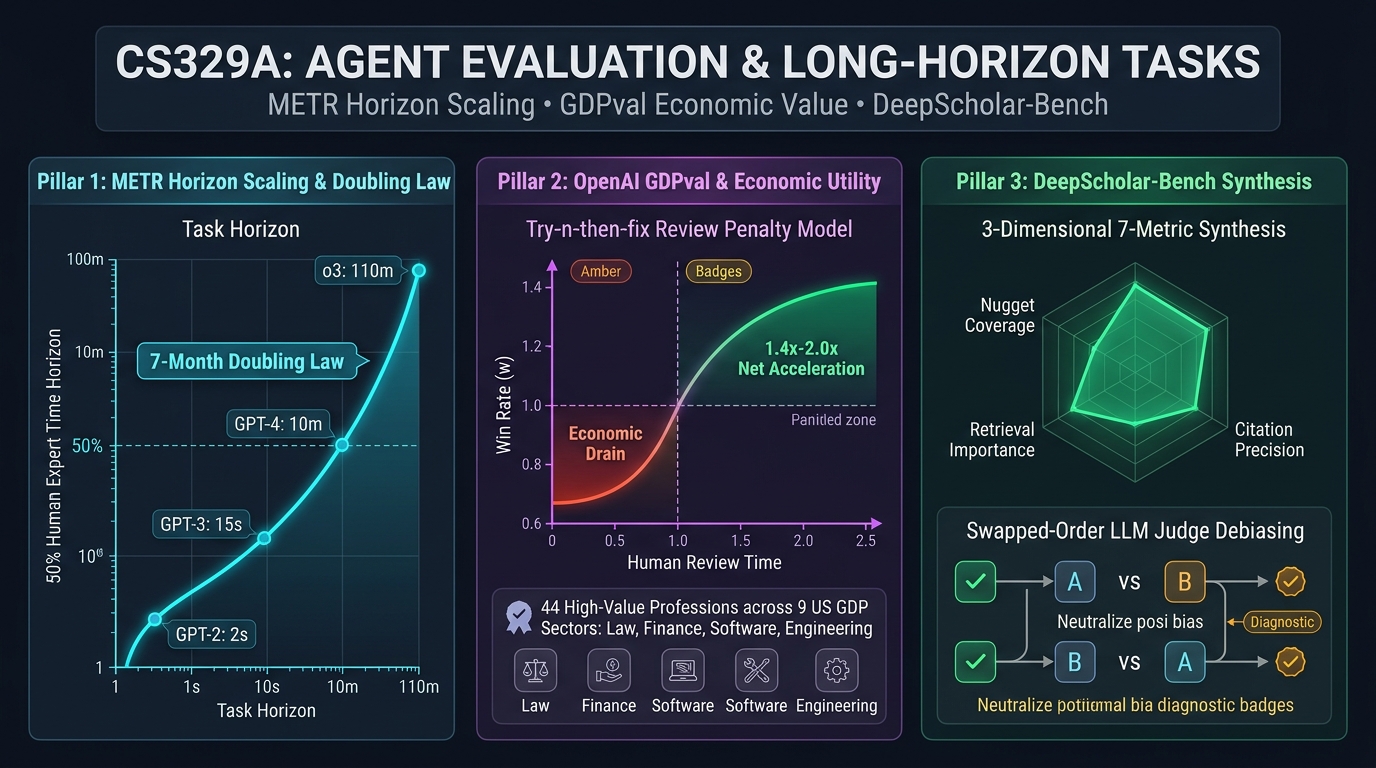
1. 评估的危机:客观选择题的破产与实战任务的本质
过去五年间,AI学界高度依赖静态的问答数据集。然而在将智能体投入产业实战的过程中,这种评测机制暴露出三大致命结构性缺陷:
- 饱和与污染: 前沿大模型在MMLU上纷纷突破90分,但背后充斥着在海量预训练中无意识爬取并记诵测试题的虚假繁荣。
- 缺乏时间地平线: 单道选择题只需2秒、1步推理即可得出。而真实的软件工程研发要求模型在数小时内维持严密的内部状态,连续执行上百次有状态的工具调用。
- 缺乏“现实的泥泞度 (Task Messiness)”: 考试题目总被封装得格式严谨、语义无歧义。然而真实工业环境充斥着动态波动的网络状态、难以逆转的破坏性指令风险以及语焉不详的报错日志。
因此,全球前沿AI机构全面摒弃了选择题模式,转向以物理时间与真金白银为轴线的连续型评测。
┌─────────────────────────────────────────────────────────────────────────┐
│               现代自主智能体评测的三大核心支柱                          │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│     METR 时间地平线      │  │    OpenAI GDPval ($)     │  │    DeepScholar-Bench     │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • 衡量标尺: 人类时间 t   │  │ • 衡量标尺: 真实美元价值 │  │ • 衡量标尺: 3维7项指标   │
│ • 50% 成功地平线 h_agent │  │ • 44个高薪数字化岗位     │  │ • 每周同步arXiv最新论文  │
│ • 每7个月翻一番倍增定律  │  │ • Try-n-then-fix 经济学  │  │ • 杜绝数据污染 0%        │
│ • 任务泥泞度 (Messiness) │  │ • 14年资深专家双盲裁判   │  │ • 关键信息元覆盖率 (39%) │
│ • 2秒 (GPT-2) -> 110分(o3)│ │ • 胜率40% 经济盈亏临界线 │  │ • 交换顺序消除裁判偏见   │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. 以人类时间衡量智能:METR (2025)
宣称“某模型在测试集中得到88分”无法为工程落地提供任何时间尺度上的预期。前沿AI评估实验室**METR (Model Evaluation and Threat Research)**给出了极具穿透力的解决方案:
“抛弃百分制。转而测量当一项任务需要经验丰富的人类专家花费时间 $t$ 才能完成时,AI智能体能够以多大几率成功搞定。并将AI能够以50%概率攻克的人类任务时长(
h_agent),直接定义为该模型的智能水平标尺!”
    [170套复杂软件/机器学习综合任务 (耗时从数秒跨越至8小时)]
                               │
                ┌──────────────┴──────────────┐
                ▼                             ▼
       [人类专家基准耗时 t]           [AI智能体实际通过率 p]
                │                             │
                └──────────────┬──────────────┘
                               ▼
        [基于项目反应理论 (IRT) 的逻辑回归拟合曲线]
           p = σ( (log h_agent - log t_task) × β_agent )
                               │
                               ▼
    [各模型50%时间地平线 h_agent: GPT-2 (2秒) ──► OpenAI o3 (110分钟)]
时间地平线逻辑回归公式
METR借鉴心理计量学中的项目反应理论(IRT),将智能体的成功概率 $p$ 建模为人类基准耗时 t_task 与模型时间地平线 h_agent 的逻辑函数:
========================================================================================
METR 时间地平线成功概率建模公式:
========================================================================================
p_success(agent, task) = σ( (ln(h_agent) - ln(t_task)) * β_agent )

其中:
  • t_task  : 经验丰富的人类专家完成该任务所需的平均耗时
  • h_agent : 该智能体的50%成功时间地平线 (当 t_task = h_agent 时,p = 0.5)
  • β_agent : 斜率参数,反映随着任务耗时延长成功率衰减的陡峭程度
  • σ(z)    : 标准Logistic Sigmoid函数 1 / (1 + exp(-z))
========================================================================================
每7个月翻番定律 (The 7-Month Doubling Law)
在对2019年至2025年间发布的16款前沿大模型进行系统评测后,浮现出一条惊人严格的指数级定律:
- 2019年 (GPT-2): 时间地平线仅为 2秒(简单的词句自动续写)。
- 2021年 (GPT-3): 时间地平线为 15秒。
- 2023年 (GPT-4): 时间地平线为 10分钟。
- 2025年 (OpenAI o3): 时间地平线达 110分钟(近2小时)。
- 统计回归结论: 前沿AI的50%成功时间地平线精确地以每7个月(207天)翻一番的速度暴增!
- 宏观推演: 保持该历史增长斜率,在2028年至2030年间,前沿AI智能体将以50%的概率,单枪匹马完成需要人类专家耗费整整一个月(160工作小时)的特大型软件研发工程。
3. 衡量真实经济价值:OpenAI GDPval (2025)
如果说METR校准了时间,那么OpenAI在2025年秋季发布的GDPval则直接锚定了真金白银的商业资本。
OpenAI锁定了对美国国内生产总值(GDP)贡献最大的9大核心支柱产业(金融、法律、软件、制造、医疗行政等),遴选出44个高薪数字专业工种。他们聘请了平均拥有14年行业资深实战经验的专家,构建了220套源自真实业务场景的黄金任务(如构建现金流折现估值模型、撰写专利侵权抗辩书、开发Python数据清洗流水线等):
- 任务平均人类耗时:9.5小时(中位数5.0小时)。
- 任务平均市场外包价值:398美元(约合人民币2,800元)。
资深专家双盲胜率 (Win Rate) 的真相
由14年资深行业专家对模型提交的成果与人类同行提交的成果进行严格双盲评审:
- GPT-4o: 双盲胜率仅为 12.5%(远未达到工业交付门槛)。
- OpenAI o3: 双盲胜率跃升至 35.2%。
- Claude Opus 4.1: 双盲胜率达到 47.6% (胜出或打平)!
- 顶尖推理模型生成的成果,在专业评审眼中已有近半数达到或超越了人类专家的专业交付水平。
“速度快300倍”的营销谎言与试错修复经济学
许多宣传常声称:“人类做9小时的任务AI只需2分钟,提速270倍!” GDPval通过建立**试错修复(Try-n-then-fix)**经济学公式,无情揭穿了这一表面假象:
========================================================================================
现实业务综合耗时期望公式 (Try-n-then-fix Model):
========================================================================================
E[T_real] = (M_T + R_T) * [ (1 - (1 - w)^n) / w ] + (1 - w)^n * H_T

其中:
  • M_T : 模型生成成果耗时 (通常为数分钟)
  • R_T : 人类专家仔细审查并审计模型成果所需的时间
  • H_T : 当成果彻底不可用时,人类专家放弃并从零重做所需的基准时间
  • w   : 模型的双盲胜率 (即成果合格可用的概率)
  • n   : 人类专家在放弃并亲自接管前,允许模型重新尝试的最大轮数
========================================================================================
经济盈亏平衡点:从累赘到净生产力
- 当模型胜率较低时(如GPT-4o, $w=12.5%$):人类专家不得不花费大量时间审查模型微妙的幻觉,最终因不满质量只能亲自推倒重做。结果是,引入GPT-4o后的实际工作效率比人类单独工作还慢了13%(0.87倍,呈现经济负收益)!
- 只有当模型的胜率突破 $w \ge 40%$ 的生死临界线时(由o3与Opus 4.1实现),人类的审查成本才被模型交付的成功率所抵消,真正带来1.3倍至1.4倍的净生产力加速。
4. 杜绝数据污染的实时学术研究评测:DeepScholar-Bench (2025)
面对没有唯一标准答案的开放式学术调研或深度研究智能体(Deep Research Agents),行业该如何进行客观评估?
2025年8月发布的DeepScholar-Bench通过搭建持续抓取每周arXiv最新提交论文的实时数据流水线(Live Pipeline),从源头上彻底切断了模型提前背诵题目的数据污染可能。
       [每周实时同步arXiv最新前沿论文 (0% 数据污染保证)]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│               DeepScholar-Bench 3大维度7项评估指标体系                  │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. 知识综合力 (Knowledge Synthesis)                                     │
│    • 逻辑架构与行文连贯性 (篇章组织、清晰度、学术排版规范)              │
│    • 核心信息元覆盖率 (Nugget Coverage: 必备原子的事实捕获率)           │
│ 2. 检索质量 (Retrieval Quality)                                         │
│    • 文献相关性比例 (引用文献与研讨核心主题的契合程度)                  │
│    • 文献重要性 (甄别并引用该领域奠基性权威文献的能力)                  │
│ 3. 可验证性 (Verifiability)                                             │
│    • 引用精度 (正文提炼的论据在引注文献原文中真实存在的精确比例)        │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [顺序互换LLM裁判: 代数化对消位置偏见 (Position Bias)]
30.9% 综合得分展现的客观现实
即便强如OpenAI DeepResearch这样的顶尖研究型智能体,在7大指标下的几何平均得分也仅有30.9%:
- 行文华丽与事实单薄的脱节: 智能体在文本组织结构方面得分颇高(Organization: 85.7%),但在捕获必备事实的覆盖率(Nugget Coverage: 39.2%)以及检索核心经典文献(Document Importance: 12.4%)上表现十分薄弱。
- 预置完美检索结果的“先知实验”: 当研究人员直接向智能体喂入标准论文列表时,综合得分也仅仅爬升至 49%。这无可辩驳地证明:当前深度研究智能体的最大阻碍并非“搜索”,而在于**“读完多篇长文后提炼深刻见解的跨文档综合能力 (Synthesis)”**。
5. 现代前沿智能体评估体系全景对比矩阵
=============================================================================================================
评测维度              METR (2025)                   OpenAI GDPval (2025)          DeepScholar-Bench (2025)
-------------------------------------------------------------------------------------------------------------
核心衡量单位          人类专家耗时 (小时/分/秒)     实际经济价值 ($ 美元)         7大维度综合质量向量
涵盖任务类型          复杂软件开发与机器学习工程    44个高价值白领数字化专业      开放式前沿科学综述与调研
真值判定准则          确定性单元测试通过与否        14年资深专家双盲对决胜率      原子化信息元 (Nuggets) 命中
抗数据污染设计        专属气隙隔离离线任务库        企业专属非公开业务PRD场景     每周动态挂钩最新arXiv文献
人工审核成本考量      未建模 (全自动判分)           Try-n-then-fix 修正代价公式   顺序互换LLM裁判消除位置偏见
当前最高基准记录      o3: 110分钟时间地平线 (50%)   Opus 4.1: 47.6% 双盲胜率      DeepResearch: 30.9% 几何均分
=============================================================================================================
6. 技术深度问答 (Q&A)
Q1: METR所定义的“任务泥泞度 (Task Messiness)”究竟包含哪些维度,如何影响智能体表现?
METR框架下的**任务泥泞度 (Task Messiness)**量化了真实世界区别于纯粹算法题目的16项现实摩擦力:
- 动态状态突变: 智能体执行期间外界环境发生变动(例如网络波动、微服务锁竞争)。
- 不可逆破坏风险: 缺乏平庸的撤销机制(例如误删核心生产表或破坏性代码提交)。
- 主动信息搜集要求: 任务未预先投喂清晰入参,模型必须自主调用命令查找日志并推断上下文。
回归分析表明:在METR泥泞度评分量表上每上升1分,智能体的完成成功率平均线性暴跌8.1%。智能体的实战优劣,取决于抵御这些泥泞环境噪音的韧性。
Q2: LLM裁判的位置偏见 (Position Bias) 是如何通过“顺序互换 (Swapped-Order)”消除的?
当让LLM裁判对比两份候选方案 $(A)$ 与 $(B)$ 时,模型普遍表现出显著的位置偏见 (Position Bias),在内容质量相仿时有60%~70%的基准倾向性青睐被排在前面的 $(A)$。
为消除这一系统性干扰,DeepScholar-Bench实施顺序互换双向取均值 (Swapped-Order Averaging):
- 轮次1:以
[A, B]顺序输入,记录评分向量 $S_1 = [s(A), s(B)]$; - 轮次2:将顺序反转为
[B, A]输入,记录评分向量 $S_2 = [s(B), s(A)]$; - 计算算术平均值:
S_final(A) = ( S1(A) + S2(A) ) / 2
S_final(B) = ( S1(B) + S2(B) ) / 2
在保持采样温度一致的前提下,排列顺序导致的倾向性在代数运算中相互抵消,从而提炼出客观公正的判定信号。
总结:Part 3(智能体工程)圆满完结
至此,我们完整攻克了Stanford CS329A的第三个核心篇章——Part 3 · Agent Engineering (L10~L12):
- 第10讲: 攻坚工业级代码仓库修复的 SWE-Agents 与硬件探针闭环优化的 KernelBench
- 第11讲: 赋予智能体永恒认知周期的 MemGPT、Cartridges 与 CacheBlend
- 第12讲: 以物理时间 (METR) 与商业资本 (GDPval) 为尺度的终极评估体系
我们不仅掌握了自进化智能体的设计与训练,还为其武装了分层记忆中枢,并构筑了严谨扎实的工程验证防线。
迈向 Part 4 · Frontiers(终极最前沿)
在接下来的课程终章——**Part 4 · Frontiers (第13讲至第17讲)**中,我们将跨越系统工程的范畴,迈入机器智能的最深邃奥秘:推理的本质。
下一讲第13讲的主题为:《LLM Reasoning: 大模型推理的本质与思维链 (Chain-of-Thought, Self-Consistency, Emergent Cognitive Scaling)》。我们将以Google DeepMind杰出科学家Denny Zhou博士的开创性研究为基石,深层剖析大语言模型内部“逻辑推理之火”被点燃的核心机制。
本讲核心精要
- 以时间为尺度: 真正的智能体能力应以50%成功率时间地平线(
h_agent)衡量,它遵循着每7个月翻倍的规律,从GPT-2的2秒增长至o3的110分钟。 - 复核成本决定经济效益: 智能体的双盲胜率若低于40%,人工审查与返工将导致整体业务陷入效率倒退。
- 跨文档综合是终极瓶颈: 在开放式学术研究中,搜索已不是卡点,从多源文献中提炼高密度关键见解的综合力才是真正的分水岭。