Stanford CS329A (Ep 14): AlphaProof & Mathematical Reasoning — 形式化验证、Lean 4、AlphaGeometry 与 Gemini Deep Think

在上一讲关于大模型推理的课程中,我们探讨了思维链(Chain-of-Thought, CoT)提示工程与自我一致性(Self-Consistency)解码如何在神经网络内部激发多步因果推理的火花。然而,在加密协议验证、航天轨道控制软件以及人类最高殿堂的数学定理证明等任务关键型前沿领域,纯自然语言文本依然存在致命隐患:
"无论大语言模型生成的自然语言思维链看起来多么流畅优美,它在本质上依然是一个概率性标记序列。一个微小的符号错误、循环论证或基于幻觉的引理,都会导致整个系统崩溃。在严谨的数学殿堂中,99% 正确的证明等价于 0% 正确。"
欢迎来到 Stanford CS329A: Self-Improving AI Agents 的 Part 4: 前沿探索(Frontiers in Reasoning & Autonomy) 第二讲:Lecture 14。依托 Google DeepMind 研究总监兼 AlphaProof 核心缔造者 Thang Luong 博士 的开拓性工作,我们将深入剖析人工智能如何跨越概率性预测,升华为 100% 具备确定性机械验证能力的超人类数学智能,并最终在国际数学奥林匹克(IMO)中斩获历史性奖牌:
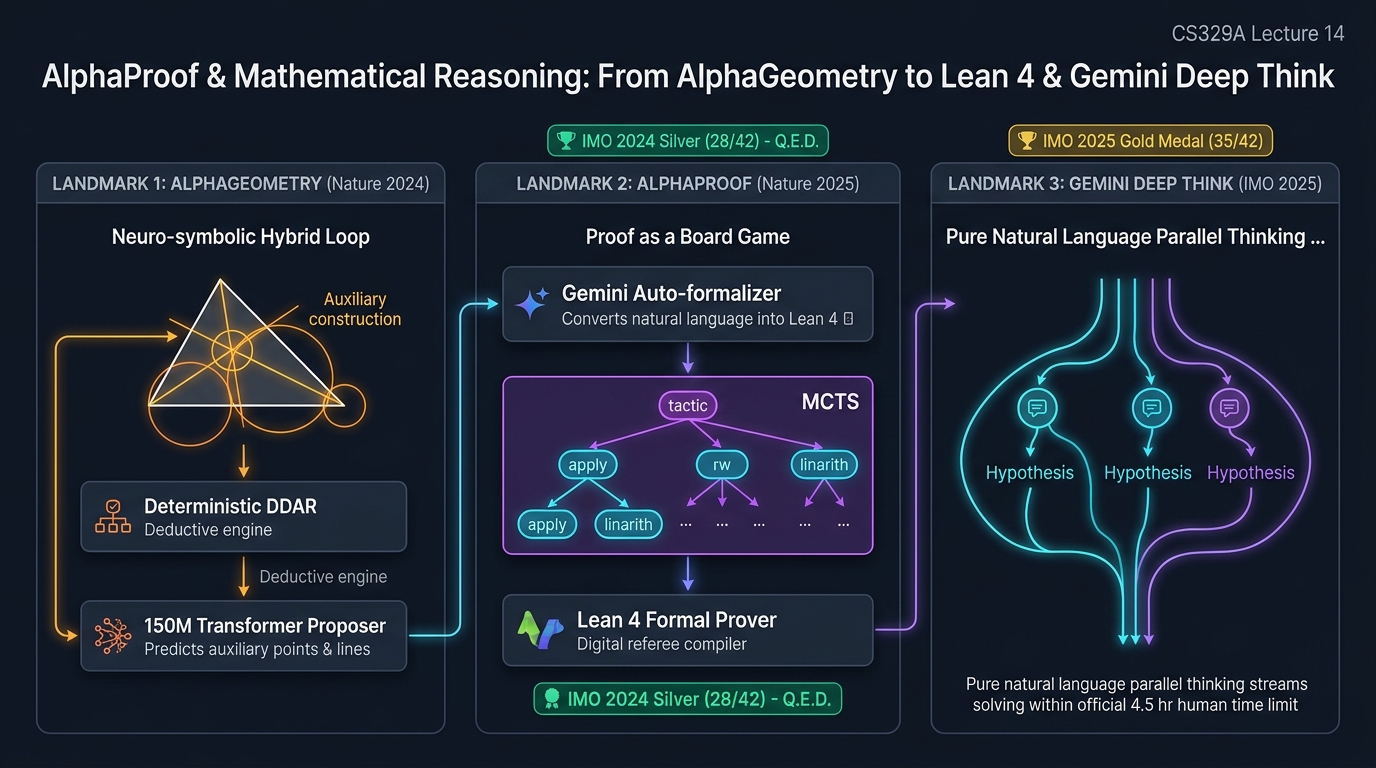
- AlphaGeometry (Nature 2024): 将确定性符号演绎引擎与生成式 Transformer 辅助几何构造相结合的神经符号(Neuro-Symbolic)架构。
- AlphaProof (DeepMind, Nature 2025): 借助交互式定理证明器 Lean 4、自动形式化(Auto-formalization)与测试时强化学习(TTRL),将数学定理证明重塑为 AlphaZero 式棋盘博弈。
- Gemini Deep Think (IMO 2025): 纯自然语言推理与平行思考(Parallel Thinking)的巅峰之作,在人类 4.5 小时考试时限内夺得全球首枚官方 IMO 个人金牌(35/42)。
- LLM 形式化验证与数学推理: 机器编译器检查的形式化内核与自由自然语言强化学习的深层对比。
1. 数学:检验人工智能智能水平的终极试金石
为什么数学被公认为检验自律型 AI 智能体的「终极试金石(Litmus Test)」?代码基准测试(如 SWE-bench)和对话任务通常允许启发式替代方案或局部模糊性,但形式化数学施加了三项不可妥协的硬性约束:
┌──────────────────────────────────────────────────────────────────────────┐
│              数学作为人工智能终极试金石的 3 大核心支柱                   │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│  客观机械可验证性       │  │   极致的奖励稀疏性      │  │   浩瀚的组合搜索空间    │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • 形式化逻辑系统        │  │ • 数百步复杂推演中,    │  │ • 引理空间的有效分支因子│
│   (Lean 4, Coq, Isabelle)│   在终点前奖励恒为 0      │    趋近于无穷 (b -> inf)  │
│ • 确定性类型检查编译器  │  │ • 仅在最终达成目标      │  │ • 几何辅助线/辅助点发明 │
│ • 幻觉概率严格为 0%     │    (Goal Solved) 时给奖励│    需要真正的创造力突破   │
│ • 真伪判定绝对二元化    │  │ • 信用分配极度困难      │  │ • 盲目暴力搜索彻底失效 │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
- 客观机械可验证性(Objective Mechanical Verifiability): 与主观评判的文学或法律不同,形式化数学由确定性类型检查程序(如 Lean 4 编译器)进行 100% 严谨验证,不容任何侥幸。
- 极致的奖励稀疏性(Extreme Reward Sparsity): 在长达数十甚至数百步的推演中,智能体在闭合最终证明目标(
Goal Solved)前得不到任何正向奖励。即使 99% 的推导完全正确,若最后一步出错,整体奖励依然为 0。 - 浩瀚的组合搜索空间(Massive Combinatorial Search Space): 国际象棋平均分支因子约为 35,围棋约为 250,而形式化数学中的引理与战术选择空间在理论上是无界的($b \to \infty$)。
2. 神经符号融合:AlphaGeometry (Trinh et al., Nature 2024)
国际数学奥林匹克中的欧几里得几何问题素以刁钻著称。选手即便通晓全部公理,若无法在脑海中构思出一条巧妙的辅助线(Auxiliary Construction)——例如穿过三个隐含点的辅助圆或一条辅助垂线——便会在 4 小时内寸步难行。
历史上,人工智能在此分为两大对立流派:
- 符号逻辑引擎(DDAR): 由演绎数据库与代数推理器组成,推演 100% 精确且绝无计算失误,但毫无直觉创造力,一旦现有公理耗尽便彻底停滞。
- 深度神经网络(Transformers): 擅长模式识别与直觉想象,但容易出现微小数值偏差和角度幻觉,导致全盘推导崩溃。
AlphaGeometry 将两者构筑为非对称的共生架构:
               +-------------------------------------------+
               |            欧几里得几何问题输入           |
               +---------------------+---------------------+
                                     |
                                     v
                        +----------------------------+
                        |    符号逻辑引擎 (DDAR)     | <---------+
                        |    - 演绎数据库 (DD)       |           |
                        |    - 代数推理器 (AR)       |           |
                        +--------------+-------------+           |
                                       |                         |
                         [证明目标是否已达成?]                  |
                           /                   \                 |
                        (成功)                 (未达成 / 卡壳)   |
                         /                       \               |
                        v                         v              |
             +--------------------+    +-----------------------+ |
             | 输出完整证明       |    | 150M 参数 Transformer | |
             | (人类可读文本)     |    | 辅助几何元素生成器    | |
             +--------------------+    +-----------+-----------+ |
                                                   |             |
                                       [预测极具潜力的         | |
                                        辅助点与辅助线]        | |
                                                   +-------------+
1 亿条合成数据生成引擎(Synthetic Data Generation)
AlphaGeometry 面临的最大壁垒是训练数据匮乏:人类百年奥数历史上,形式化几何题库不足千道。DeepMind 另辟蹊径构建了庞大的合成流水线:
- 随机几何拓扑生成: 计算机随机生成 10 亿种点、线段和圆的无序组合。
- 前向演绎挖掘: 符号引擎(DDAR)在这些随机图形中,自动挖掘出 1 亿条偶然成立的有效几何定理与证明路径。
- 辅助线强依赖过滤: 从中精准筛选出 900 万条「唯有引入特定辅助线才能证毕」的关键定理。
- 监督微调蒸馏: 训练 150M 参数的 Transformer,使其在符号引擎卡壳时能够精准预判这 900 万类必备辅助构造。
基准测试结果
在历年 30 道 IMO 几何题目基准测试中:
- 先前最强符号主义方法(吴方法)仅解出 10 道题。
- AlphaGeometry 在官方考试时间内成功证明 25 道题,比肩人类 IMO 金牌选手水准。
- 在 2004 年 IMO 第 1 题中,AlphaGeometry 甚至发现了出题组未曾察觉的冗余前提,将该定理推广至更广泛的数学形态。
3. 将定理证明化为棋盘博弈:AlphaProof (Nature 2025)
几何学仅是数学大厦的一角。要攻克数论、抽象代数和组合数学,智能体必须在严密的形式化语言环境中执行多步逻辑推演。
2024 年 7 月,Thang Luong 博士团队揭开了 AlphaProof 的面纱,其核心设计理念是将定理证明转化为与严密编译器对弈的二人零和棋盘博弈。
┌──────────────────────────────────────────────────────────────────────────┐
│                   AlphaProof 核心系统架构                                │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Gemini 自动形式化器      │                   │ AlphaZero 证明搜索网络    │
├──────────────────────────┤                   ├───────────────────────────┤
│ • 自然语言数学题输入     │                   │ • 3B 参数 Transformer     │
│ • 1 亿道原始数学题库     │                   │ • Lean 4 战术(Tactic)策略:│
│ • 双向回译语义验证       │                   │   apply, rw, linarith     │
│ • Lean 4 形式化代码规范  │                   │ • 价值网络: 预估距离      │
│ • 8000 万道有效形式化定理│                   │   终点 Q.E.D. 的推导步数  │
└────────────┬─────────────┘                   └─────────────┬─────────────┘
             │                                               │
             └───────────────────────┬───────────────────────┘
                                     ▼
                      ┌─────────────────────────────┐
                      │    Lean 4 形式化内核环境    │
                      ├─────────────────────────────┤
                      │ • 严格类型检查编译器        │
                      │ • 环境实时反馈循环          │
                      │ • 二元化机械判定 (0 或 1):  │
                      │   - 战术指令成功编译        │
                      │   - 类型居留达成 (Q.E.D.)   │
                      └─────────────────────────────┘
Lean 4 环境:数学的无限数字棋盘
Lean 4 是一门基于归纳构造演算(CIC)的纯函数式编程语言。根据柯里-霍华德同构(Curry-Howard Correspondence):
- 数学命题(Proposition)对应于类型(Type)。
- 数学证明(Proof)对应于居留该类型的程序项(Term)。
- Lean 编译器充当终极裁判:只要代码成功通过编译,该命题便在数学上获得 100% 的绝对证明。
智能体在每一步推导中观察当前的目标(Goal)状态,并依次落子执行诸如 induction、ring、rw [mul_comm] 或 linarith 等形式化战术(Tactics)。
自动形式化:跨越数据鸿沟的 8000 万定理库
全球精通 Lean 4 语言的数学家不足千人。DeepMind 借助 Gemini 大模型将海量教材与竞赛题翻译为 Lean 4 规范代码,并辅以严格的形式化回译检验,构建起包含 8000 万道题目的形式化数学语料库。
测试时强化学习(TTRL, Test-Time Reinforcement Learning)
在面对 IMO 2024 最为恶名昭彰的第 6 题(全球 609 名精英仅 5 人解出的极高难度组合题)时,常规模型推演陷入僵局。DeepMind 果断启动了 TTRL:
[输入: IMO 2024 第 6 题]
         │
         ▼
[Gemini 自动化数学题目合成器]
         │
         ├──> 针对该题拓扑特征,现场自动生成 400,000 道变体题目
         │    (简化参数规模、边界特例、中间辅助引理)
         ▼
[调集数千张 TPU v5e 超级算力集群]
         │
         ├──> 在这 40 万道变体题目上持续运行 AlphaZero 自我对弈
         ├──> 在推断测试阶段直接对模型权重进行为期 3 天的实时强化更新
         ▼
[针对该特定难题产生定制化超智能专家模型]
         │
         ▼
[生成第 6 题并通过 Lean 4 编译器 100% 严密机器验证!]
最终,AlphaProof 攻克全部 6 题中的 4 道题,斩获 28 分/42 分——荣获官方 IMO 银牌(距离金牌线仅差 1 分)。
4. 纯自然语言推理征服金牌:Gemini Deep Think (IMO 2025)
尽管 AlphaProof 取得了历史性胜利,但仍面临两大工程瓶颈:
- 将自然语言题目转化为 Lean 4 代码高度依赖繁杂的前处理流水线。
- TTRL 推理计算耗时长达 3 天,远超人类选手的 每天 4.5 小时考试时限。
2025 年 7 月,DeepMind 推出了无需形式化翻译、以纯自然语言攻克奥数之巅的 Gemini Deep Think:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Gemini Deep Think: 平行思考运行机制                    │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ 假说路径 A (代数变形)   │  │ 假说路径 B (几何反演)   │  │ 假说路径 C (组合不等式) │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • 正推进至第 4 步       │  │ • 卡在引理 3 证明阶段   │  │ • 成功推导出渐近上界   │
│ • 自我审查发现矛盾点    │  │ • 果断执行分支剪枝操作  │  │ • 提取为假说 A 的前置项 │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
Gemini Deep Think 摒弃了单链顺序生成的模式,采用了平行思考(Parallel Thinking):
- 同时在脑海中展开数十条截然不同的代数、几何与解析假说。
- 当某条推演路径卡死时,系统迅速提取其部分不变量,并跨路径融入其他有效活跃分支。
- 在与人类选手完全一致的 4.5 小时时限内交卷,成功解决 6 道题中的 5 道,以 35 分/42 分赢得了人工智能历史上首枚官方 IMO 个人金牌。
5. 架构深层对比:形式化验证 vs 自然语言强化学习
+-----------------------+----------------------------------+----------------------------------+
| 核心对比维度          | 形式化验证路线 (AlphaProof)      | 纯自然语言 RL 路线 (Deep Think)  |
+-----------------------+----------------------------------+----------------------------------+
| 验证引擎              | Lean 4 严格类型检查器            | 多智能体 LLM 协作与自我评判      |
| 幻觉发生率            | 绝对为 0% (代码编译通过即保真)   | > 0% (仍存在极其微小的逻辑跳跃)  |
| 搜索耗时              | 数小时至 3 天 (MCTS + TTRL)      | 4.5 小时以内 (实时动态推理)      |
| 适用领域              | 严苛加密系统、智能合约、数学定理 | 开放域科学研究、跨学科战略规划   |
| 基础设施依赖          | Lean 4 生态系统与 Mathlib 库     | 超大规模分布式强化学习基础设施   |
+-----------------------+----------------------------------+----------------------------------+
6. 核心工程总结与启示
- 合成数据是前沿推理的破局关键: AlphaGeometry 证明,当高质量现实数据枯竭时,符号逻辑引擎能够自举合成数以亿计的严密证明路径,以低成本预热神经网络直觉。
- 形式化验证彻底根除幻觉: 在容错率为零的关键领域,必须将语言模型与 Lean 4 等确定性编译内核相绑定。
- 测试时强化学习(TTRL)潜力无限: AlphaProof 证明,在推理阶段动态合成变体并针对性更新权重的策略,能让模型跨越原本静态能力的边界。
- 自然语言平行思考可匹敌人类敏捷度: Gemini Deep Think 证明,通过多分支平行思考,纯自然语言模型在严格时间约束下同样能够绽放人类顶级数学家的光芒。
在下一讲 Lecture 15: Autonomous Systems & Reliability 中,我们将走出确定性的数学象牙塔,直面现实软件世界的复杂混沌,深入剖析自律型智能体如何构建自我修复(Self-Healing)、沙箱防护与安全边界。敬请期待!