Stanford CS329A (Ep 16): Multimodal & Embodied Agents — 操控物理世界的机器人大模型 (VLA, RT-2, OpenVLA 与 π₀)

在上一讲关于自主系统与可靠性的课程中,我们探讨了软件智能体如何在虚拟沙箱内依托多重边界防御线束与 AI Control 协议维持系统的稳健性。然而,人工智能学界面临着一个更为本质的拷问:
"一个仅局限于计算机屏幕之内、生成文本并运行代码的系统,能真正被称为通用人工智能(AGI)吗?我们所身处的真实物理世界并非由虚拟命令构建,而是充满了重力、摩擦力、三维空间几何以及刚体与柔性物体的复杂物理交互。"
如果我们为基础大模型装上一双高分辨率的「眼睛」(RGB 摄像头)与一条由七个自由度钢制关节构成的机械臂,世界将会发生怎样的蜕变?
- 稳稳抓起一颗生鸡蛋并轻柔放入平底锅,蛋壳丝毫不损;
- 在杂乱无章的客厅地面上,将儿童玩具精准按颜色分拣收纳进对应储物盒;
- 在自动化工业装配线上,以 0.1 毫米级的极致精度精准对准并插入微型电子接插件!
欢迎来到 Stanford CS329A: Self-Improving AI Agents 的 Part 4: 前沿探索(Frontiers in Reasoning & Autonomy) 第四讲:Lecture 16。依托 Google DeepMind 机器人团队核心成员、Physical Intelligence 联合创始研究员 Danny Driess 博士 的开创性成果,我们将全面剖析视觉-语言-动作模型(VLA, Vision-Language-Action)这一将多模态大模型直接植入机器人运动神经的革命性体系:
- 动作即语言(RT-2, DeepMind 2023): 将 7 自由度连续机械臂运动量离散化为 256 个词元,并入 55B 巨型 VLM 词表的跨界创新。
- 开源与轻量化的胜利(OpenVLA, 2024): 依托 SigLIP 与 DINOv2 双视觉编码融合、分位数分箱(Quantile Binning)与 LoRA 适配,在单张消费级显卡上实现反超 55B 专有模型的 7B 架构奇迹。
- 连续控制与物理世界反馈($\pi_0$): 克服离散分箱微颤、征服叠衣服与折纸箱等柔性物体复杂操控的流匹配(Flow Matching)扩散策略。
- 具身智能双重安全机制: 软件级阈值动作截断与硬件级力矩传感器物理反射回路。
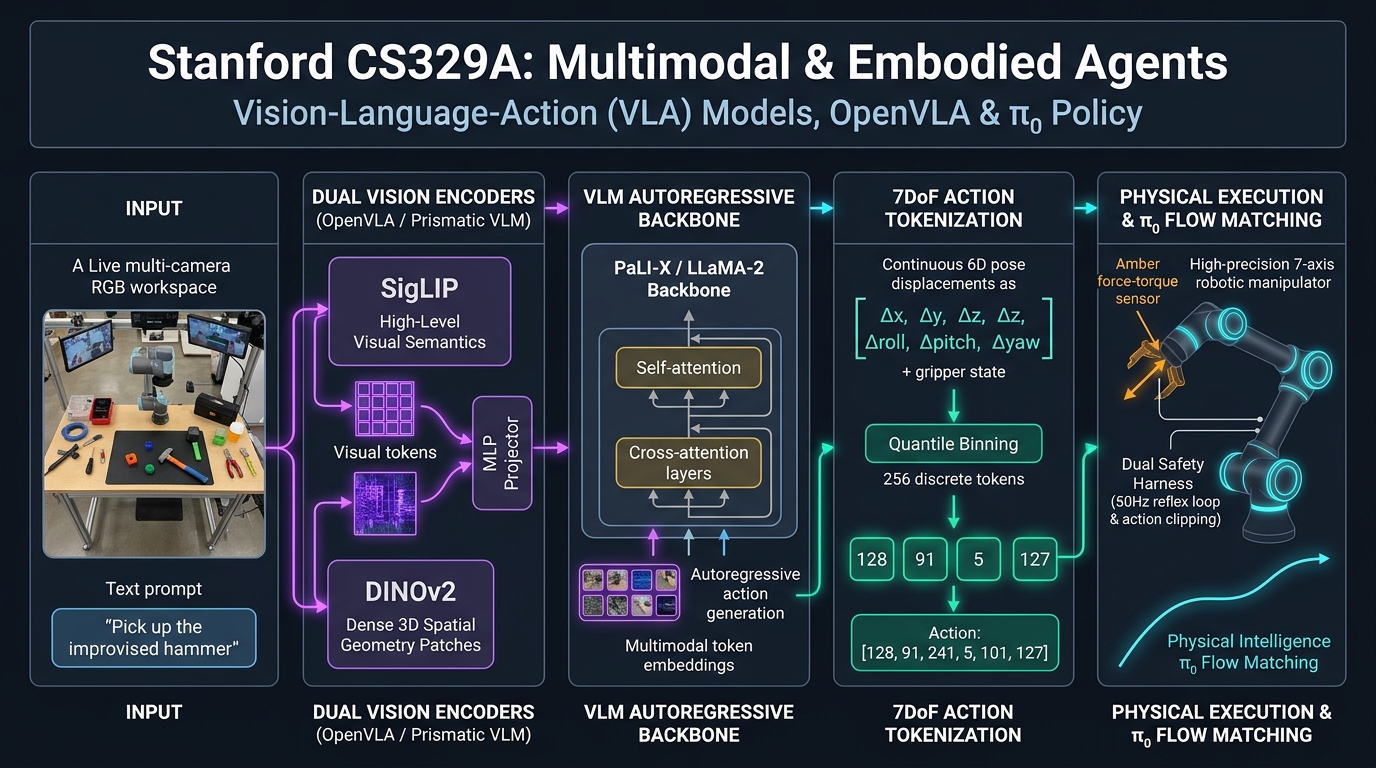
1. 物理世界的前沿:突破机器人领域的「数据极度饥渴」
数十年来,机器人控制技术始终深陷于极其严峻的数据贫瘠之中。纯文本语言模型能够吞吐全网数以万亿计的标记蓬勃发展,但真实机械臂运动轨迹的采集成本却极其高昂:
- 必须依赖专业人员在物理实验室中操作实体硬件进行遥操作。
- 谷歌实验室动用 13 台机械臂持续全负荷运转 17 个月,仅勉强积攒出区区 13 万条有效操作轨迹。
- 因而,局限于狭小实验室内训练的传统机器人泛化能力极差:环境光线稍微发生 10% 的偏移,或者桌面物体位置挪动 5 厘米,机械臂便会在虚空中胡乱抓取并导致任务失败。
Danny Driess 博士与 DeepMind 团队提出了颠覆机器人学认知范式的核心构想:
"不要再从零开始用贫瘠的机器人数据去苦苦训练专用控制策略。直接引入互联网海量图文预训练完成的超巨型视觉语言模型(VLM),并将机械臂关节电机的运动增量视为『一门全新的外语单词』塞进词表!"
┌──────────────────────────────────────────────────────────────────────────┐
│              视觉-语言-动作(VLA)模型的范式演进                         │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────────────┐   ┌──────────────────────────────────┐
│ 传统专用机器人控制策略           │   │ 视觉-语言-动作 (VLA) 模型        │
├──────────────────────────────────┤   ├──────────────────────────────────┤
│ • 基于几千条封闭实验室数据训练的 │   │ • 7B 至 55B 参数的超强多模态底座 │
│   小微卷积神经网络 (CNN/ResNet)  │   │ • 具备互联网级全域图文预训练知识 │
│ • 语义泛化能力绝对为 0%          │   │ • 内置强大的物理常识推理能力:    │
│ • 物体移动 5 厘米即导致全盘失效  │     「石头可以作为临时锤子敲钉子」   │
│ • 每项新任务必须从头编写代码     │   │ • 零样本适应未曾见过的全新物体   │
│ • 严重孤立的任务烟囱             │     与杂乱开放的现实物理环境         │
└──────────────────────────────────┘   └──────────────────────────────────┘
2. 动作即词元:RT-2 (Brohan et al., DeepMind 2023)
2023 年 7 月,Google DeepMind 正式推出了 Robotic Transformer 2 (RT-2),将 55B 参数的 PaLI-X 与 12B 的 PaLM-E 等巨型多模态基座成功重塑为端到端机械臂物理控制器。
[输入: RGB 摄像头画面] + [任务指令: "把足球移动到梅西 (Lionel Messi) 的照片旁边"]
                                     │
                                     ▼
     ┌───────────────────────────────────────────────────────────────┐
     │             巨型 VLA 底座模型 (PaLI-X 55B)                    │
     │  • 互联网常识推理: 视觉识别照片上阿根廷球星梅西的面容         │
     │  • 三维几何空间认知: 计算足球与目标照片的相对空间坐标         │
     └───────────────────────────────┬───────────────────────────────┘
                                     │
                                     ▼ (自回归输出下一个词元序列)
                   "Action: 1 128 91 241 5 101 127"
                     │       │  │   │   │  │   │   └─ 机械爪夹持力度 (127)
                     │       │  │   │   └──┴───┴───── 三维姿态角增量 (Δroll, Δpitch, Δyaw)
                     │       └──┴───┴──────────────── 三维空间位置增量 (Δx, Δy, Δz)
                     └─────────────────────────────── 动作持续标志位
7 自由度 (7DoF) 动作空间与 256 区间均匀离散化
通用工业级机械臂通常在 7 自由度连续空间中规划位姿控制:
- 三维平移位移量 ($\Delta x, \Delta y, \Delta z$): 机械臂末端执行器的空间位置增量。
- 三维旋转欧拉角增量 ($\Delta roll, \Delta pitch, \Delta yaw$): 机械腕部姿态方向调整。
- 夹爪开合状态 ($gripper$): 抓取或释放物体的开合控制度。
为将这组连续浮点数向量转换为 Transformer 能够直接自回归生成的离散 Token,RT-2 设计了**均匀动作词元化(Uniform Action Discretization)**机制:
- 将机械臂沿每个自由度的可动物理范围
[a_min, a_max](例如[-30cm, +30cm])等距切分为 256 个区间(Bins):
\text{bin\_index} = \left\lfloor 256 \times \frac{a - a_{\min}}{a_{\max} - a_{\min}} \right\rfloor, \quad \text{截断至 } [0, 255]
- 从大模型原有词表中抽取 256 个极低频词元,与这些动作区间索引建立一对一符号重映射(Symbol Tuning)。
- 在解码阶段施加输出约束掩码(Output Constraint Mask),强制模型在运动控制模式下仅采样这 256 个合法动作词元。
互联网语义知识的物理级迁移
保留了全网预训练记忆的 RT-2 展现出了惊人的「通灵」能力:
- 尽管其机械臂微调轨迹中从未出现过「拿锤子」的字眼,但在摆放了石头与图钉的桌面上听到 "抓起可以当临时锤子的工具" 时,机器人毫无迟疑地直接抓起了石头。
- "指出看起来最疲惫的动物玩偶", "把喝完的易拉罐扔进垃圾桶" 等需要人类文化知识与复杂推理的任务均被高精度完成,较以往顶级专用机器人架构(RT-1)实现了逾 3 倍的泛化胜率。
协同微调 (Co-Fine-Tuning):抵御灾难性遗忘
若直接使用纯机械臂控制数据微调 55B 的模型,其内部网络会遭遇灾难性遗忘(Catastrophic Forgetting),丢失在海量图文中习得的常识推演力。RT-2 采用协同微调,在每轮训练批次中按比例强制混入原生互联网图文对,使语义逻辑神经元始终保持活跃。
3. 开源与轻量化平民化:OpenVLA (2024)
RT-2 虽性能斐然,但其 55B 的庞大体量完全依赖谷歌 TPU 云端集群驱动,代码权重均未开源,学术界长期难以涉足。
2024 年夏,斯坦福大学与 UC 伯克利团队联合开源了基于 Open X-Embodiment(汇聚 70 多个实验室、97 万条实战轨迹)打造的首个 7B 级通用开源基座模型——OpenVLA。
               +-------------------------------------------+
               |             RGB 摄像头原始输入            |
               +---------------------+---------------------+
                                     |
                       +-------------+-------------+
                       |                           |
                       v                           v
             +--------------------+     +--------------------+
             |   SigLIP 编码器    |     |   DINOv2 编码器    |
             | (高层语义概念提取) |     | (高频三维空间几何  |
             |                    |     |  与局部特征提取)   |
             +---------+----------+     +----------+---------+
                       |                           |
                       +-------------+-------------+
                                     | (通道维度拼接 / Concatenation)
                                     v
                        +----------------------------+
                        |      2 层 MLP 投影层       |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |   Llama-2 7B 语言大模型底座|
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        | 256 个分位数动作 Token     |
                        +----------------------------+
1. 双视觉编码融合:SigLIP + DINOv2 (Prismatic VLM)
机械臂精准操控与常规图片问答存在本质差异,它不仅需要语义理解,更对杯子把手距离右侧究竟突出了几毫米等毫米级空间深度几何信息有极度苛刻的要求:
- SigLIP(语义编码器): 擅长语言与画面的高维语义对齐。
- DINOv2(空间几何编码器): 具备出类拔萃的边缘轮廓定位与深度感知力。
- 双编码器特征在通道维度拼接后,机器人抓取成功率较单用 SigLIP 直升 20% 以上。
2. 分位数分箱(Quantile Binning)
RT-2 的均匀分箱隐藏着巨大缺陷:物理操控中 90% 的动作集中在 1 毫米级的微调阶段,而快速挥臂的大动作不足 1%。均匀切分会导致最关键的微小移动区间分辨率严重不足。
- OpenVLA 统计了 97 万条动作数据的累积分布,基于分位数(Quantile)自适应划分区间:
\text{分箱断点: } q_k = \text{Quantile}\left(\mathcal{D}_{\text{actions}}, \frac{k}{256}\right), \quad k \in [0, 256]
- 将 Token 分辨率高度集中于细腻对齐区域,大幅消除了机械臂末端的失误抓空。
3. LoRA 1.4% 微调与单张消费级显卡驱动
- 冻结视觉底座,仅对 Llama-2 的 1.4% 关键权重执行 LoRA 低秩微调,15 小时内便可适配一台全新构型的实体机械臂。
- 采用 4-bit 量化(NF4)将显存压缩至 7GB,仅凭单张普通游戏显卡(NVIDIA RTX 4090)即可实现 6Hz 实时闭环操控。
- 在 29 项实体机器人真实评测中,OpenVLA 比 55B 的 RT-2-X 整体绝对胜率高出 16.5%,完成了一场以小胜大的技术突袭。
4. 迈向连续控制新境界:Physical Intelligence $\pi_0$ (2024)
尽管 RT-2 与 OpenVLA 成效卓著,但离散化方案面临物理规律的天然桎梏:
- 256 个分箱带来的量化截断误差,在 50Hz 以上的高频实时控制中会诱发机械臂的微小抖动(Jittering)。
- 折叠衣物、整理软线、拼装瓦楞纸箱等涉及非刚性柔性形变物体的作业,必须借助极其平滑的连续动作轨迹。
Danny Driess 博士现所在的 Physical Intelligence 团队在其最新基座模型 $\pi_0$ (pi-zero) 中创新引入了流匹配(Flow Matching)连续扩散策略:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Physical Intelligence π₀ 核心技术架构                  │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ 高层语义 VLM 规划器      │                   │ 连续扩散流匹配控制策略    │
├──────────────────────────┤                   ├───────────────────────────┤
│ • 场景语义理解           │                   │ • 50Hz 极速实时推理       │
│ • 长期任务步骤规划       │ ── 潜空间目标向量 ─► • 连续向量场去噪生成        │
│ • 多步骤子目标追踪       │                   │ • 0% 离散抖动误差         │
└──────────────────────────┘                   └─────────────┬─────────────┘
                                                             │
                                                             ▼
                                               [平滑连续多自由度机械臂轨迹]
                                               (成功征服折叠衣服与纸箱拼装)
$\pi_0$ 由高层 VLM 提供语义目标,底层控制器则如同扩散图像生成算法一般,在连续时间维度内实时去噪输出多自由度平滑轨迹,成为全球首个能够同时胜任折叠衣物、收拾碗碟等极高难度柔性家务的统一通用机器人大模型。
5. 机器人基座模型横向架构对比
+-----------------------+----------------------------------+----------------------------------+
| 评估维度              | RT-2 (Google DeepMind)           | OpenVLA (Stanford / Berkeley)    |
+-----------------------+----------------------------------+----------------------------------+
| 模型参数规模          | 55B (PaLI-X) / 12B (PaLM-E)      | 7B (Llama-2 底座)                |
| 视觉编码器架构        | 单一视觉 Transformer (ViT)       | 语义与几何双融合 (SigLIP+DINOv2) |
| 动作离散化方案        | 256 区间线性均匀分箱             | 256 区间自适应分位数分箱         |
| 硬件部署门槛          | 需多节点 TPU 云端集群            | 单张 24GB 消费级显卡 (RTX 4090)  |
| 参数微调效率          | 全量权重微调                     | 1.4% LoRA 低秩微调 + 4-bit 量化  |
| 开源可获取性          | 闭源商业专有资产                 | 100% 权重与代码库全量开源        |
+-----------------------+----------------------------------+----------------------------------+
6. 具身智能的安全基石:双层硬件级反射网络
物理机器人具有强大的机械力矩,操作失误极易摧毁精密设备甚至致伤操作人员。工业界必须为其加装软硬件双重防护网络:
[VLA 模型动作增量输出: 7DoF 指令]
                 │
                 ▼
[第一层: 软件级运动速度与工作空间硬性截断]
  ├── 严格限制最大平移速率: ||Δpos|| <= 5cm/步
  └── 强制约束在三维虚拟电子围栏 (Bounding Box) 内部
                 │
                 ▼
[第二层: 硬件级力矩传感器极速物理反射回路 (1000 Hz)]
  ├── 当检测到异常外部碰撞力 F_contact > 20 牛顿:
  └── 硬件级直接切断电机供电 / 瞬间切换至被动柔顺缓冲模式
- 软件级动作截断: 下层电机驱动器会对大模型输出的位移步长进行硬性钳位(如单步位移严控在 5 厘米以内),并将其活动范围锁死在预设的安全电子围栏之中。
- 硬件级力矩反射回路: 运行于关节底层的 1000Hz 传感器若在抓取中检测到异常反向阻力(如意外磕碰到了人的手臂),将立刻无条件覆盖上层 VLA 指令并切断动力,依靠硬件反射神经切断安全威胁。
7. 核心工程总结
- 物理动作是语言的全新模态: 将机械臂运动空间离散化为词元,实现了将全网互联网级语义智能向物理实体的无损迁移。
- 双视觉编码融合至关重要: 融合 SigLIP 语义理解与 DINOv2 空间三维几何,是机械臂实现亚毫米级精准抓取的决定性前提。
- 分位数分箱大幅消除操控盲区: 依据真实位移分布集中分配词元分辨率,根治了机械臂在微小操作时的失误抓空。
- 连续扩散策略引领下一代机器人学: 如 $\pi_0$ 等流匹配架构消除了离散微颤,为柔性形变物体的灵巧操作指明了终极方向。
在下一讲 Lecture 17 (GRAND FINALE) 中,我们将迎来 Stanford CS329A 的大结局,重磅呈现 《Future Research Directions: 自进化智能体的未来方向与未解之谜》,全面盘点通往真正通用人工智能(AGI)的终极技术全景。终章再会!