[Maeumjigi 心语伴侣毕业设计开发日志 #21] 语料混合配比黄金分割与第 4 轮微调全面打响
· 阅读需 3 分钟

5 月 21 日与 22 日两天,Maeumjigi 毕业设计团队全量投入了针对全新高品质语料的大规模批处理生成,并正式拉开了第 4 轮微调实验 (fine_tuning_4) 的帷幕。
5 月 21 日与 22 日两天,Maeumjigi 毕业设计团队全量投入了针对全新高品质语料的大规模批处理生成,并正式拉开了第 4 轮微调实验 (fine_tuning_4) 的帷幕。
5 月 19 日至 20 日的两天时间里,第三轮微调 (fine_tuning_3) 的评估自动化与面向生产级 App 服务的全栈功能深度打磨实现了全面齐头并进。
在彻底修复昨天排查出的别名硬编码缺陷后,5 月 13 日,我们终于重启了第二轮微调大模型真实端到端的推理生成能力基准测试。
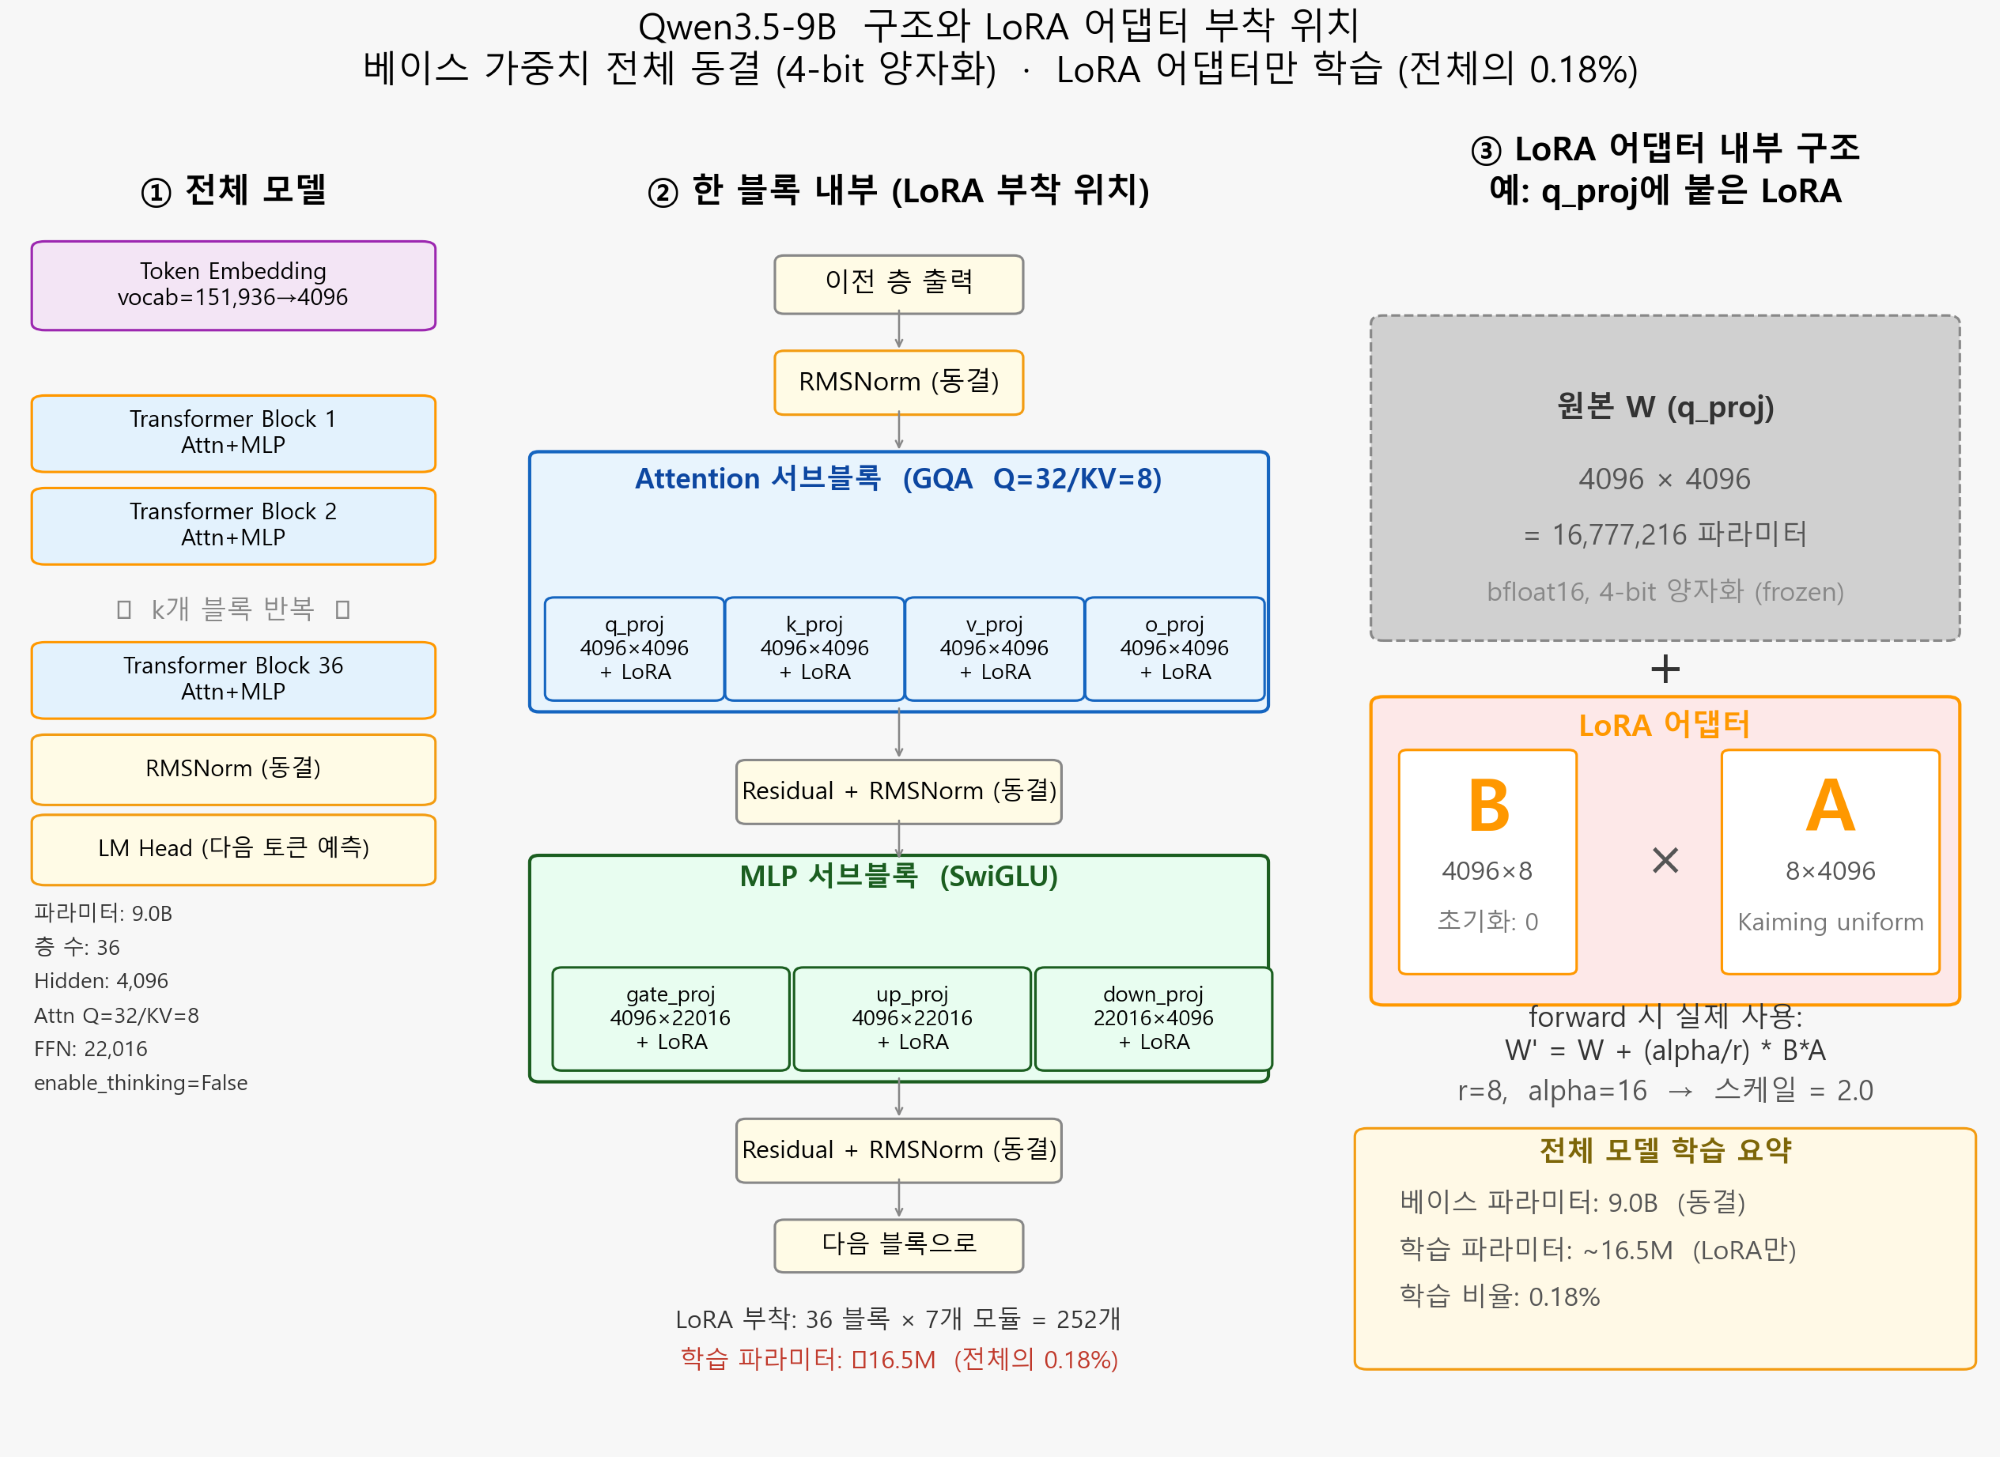
为了拨乱反正、纠正 LoRA 超参数配比倒置而仓促启动的第二轮微调 (fine_tuning_2) 多卡并行长跑,终于在 5 月 12 日迎来了胜利的曙光!
5 月 8 日,原本是我们基于此前的全量微调成果紧锣密鼓赶制毕业设计中期答辩幻灯片 (PPT) 的关键日子。 然而,正在满怀欣喜填充评测表格时,我们却突然揪出了一个令人毛骨悚然、颠覆前期结论的技术暗伤!
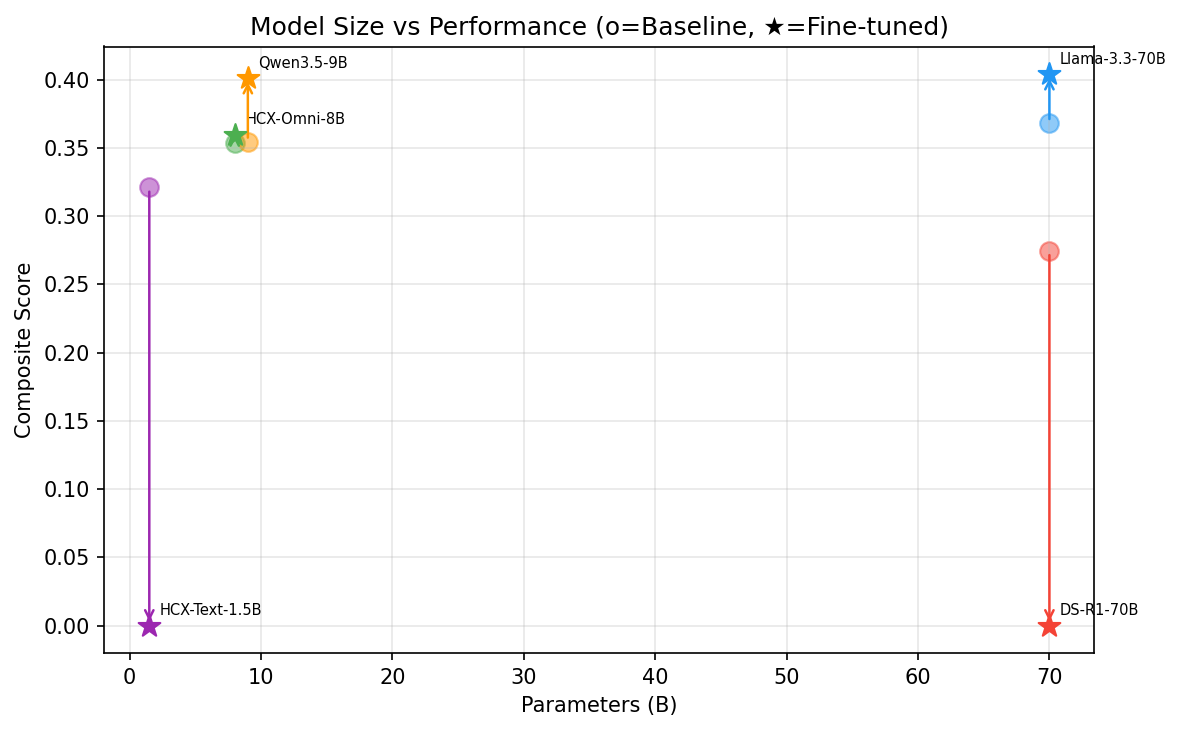
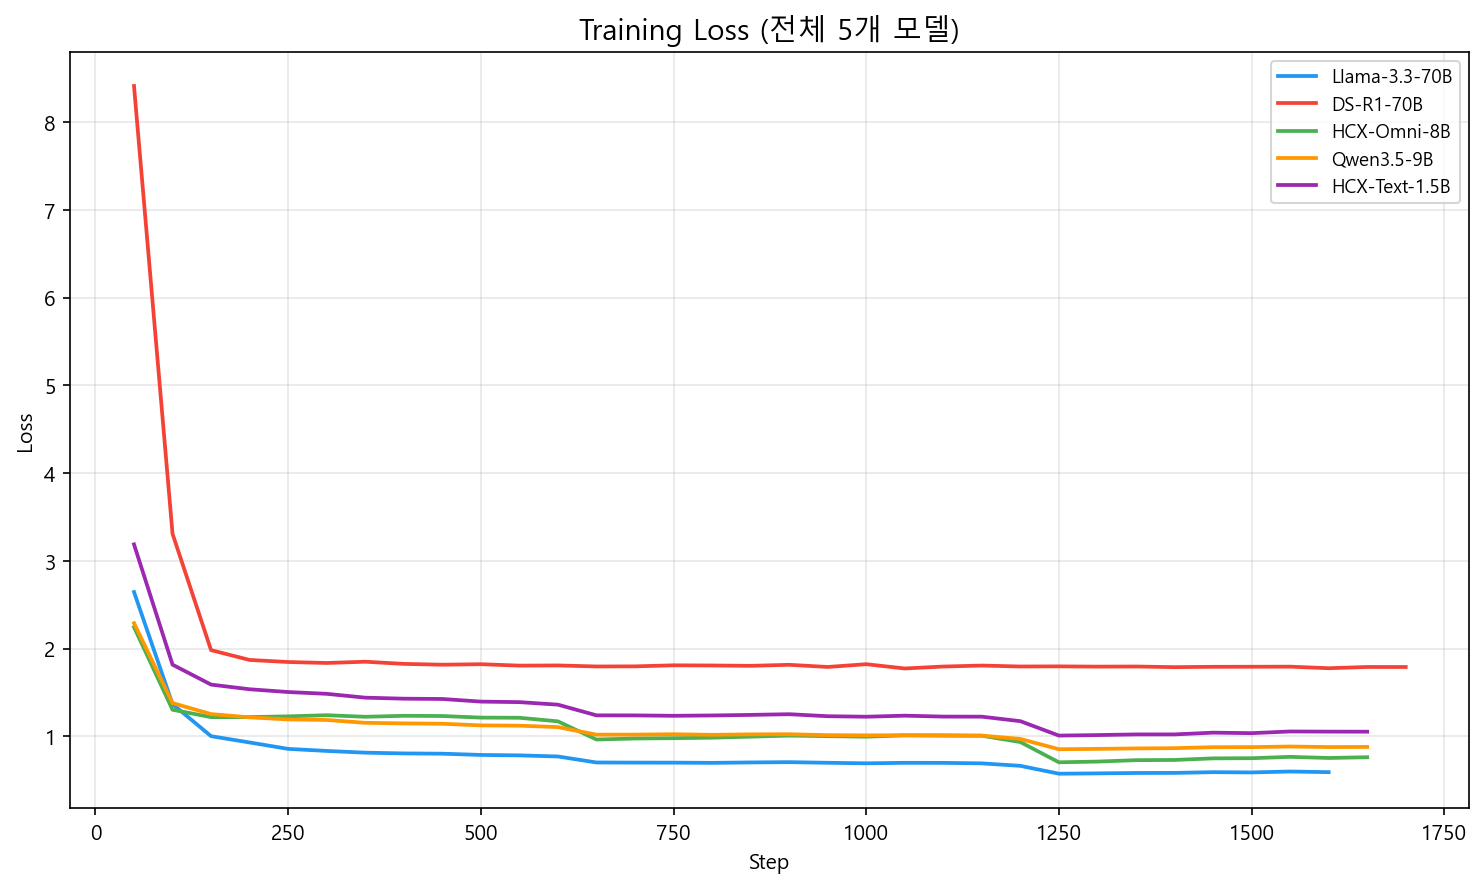
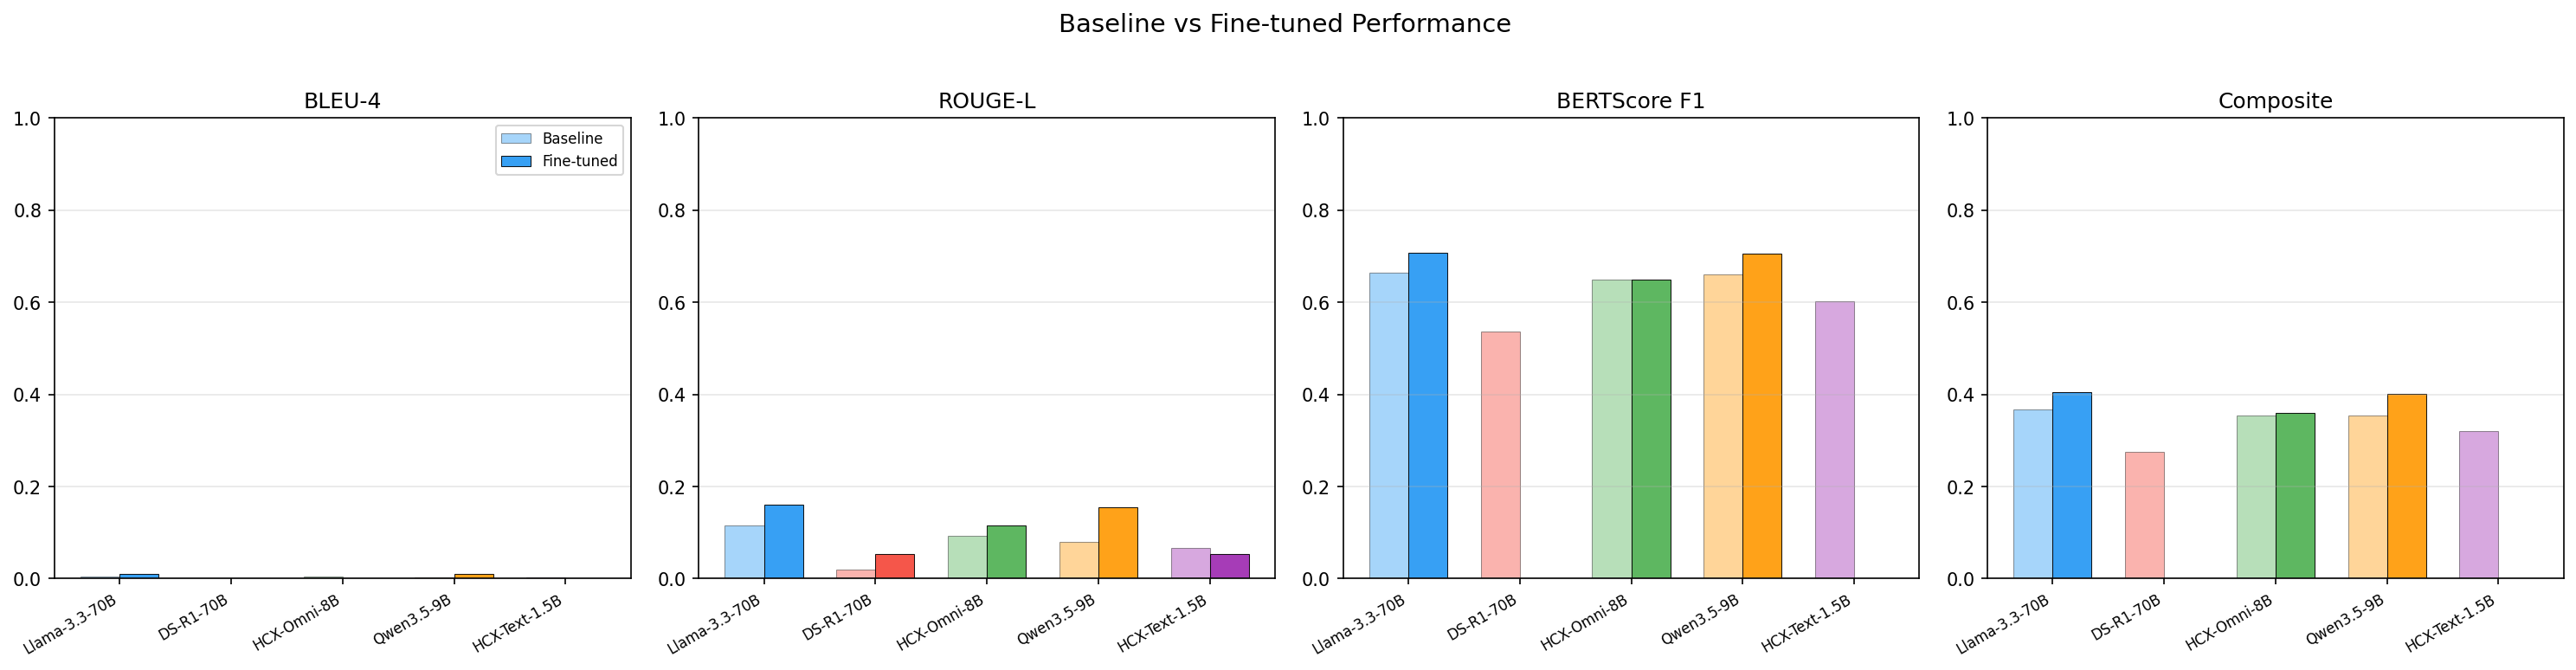
5 月 7 日,我们对倾注心血完成微调的 5 大代表性大模型(Llama 3.3-70B、DSR1-70B、HCX-Omni-8B、Qwen35-9B、HCX-Text-1.5B)的实验数据进行了全景汇总, 并全面展开了深度可视化与轻量化本地评测环境的搭建。
5 月 6 日,历经数个不眠之夜与超参数反复调试,我们终于从漫长的微调泥潭中成功破局! 以 HCX-Omni-8B 与 Qwen35-9B 为代表的中轻量级垂直大模型全量微调顺利收敛完工。
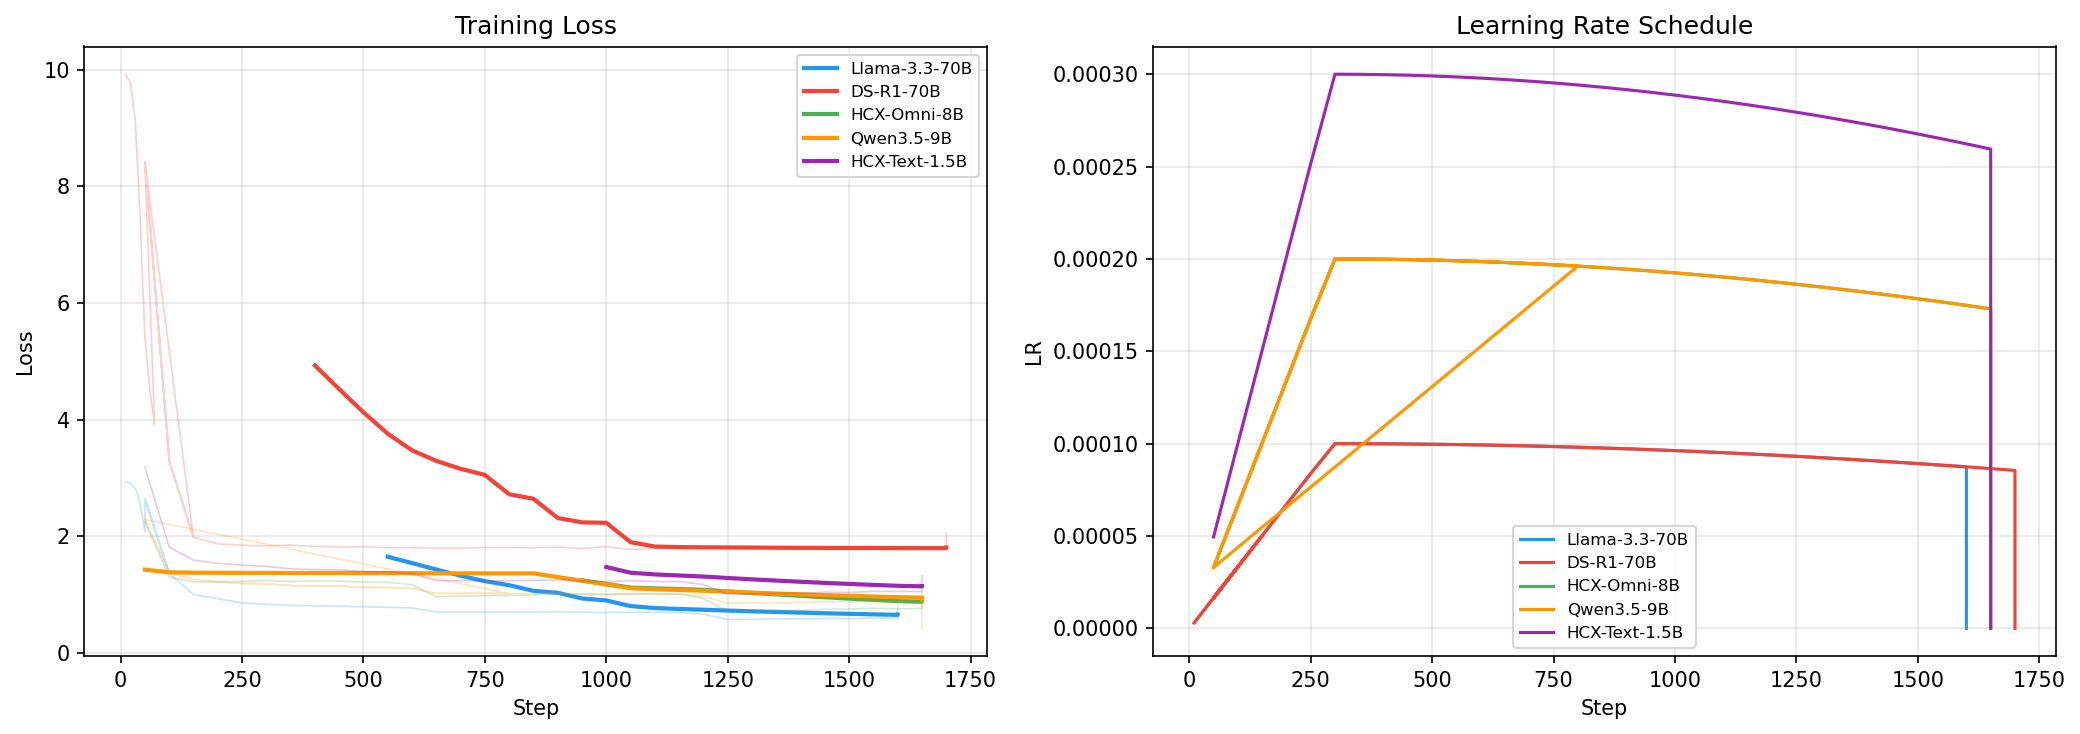
在领教了 70B 庞大参数量在微调过程中的显存地狱后,5 月 4 日,我们果断决定实施战略转向。
尽管我们曾通过将 Batch Size 压榨至极限,勉强将 70B 模型(Llama 3.3, DeepSeek-R1)推到了 checkpoint-1200 与 1300,但极其漫长迟缓的训练周期使得整体科研迭代效率极度低下。
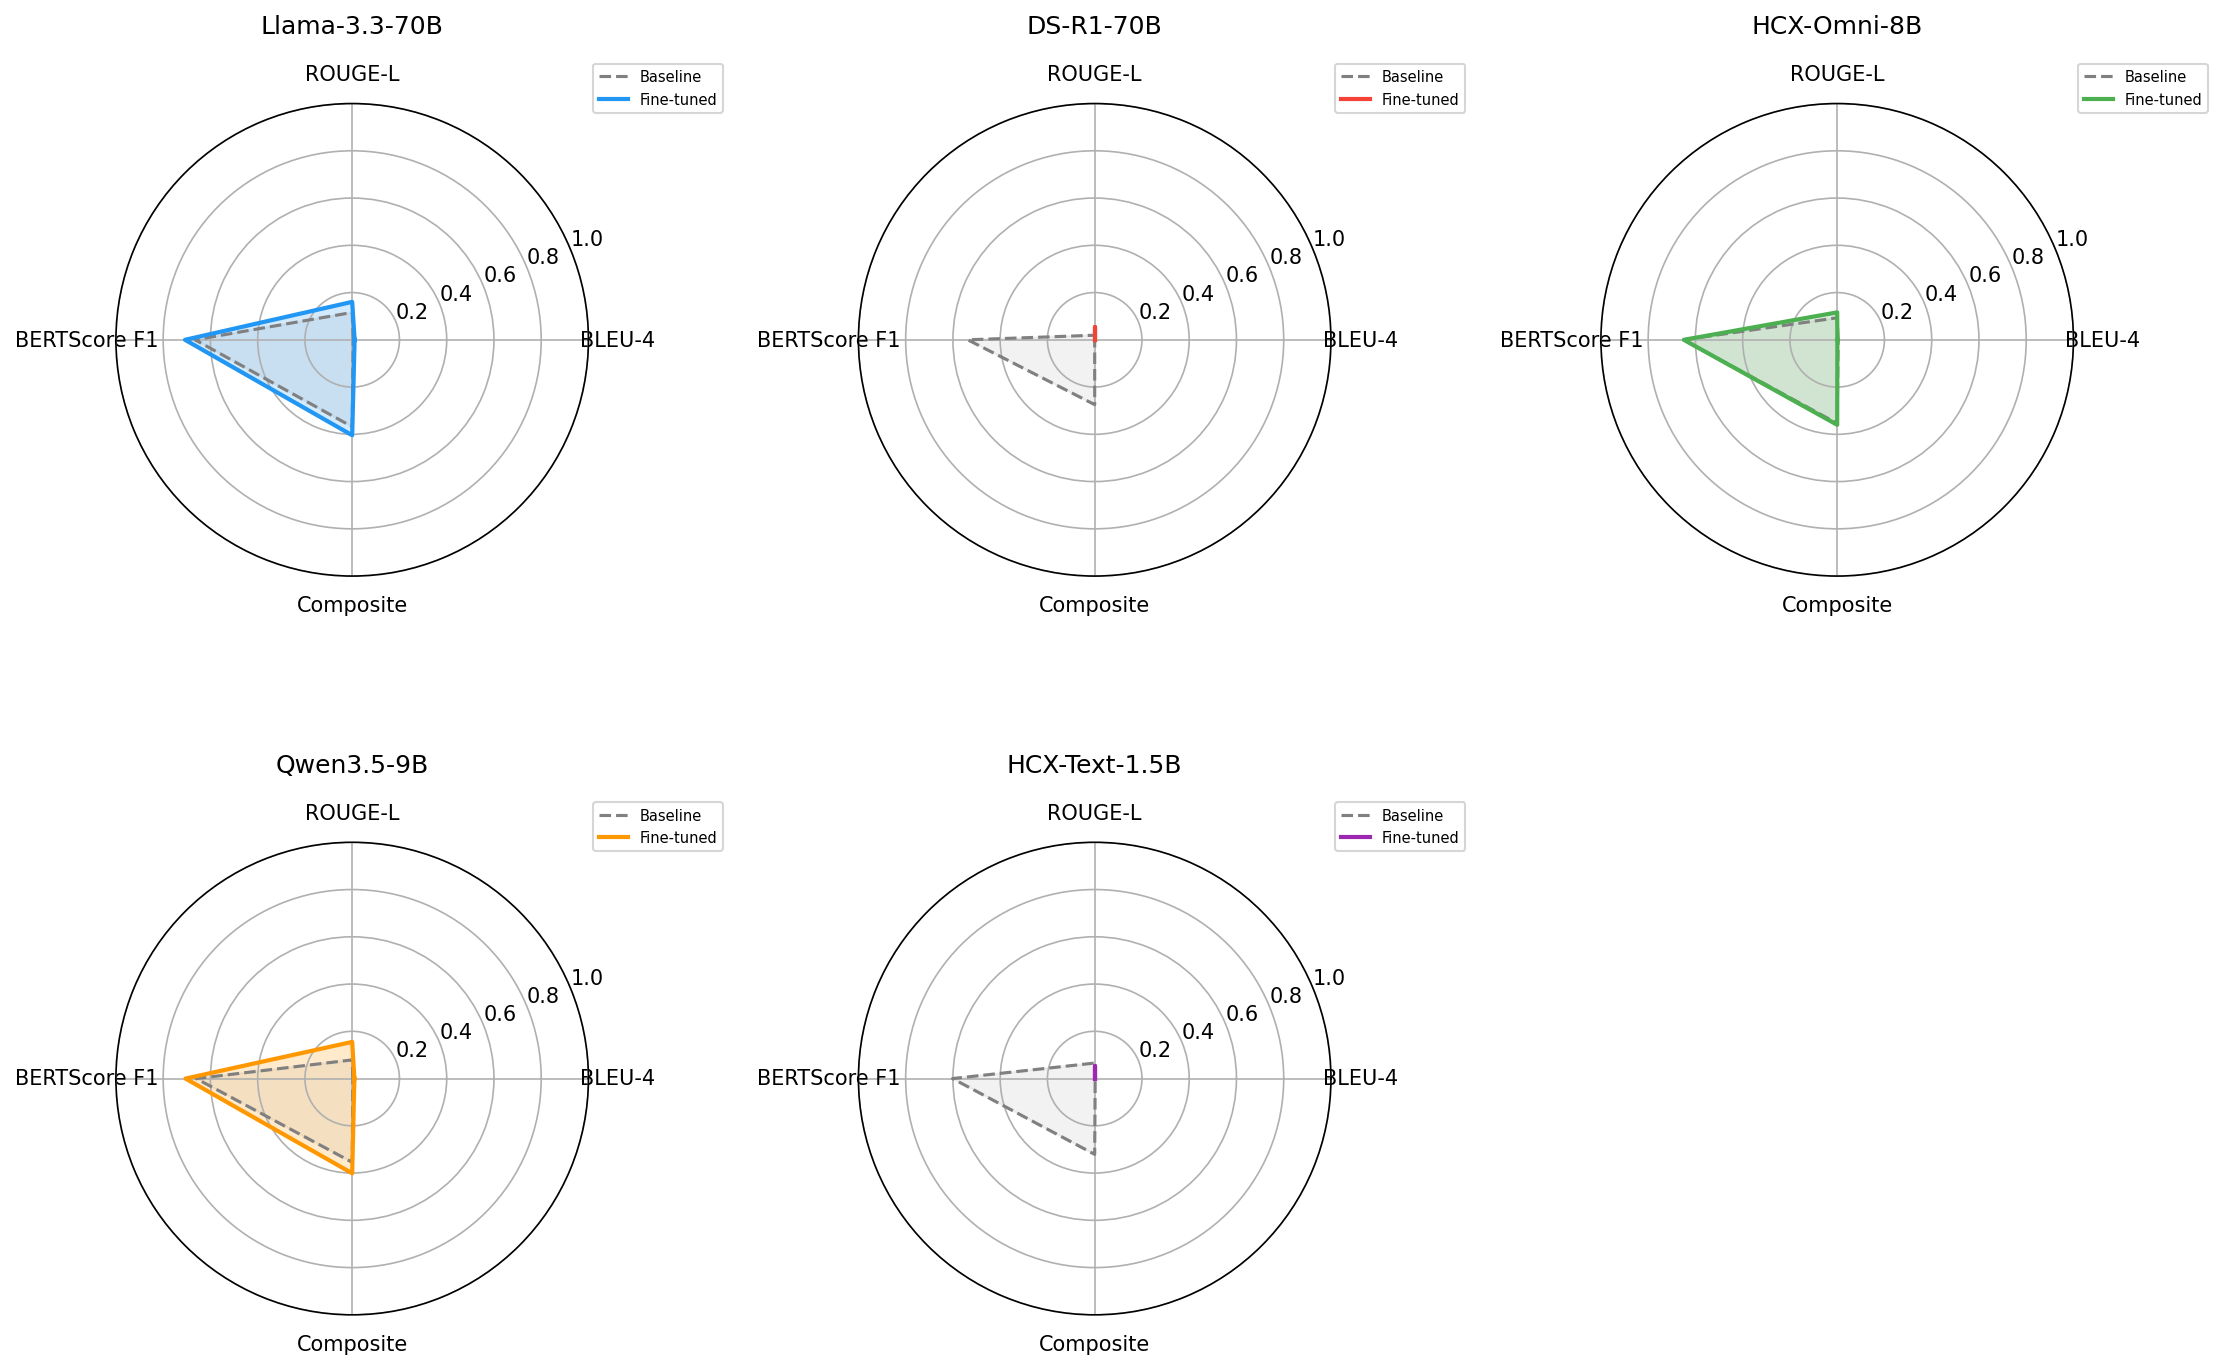
5 月 3 日,在彻底摸透 8B 小参数模型的技术脉络后,我们团队终于向大语言模型的性能天花板发起冲锋——挑战 70B (700 亿超大参数量) 模型的领域微调。 我们同时锁定了 Llama 3.3 70B 与 DeepSeek-R1 70B 两大旗舰底座,但不出所料,瞬间迎面撞上了严苛的物理显存高墙。
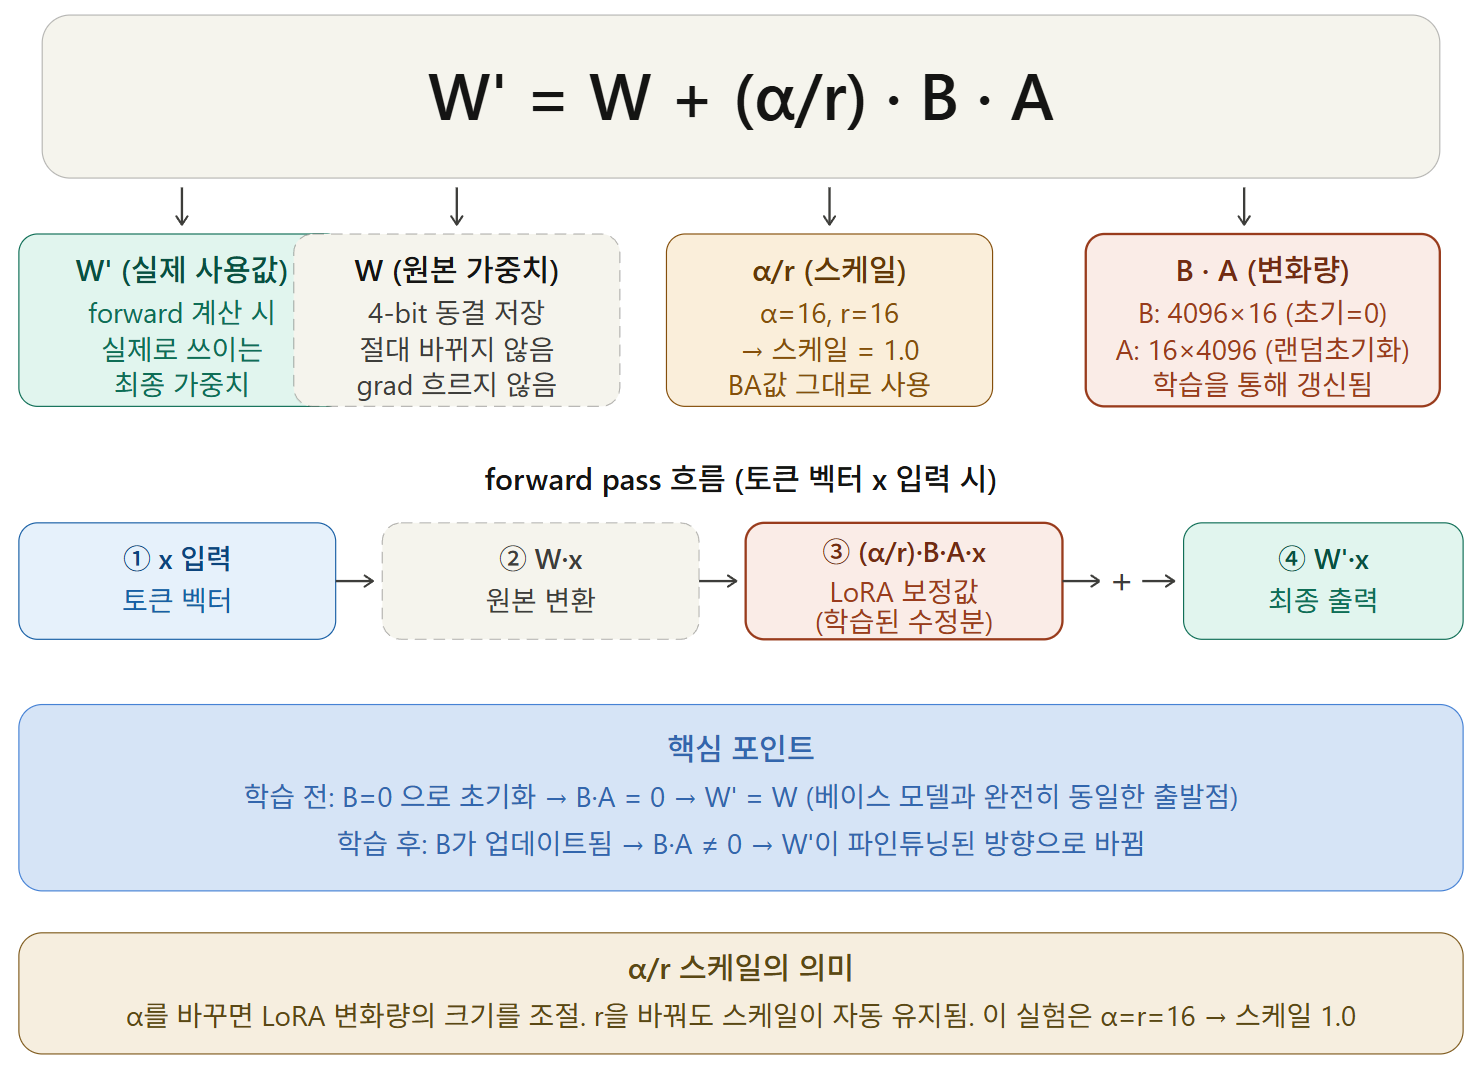
4 月 9 日,依托昨天完成的自动化 Notebook,我们终于迎来了人工智能大模型 (Llama 3.1) 的首轮正式微调训练。 然而现实充满荆棘,无数报错接踵而至。与此并行的,还有必须在深夜同步赶制第 6 周毕业设计中期答辩材料的极限挑战。
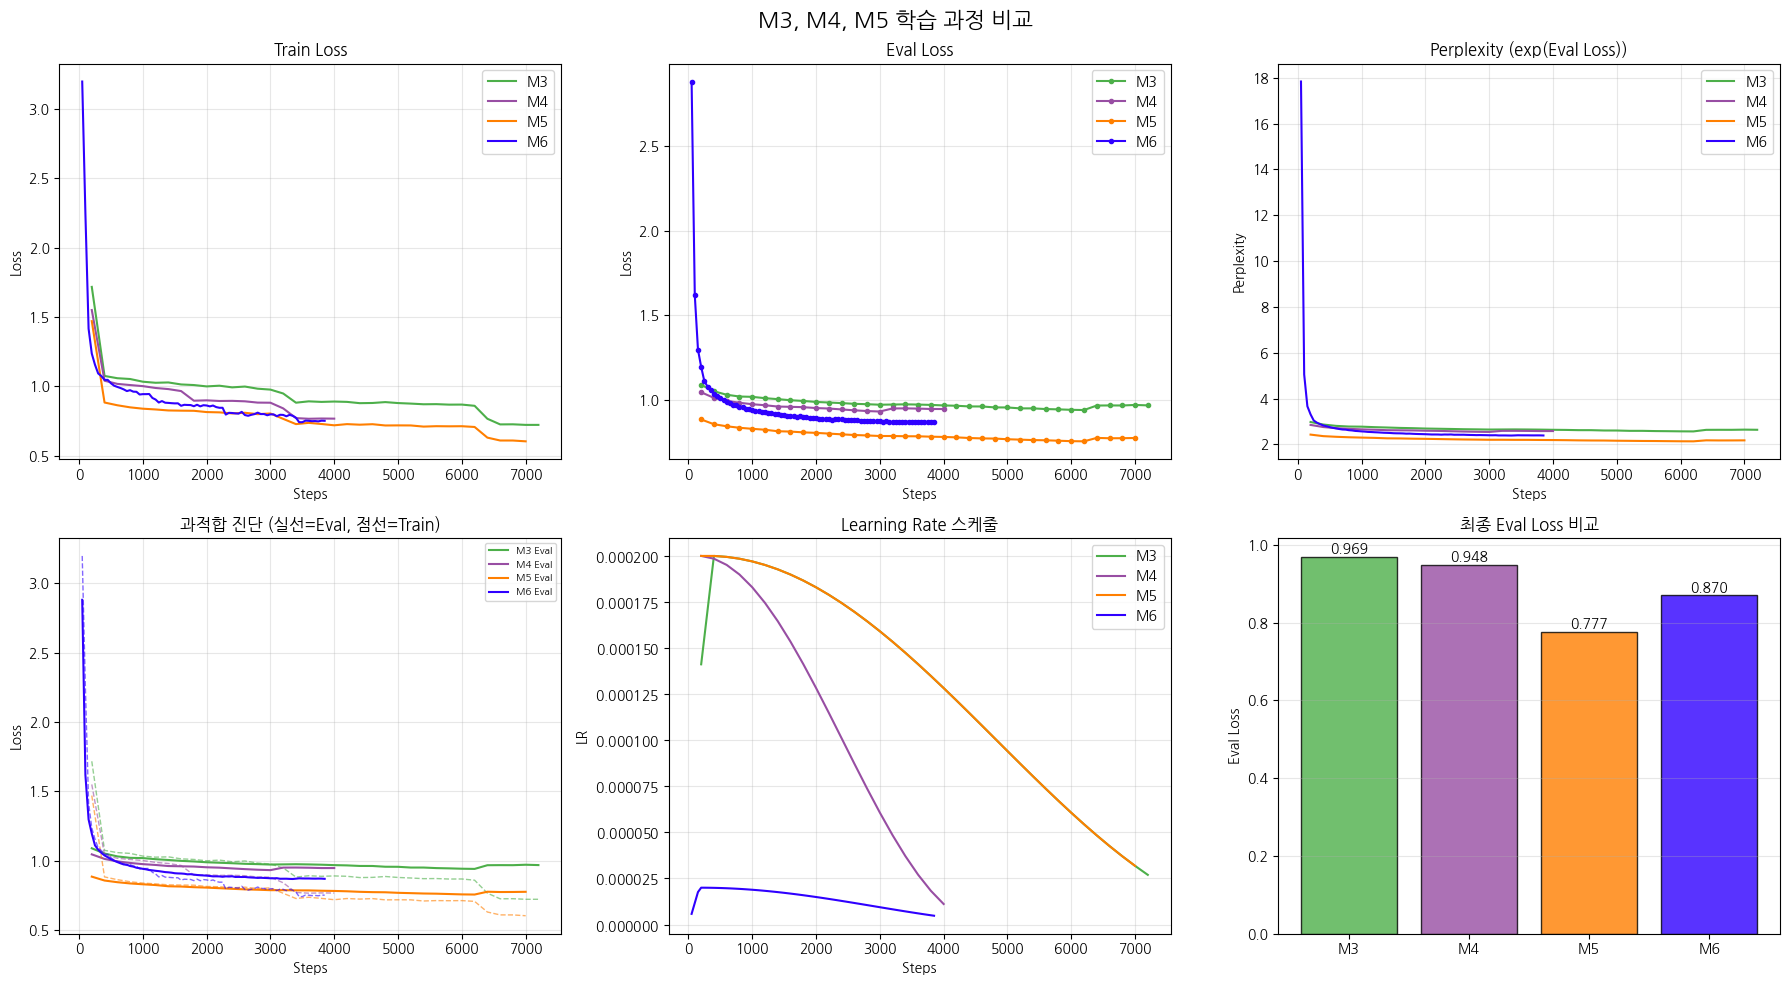
4 月 8 日,是我们在推进 Maeumjigi 项目期间经历的最严峻危机,也是令人哭笑不得的技术插曲——Claude API 达到月度配额上限与突发扣费账单危机。