[Webots 机器人] 表格型 Q-Learning 实现与奖励函数(Reward Shaping)调优 (#2)
· 阅读需 6 分钟

📌 核心要点 (TL;DR)
- 问题 (Problem):在仅在目标到达 (+1.0) 和墙体碰撞 (-1.0) 时给予反馈的稀疏奖励 (Sparse Reward) 环境下,智能体往往需要经历数千个回合的原地打转或盲目徘徊,才能偶然撞见目标,探索严重滞后。
- 解决方案 (Solution):设计了基于势能的欧氏距离增量奖励 (+0.1 × Δdist) 与单步 (-0.01)、转向 (-0.01)、倒车 (-0.05) 惩罚相结合的多目标稠密奖励整形 (Dense Reward Shaping) 机制,并配合指数衰减的 ε-贪婪 (Epsilon-Greedy, 1.0 → 0.05) 探索策略。
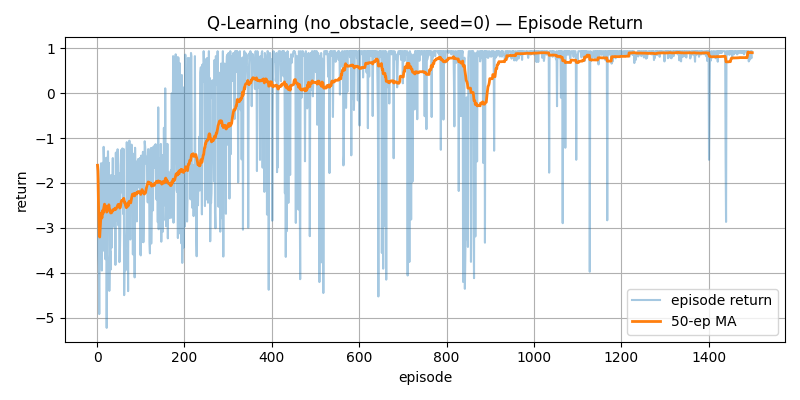
- 实验结果 (Result):在无障碍 (
no_obstacle) 场景下,移动平均奖励在 500 个回合以内稳步转正并进入高位区间 (0.7+),最终导航成功率达到 98% 以上。