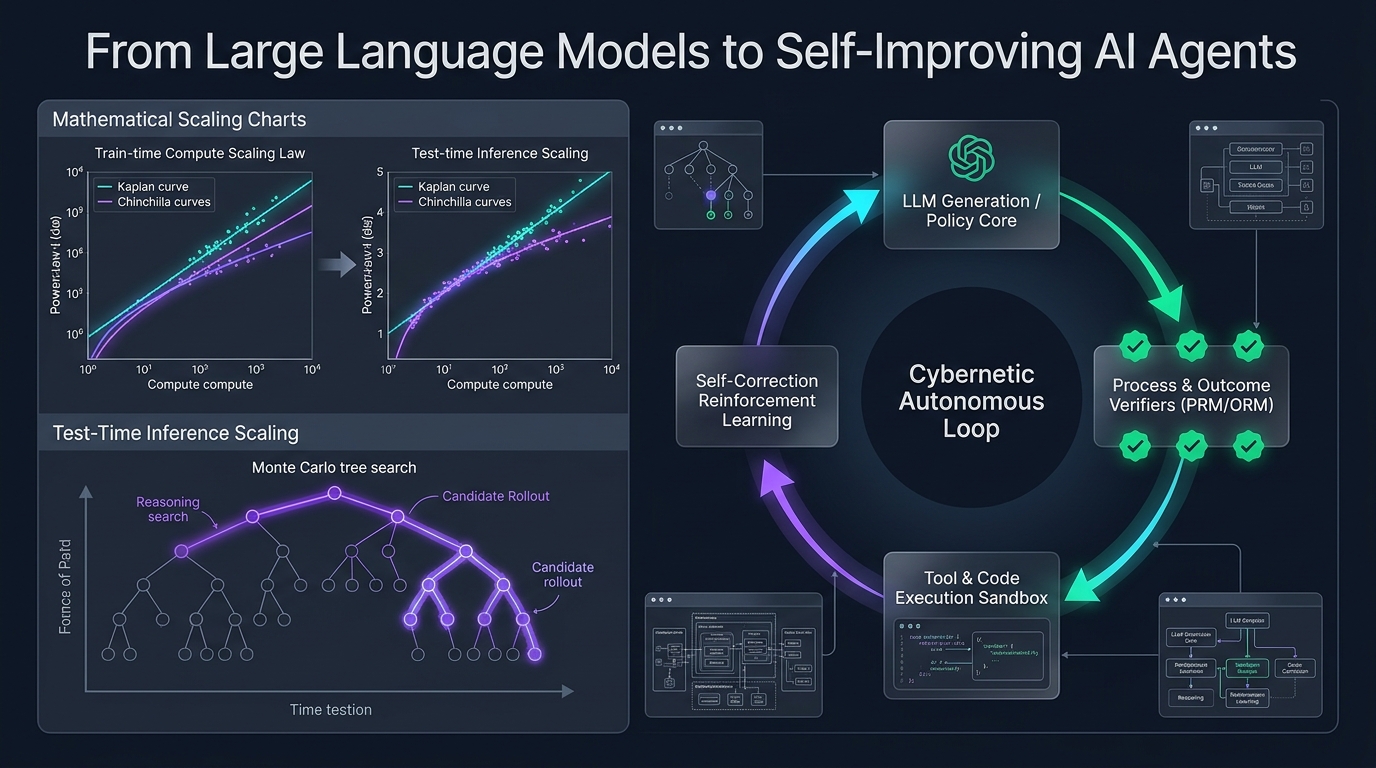
[Stanford CS329A #2] 推理时间计算缩放:超越预训练缩放定律走向计算最优推理
· 阅读需 15 分钟

欢迎阅读斯坦福大学2025年秋季最新前沿研究生课程**CS329A: Self-Improving AI Agents(自我演进AI智能体)**的第二篇专业工程解析。
在第一讲中,我们概括了从静态自回归次词预测器向具备环境反馈闭环的自主智能体转变的宏观范式跃迁。今天第二讲所探讨的,正是支撑这一自主演进能力的最核心计算支柱:推理时间计算缩放(Test-Time Compute Scaling / Inference-Time Scaling)。
过去五年中,整个AI工业界信奉的唯一教条是预训练阶段的缩放定律(Kaplan等人,Chinchilla定律):建设超大规模GPU集群,将模型参数量N推至数千亿级,并灌注数十万亿标记(Tokens)的互联网数据。然而,在模型权重θ预训练完成后,如果我们拒绝让模型在50毫秒内草率给出贪心预测(Greedy decoding),而是让智能体花费10秒、1分钟甚至10分钟深入思考、检验中间步骤、并自主推敲修正假设,会发生什么?
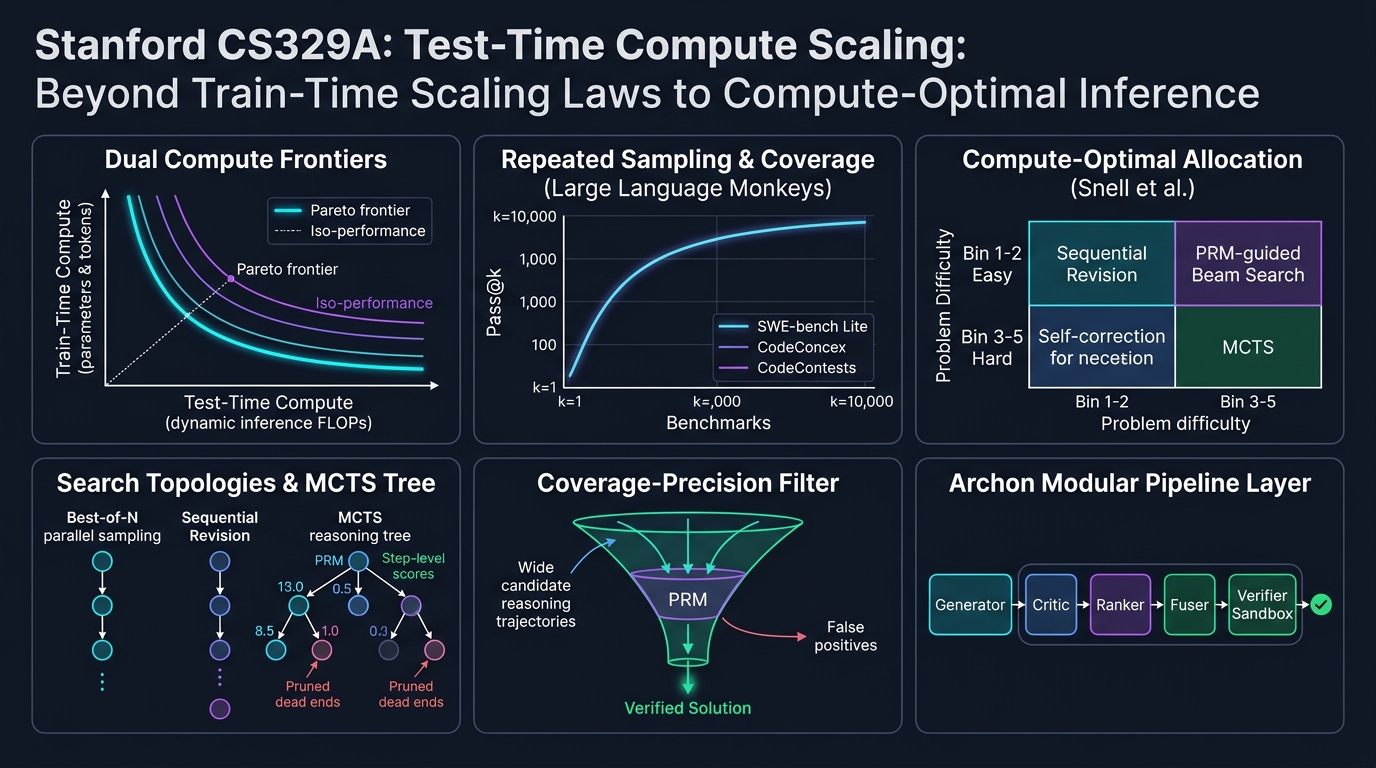
依托Large Language Monkeys(Brown等人,2024)、斯坦福-伯克利Charlie Snell研究团队的Compute-Optimal Scaling(Snell等人,2024)以及Archon模块化架构搜索框架,我们将从数学理论与系统工程双重视角,彻底解析**“如何通过投入推理算力(FLOPs)打破参数规模垄断,实现智能飞跃”**。
flowchart TD
    subgraph PreTrain ["经典前沿:预训练时间计算缩放 (Train-Time Scaling)"]
        direction TB
        P1["数十万亿公开网络数据标记 (D)"] --> P2["超大规模GPU训练集群 (C_train)"]
        P2 --> P3["事后权重冻结的稠密模型 (θ)"]
        P3 --> P4["单次前向传播推理 (O(1) 固定推理算力)"]
    end

    subgraph TestTime ["CS329A前沿:推理时间计算缩放 (Test-Time Compute Scaling)"]
        direction TB
        T1["冻结的基础权重 (θ)"] --> T2["动态分配推理计算量 (FLOPs)"]
        T2 --> T3{"问题难度自适应策略选择"}
        T3 -- "低难度 (Bin 1-2)" --> T4["顺序修正 (Sequential Revision: 自我纠错)"]
        T3 -- "高难度 (Bin 3-5)" --> T5["PRM引导的树搜索 (MCTS / 束搜索)"]
        T4 --> T6["过程奖励模型 (PRM) 验证器"]
        T5 --> T6
        T6 --> T7["数学与机制上双重验证的最优解"]
    end

    PreTrain -.->|"拐点:参数扩展饱和"| TestTime