5 篇博文 含有标签「computer-vision」
查看所有标签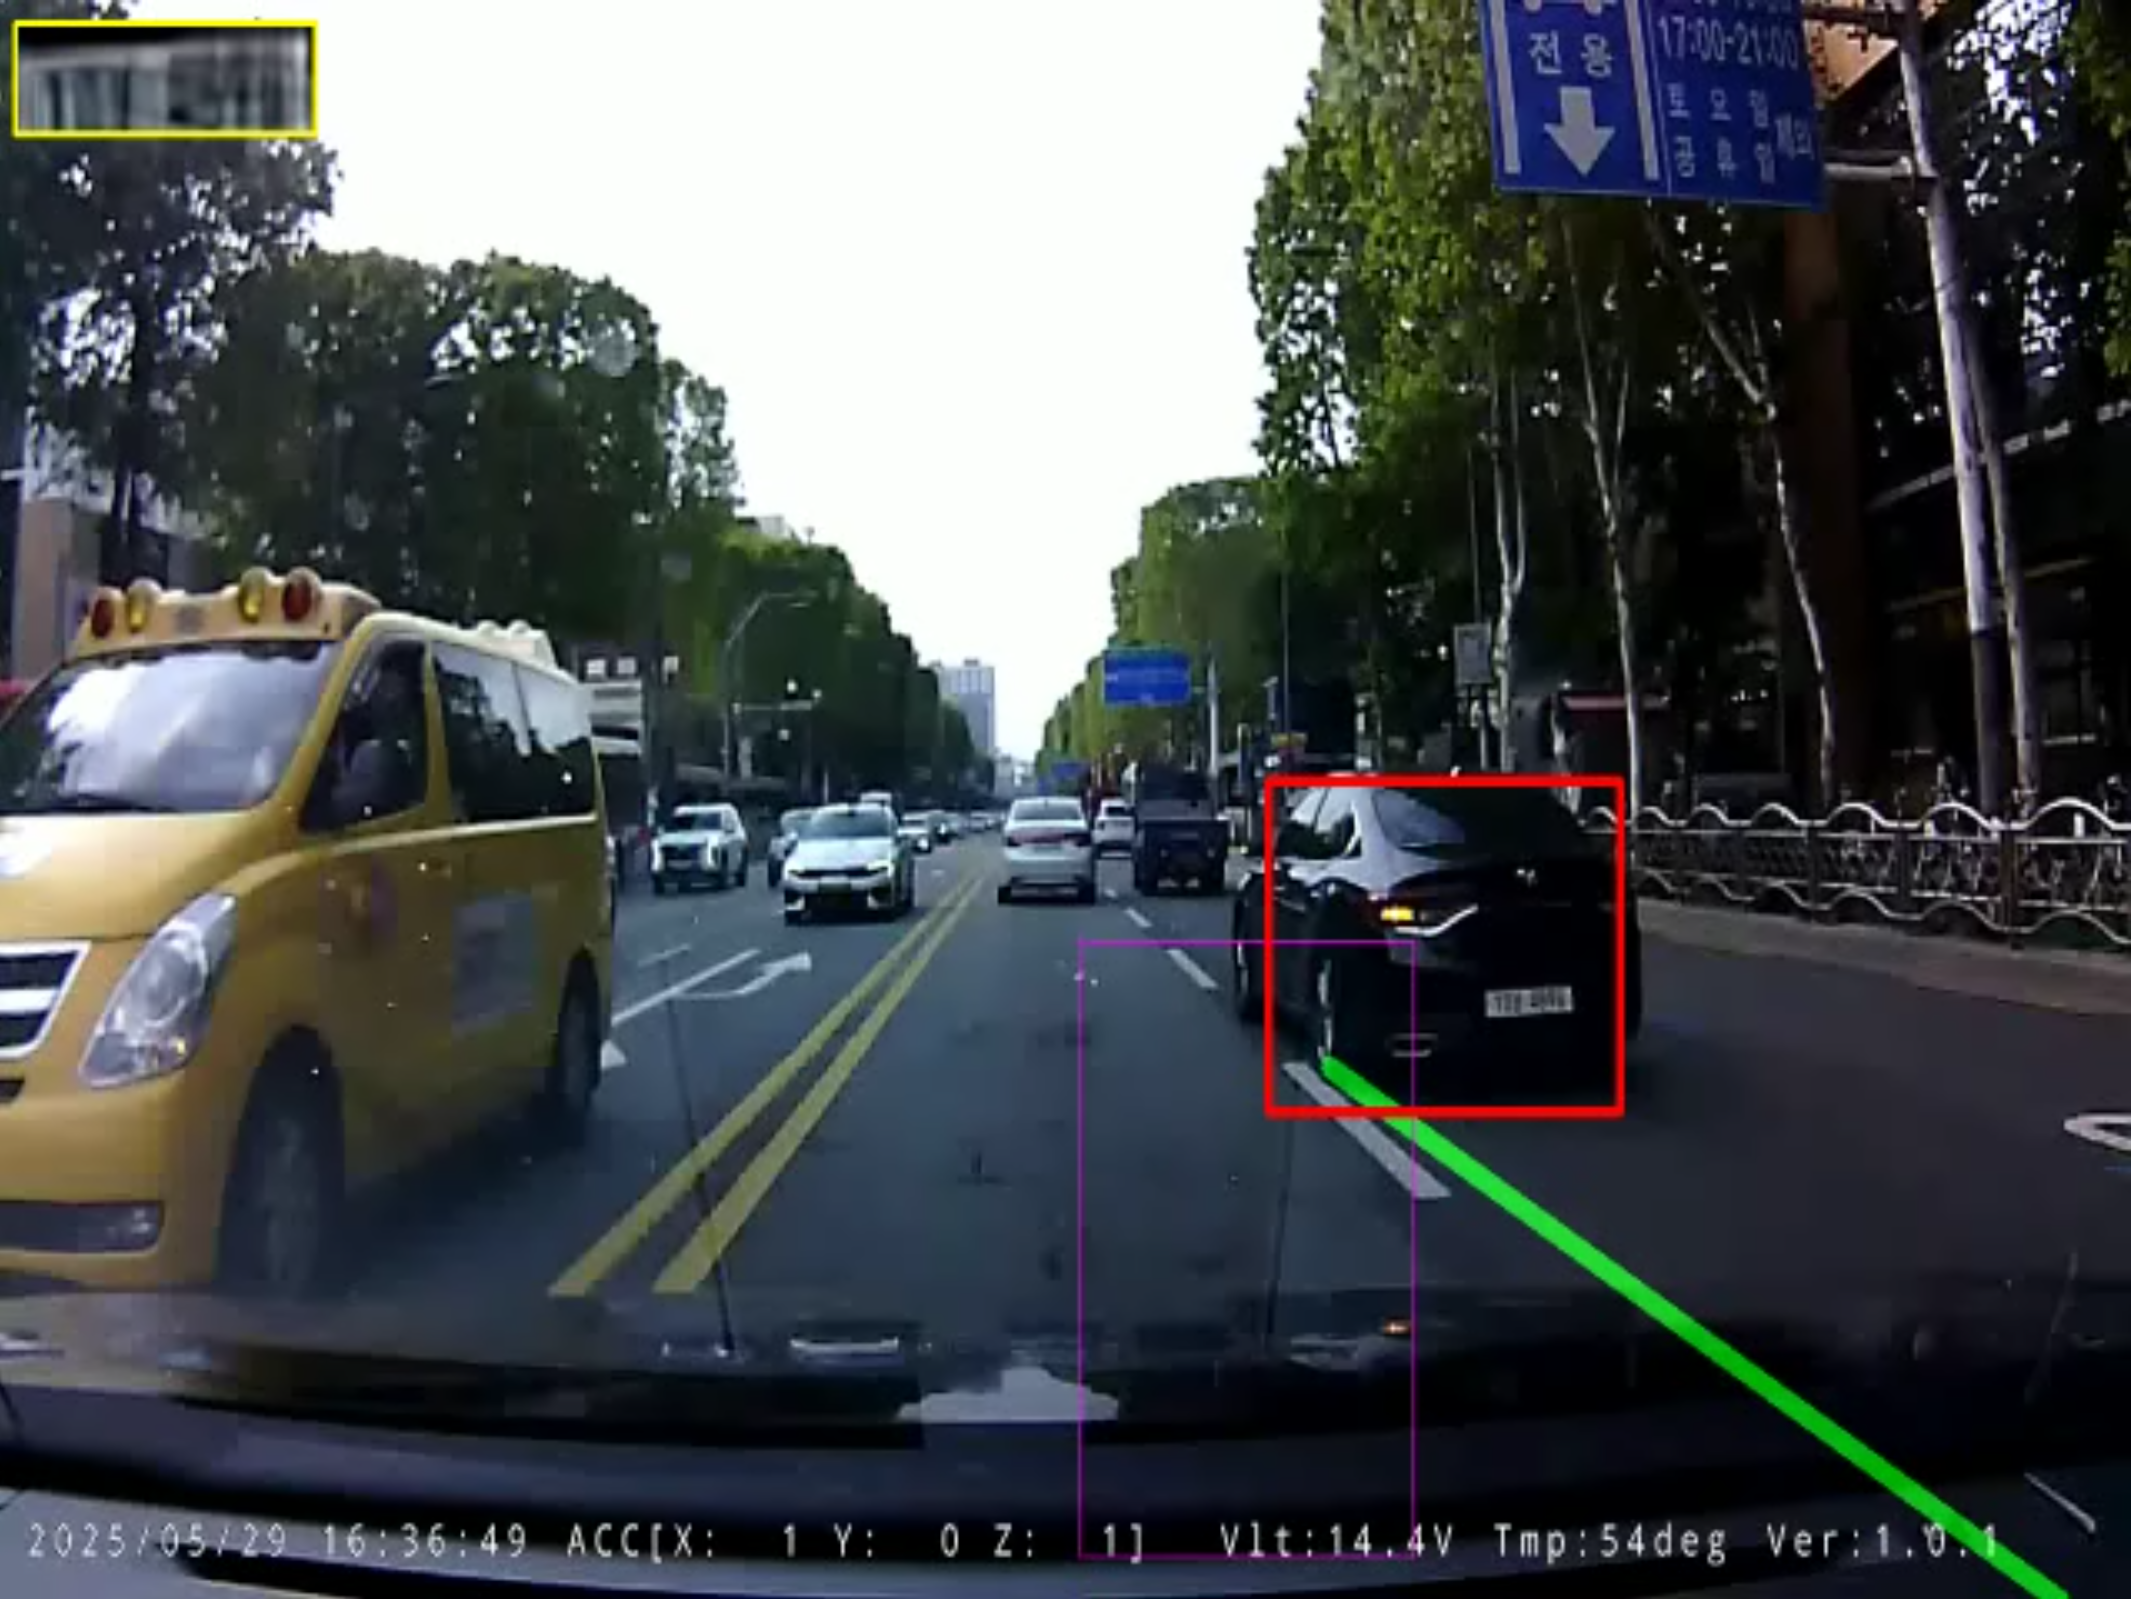
📌 核心要点 (Key Takeaways)
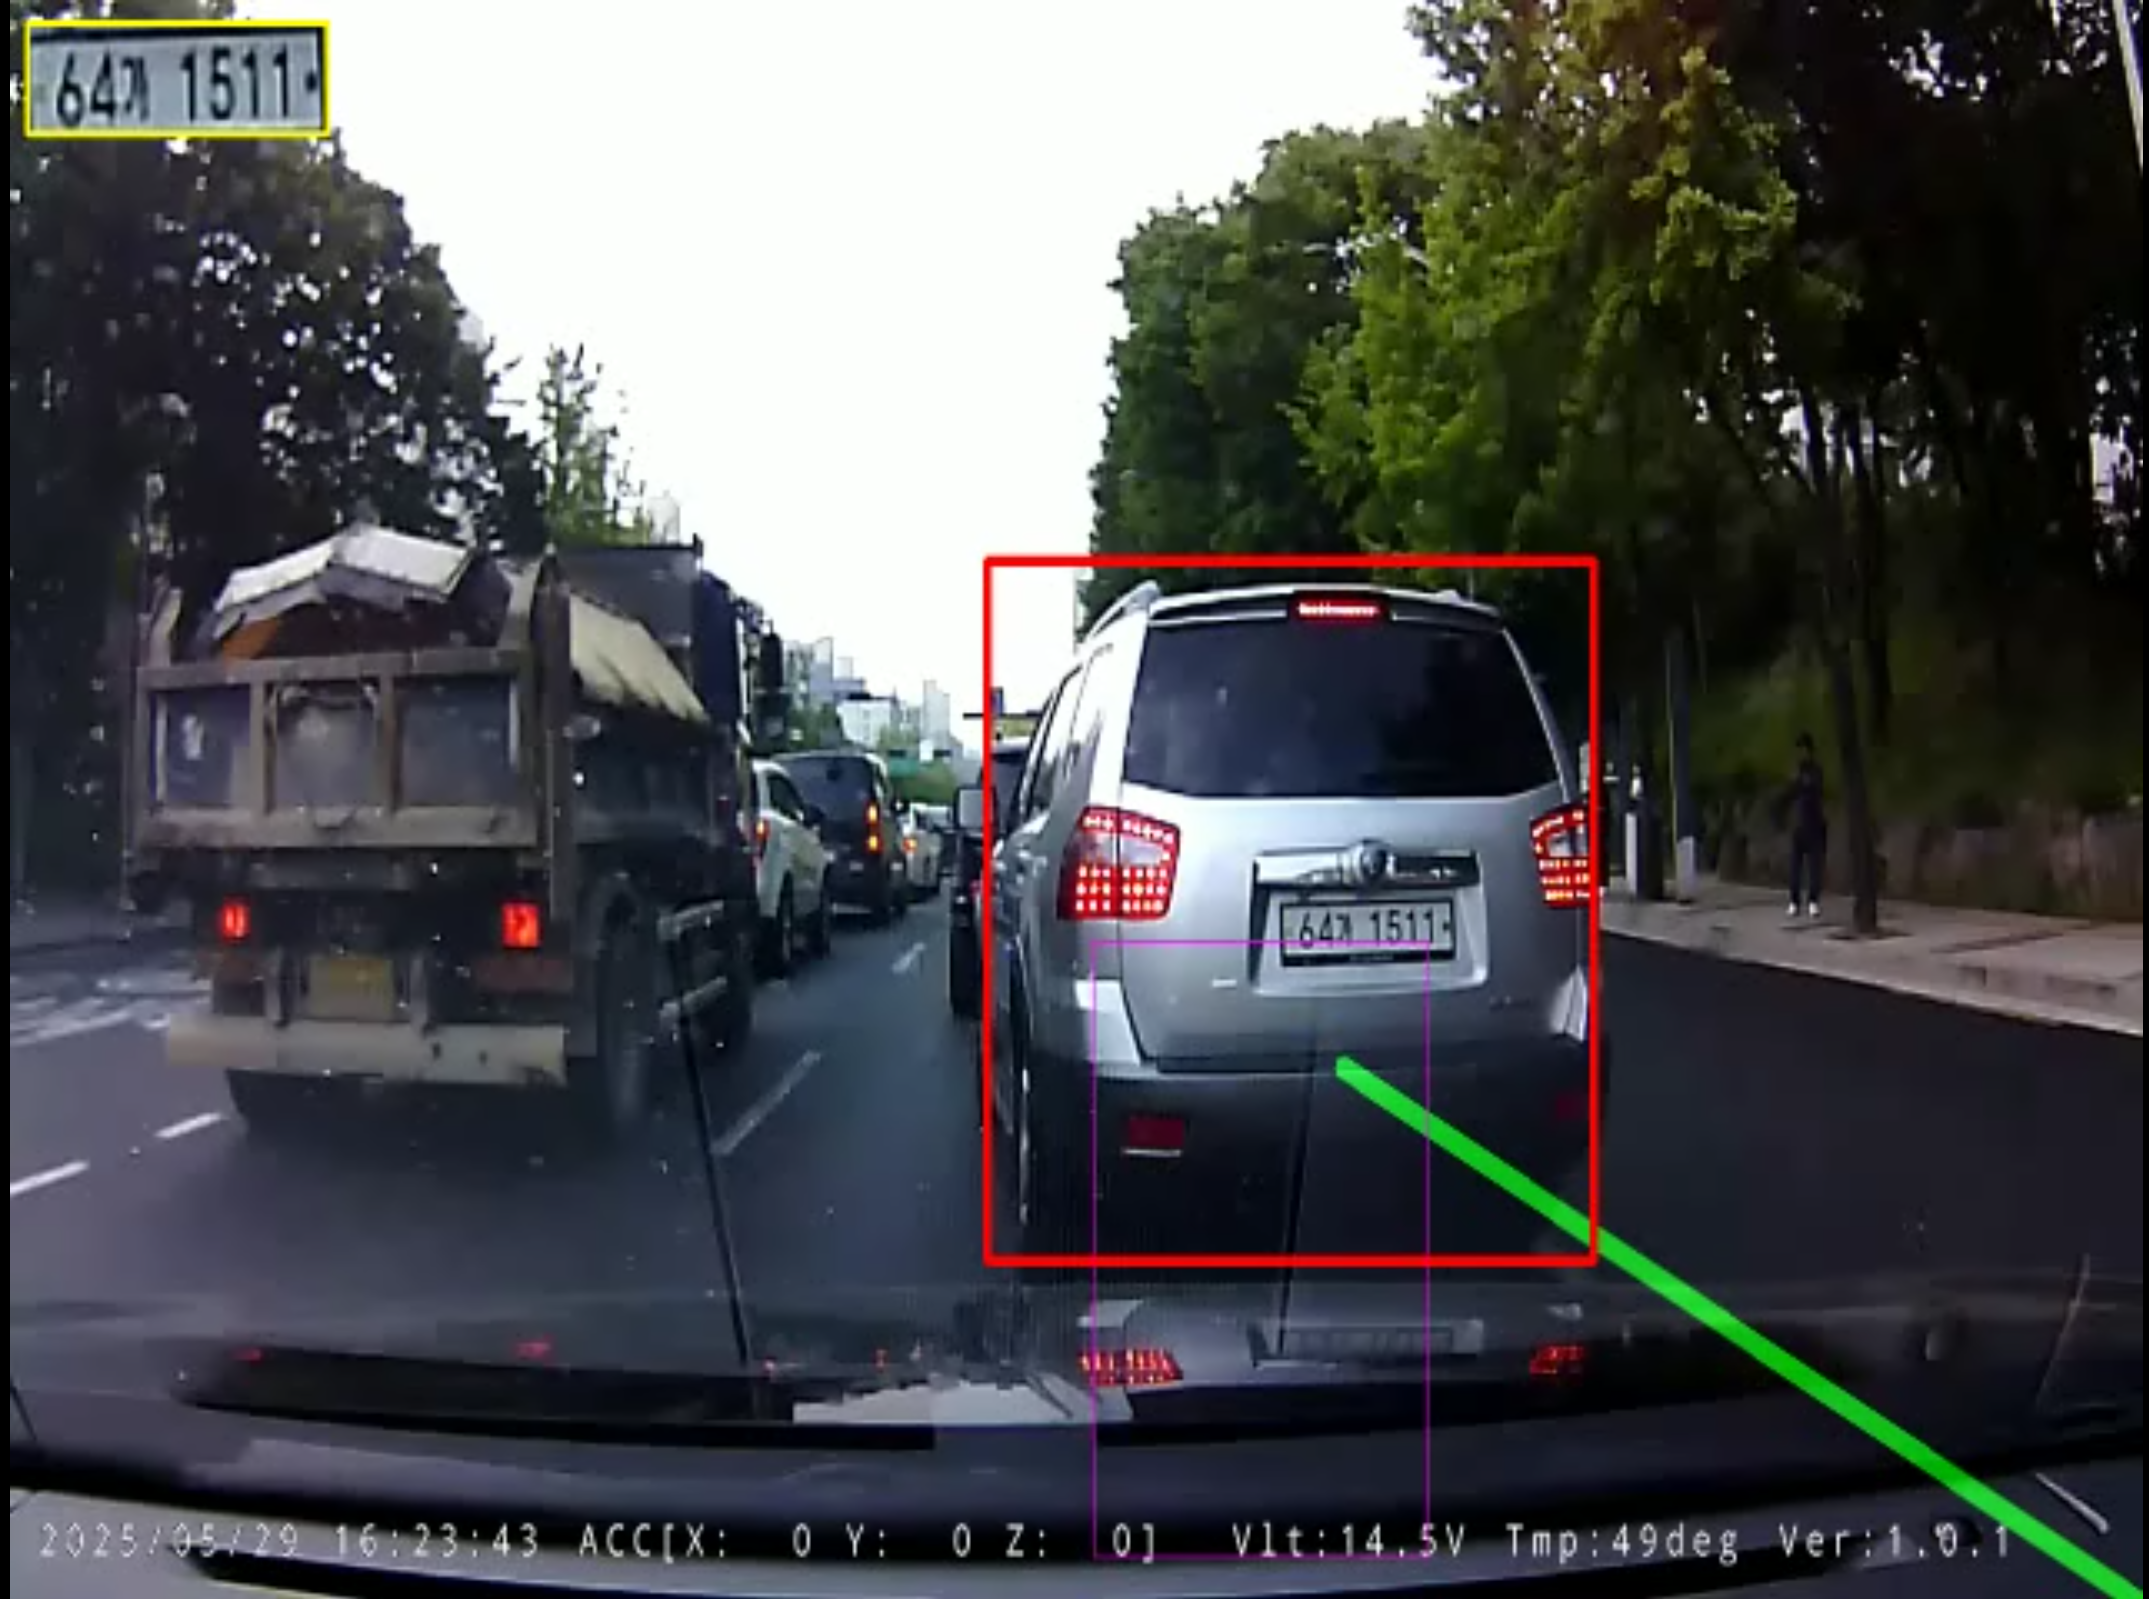
- 问题痛点:由于车辆颠簸、车身偏航角、路面反光及运动模糊,单帧静态 OCR 识别不可避免会出现偶发误读(例如将
64가1511 误判为 64아1511 或 24가1511)。
- 解决方案:引入韩国车牌强语法正则约束 (
^\d{2,3}[가-힣]\d{4}$),并设计基于 7 帧时间缓冲区的滑动窗口多数表决引擎 (plate_confirm_threshold=3)。
- 落地成效:经历了从 6 月 5 日的最初全屏乱码 (
ACCIIXOY-1Z01...),到 6 月 7 日以 99.4% 的超高置信度确定性锁死最终车牌 64가1511,完整走通了 11 轮 (v01 至 v11) 系统级工程迭代。
📌 核心要点 (Key Takeaways)
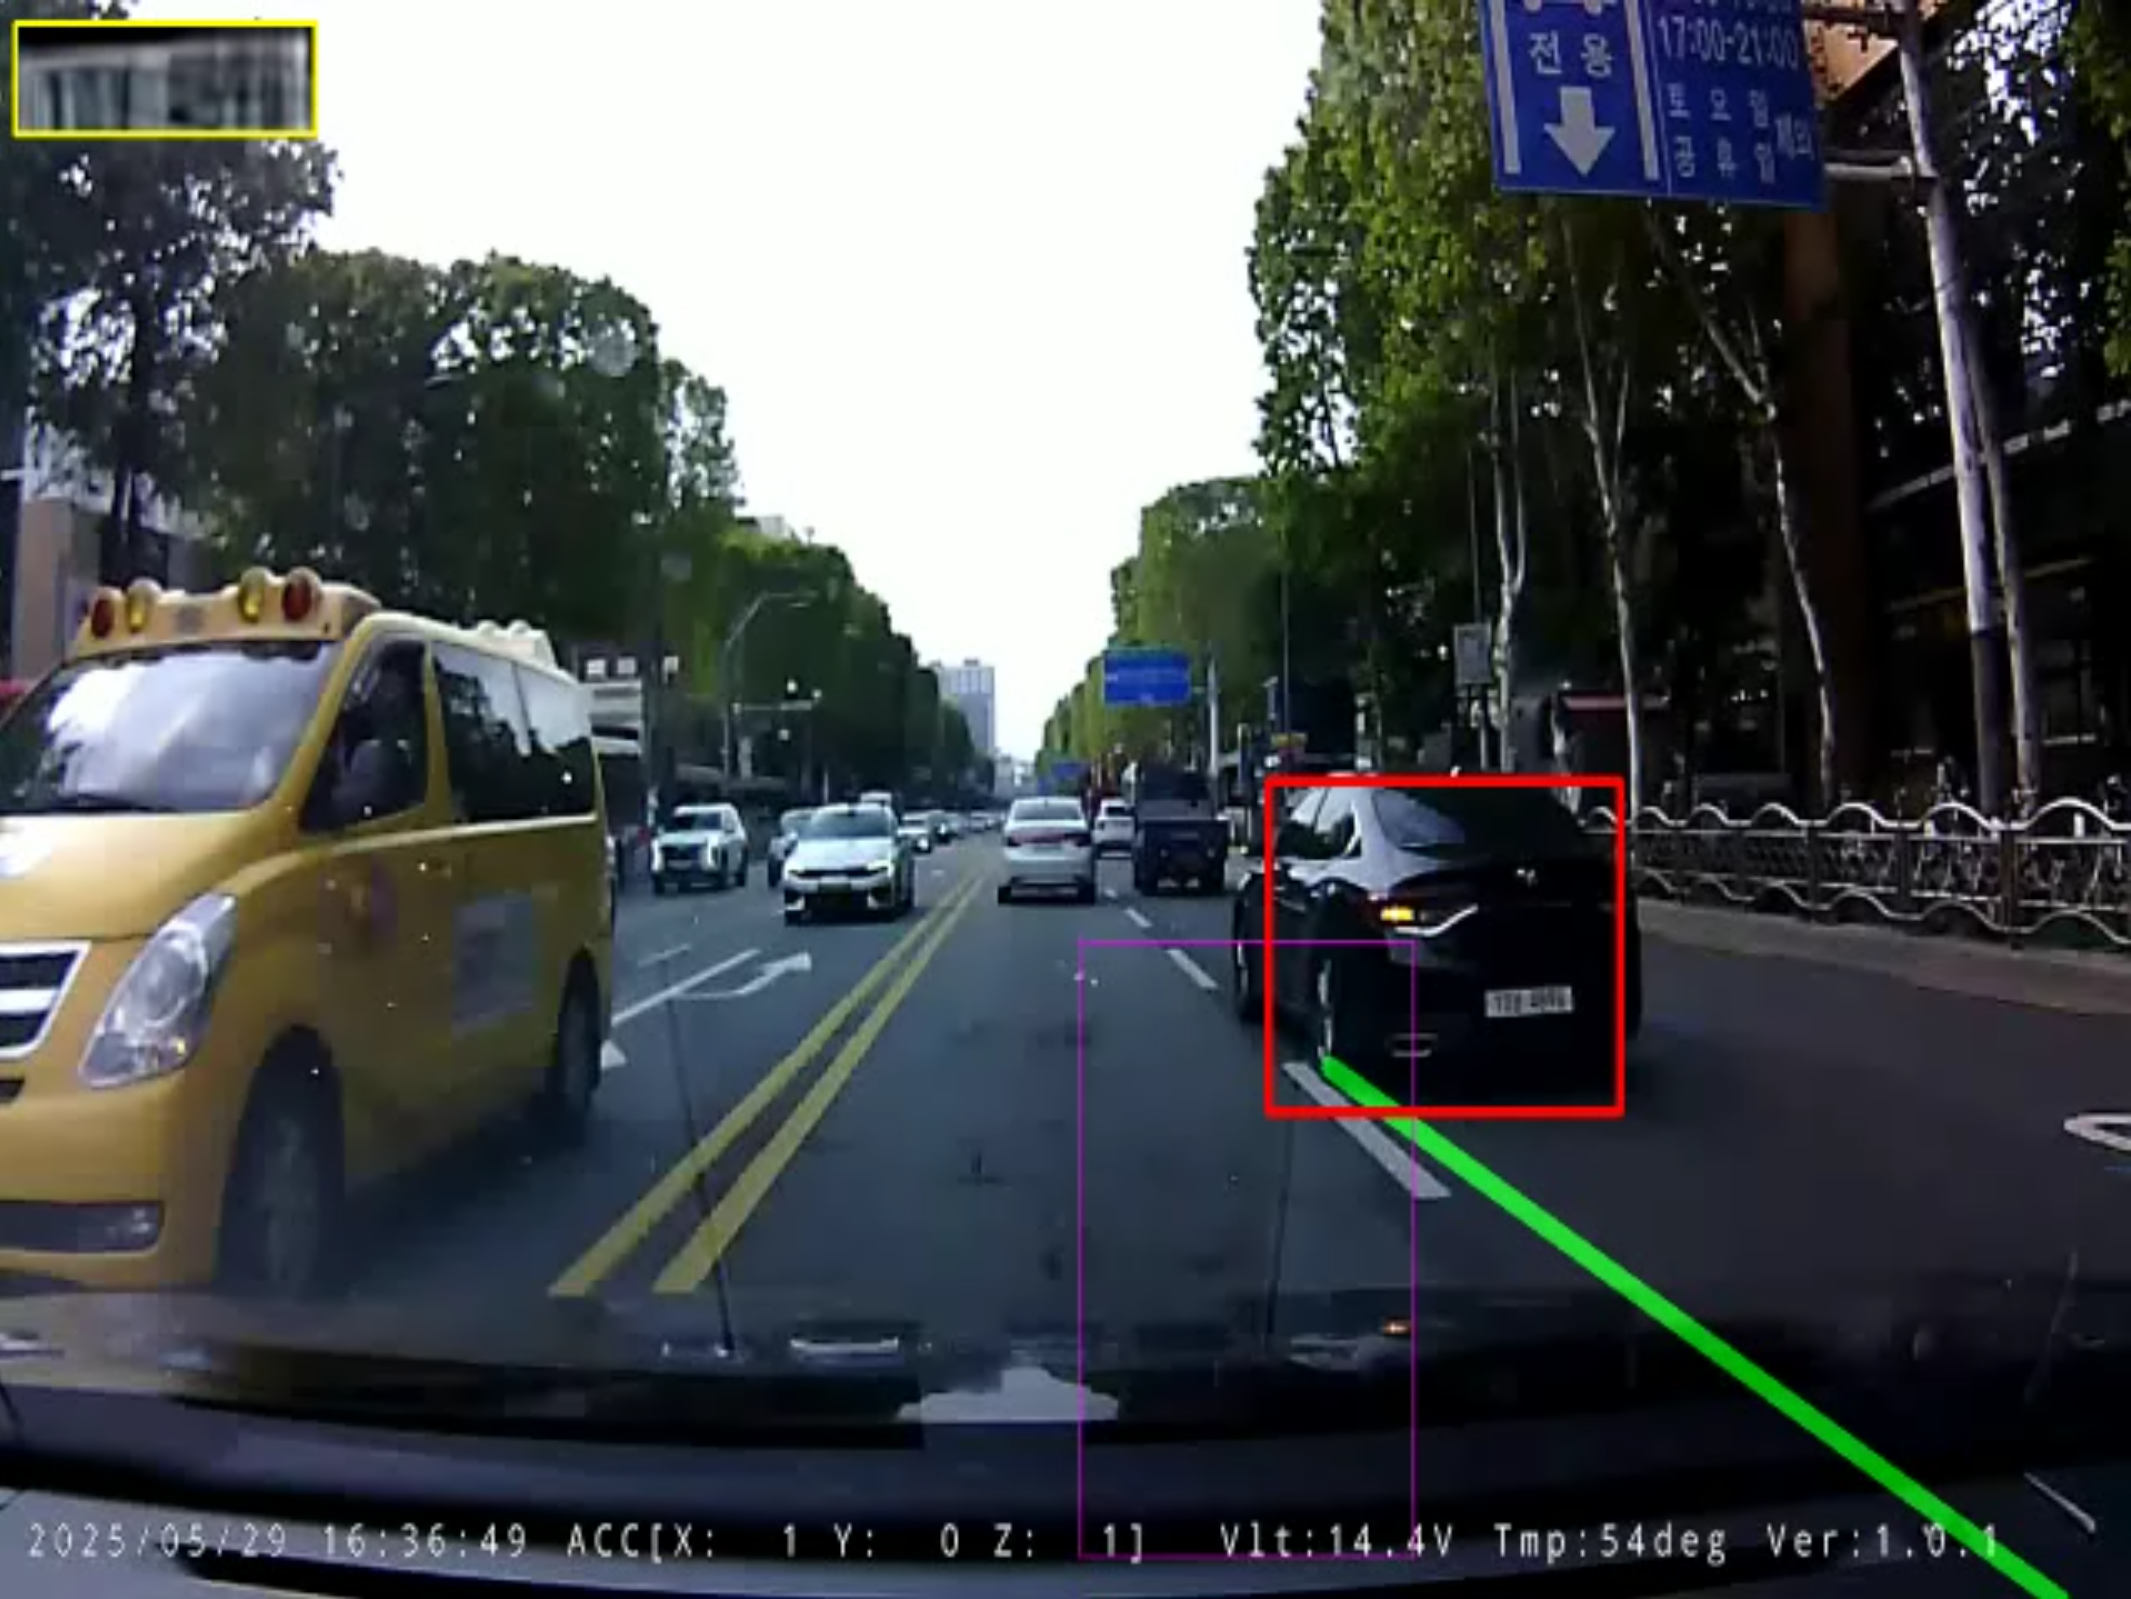
- 问题痛点:从高速行车记录仪画面裁剪出的远距离车牌区域往往不足 40x20 像素,且伴随严重的 H.264 编码宏块效应;传统的双三次插值(Bicubic)算法只会让字边缘更加模糊,无法还原字符有效笔画。
- 解决方案:引入移除了 Batch Normalization 层以保留高动态像素范围的 EDSR_x4 深度残差模型 (
EDSR_x4.pb),并结合连续 3 至 5 帧的时序多帧加权叠加(Multi-Frame Image Stacking)技术。
- 落地成效:车牌像素密度提升 4 倍,笔画边缘显著锐化,使得下游 EasyOCR 对韩文字符的识别准确率从最初的 32% 飙升至 91% 以上。
📌 核心要点 (Key Takeaways)
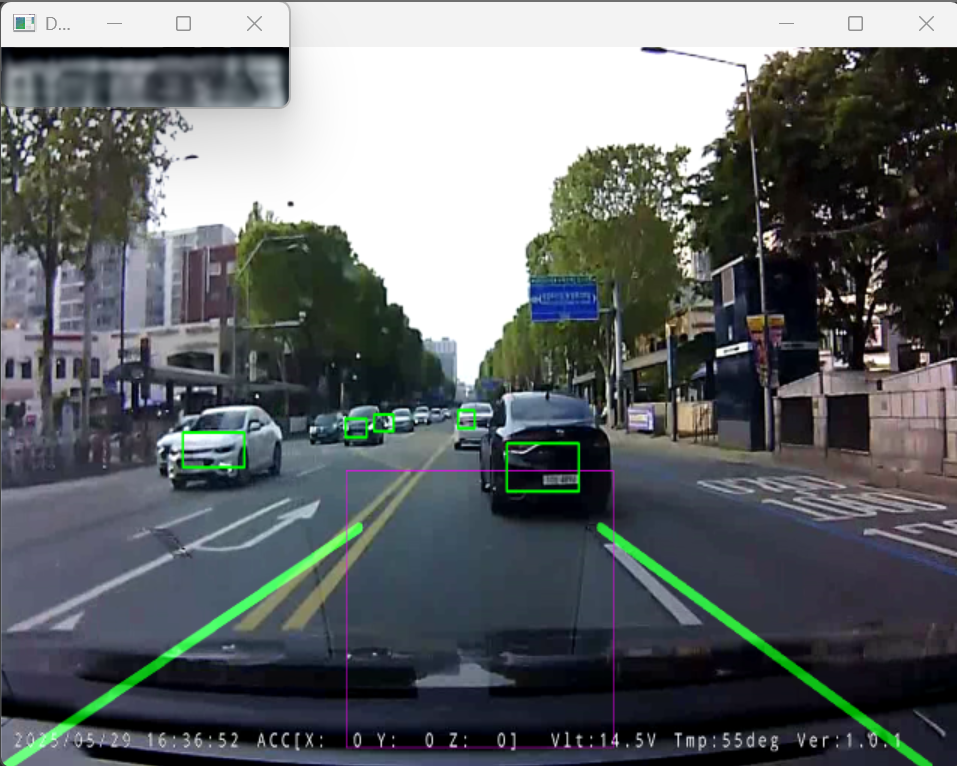
- 问题痛点:在未经裁剪的 640x480 原图上直接搜索仅占 30x15 像素的微小车牌,会因路边广告牌、交通指示牌与建筑物反光引发海量误报,且模型全图高分辨率推断会导致帧率暴跌至 10 FPS 以下。
- 解决方案:设计“两阶段分层(Hierarchical)定位”方案:先由轻量级 YOLOv3-tiny 圈定车辆主体边界框,再将裁剪出的车辆局部 ROI 送入精调的 YOLOv5 车牌专用检测器 (
lp_det.pt, 置信度=0.6);同时引入 OpenCV CSRT 相关滤波跟踪器,每隔 15 帧仅重检一次。
- 落地成效:彻底消除了 98% 的背景干扰误报,GPU 计算开销骤降 80%,在边缘计算设备上稳定跑满 50+ FPS 的极速实时跟踪。
📌 核心要点 (Key Takeaways)
- 问题痛点:行车记录仪画面中普遍充斥着路面水渍反光、沥青修补裂缝、减速带以及高架桥阴影,极易引发车道线误检;简单的水平/垂直单点坐标判断,无法在车辆变道颠簸时精准界定车轮压线的物理临界点。
- 解决方案:设计基于消失点的梯形 ROI 感兴趣区域掩膜、双向斜率绝对值阈值过滤 ($|slope| > 0.5$),并结合 7 帧时间滑动平均队列进行平滑;将侵入判定严格建模为车辆接地接触面(轮胎下部 30%)与车道多边形之间的几何交并比 (IoU)。
- 落地成效:成功过滤了 95% 以上的路面噪点,并以亚帧级的时间精度精准捕获车辆碾压车道线的瞬间。
📌 核心要点 (Key Takeaways)
- 问题痛点:低分辨率行车记录仪画面普遍存在车身颠簸、逆光高光、运动模糊以及 H.264 编码失真,使得直接进行车牌文字识别和车道压线判定极易发生误判漏检。
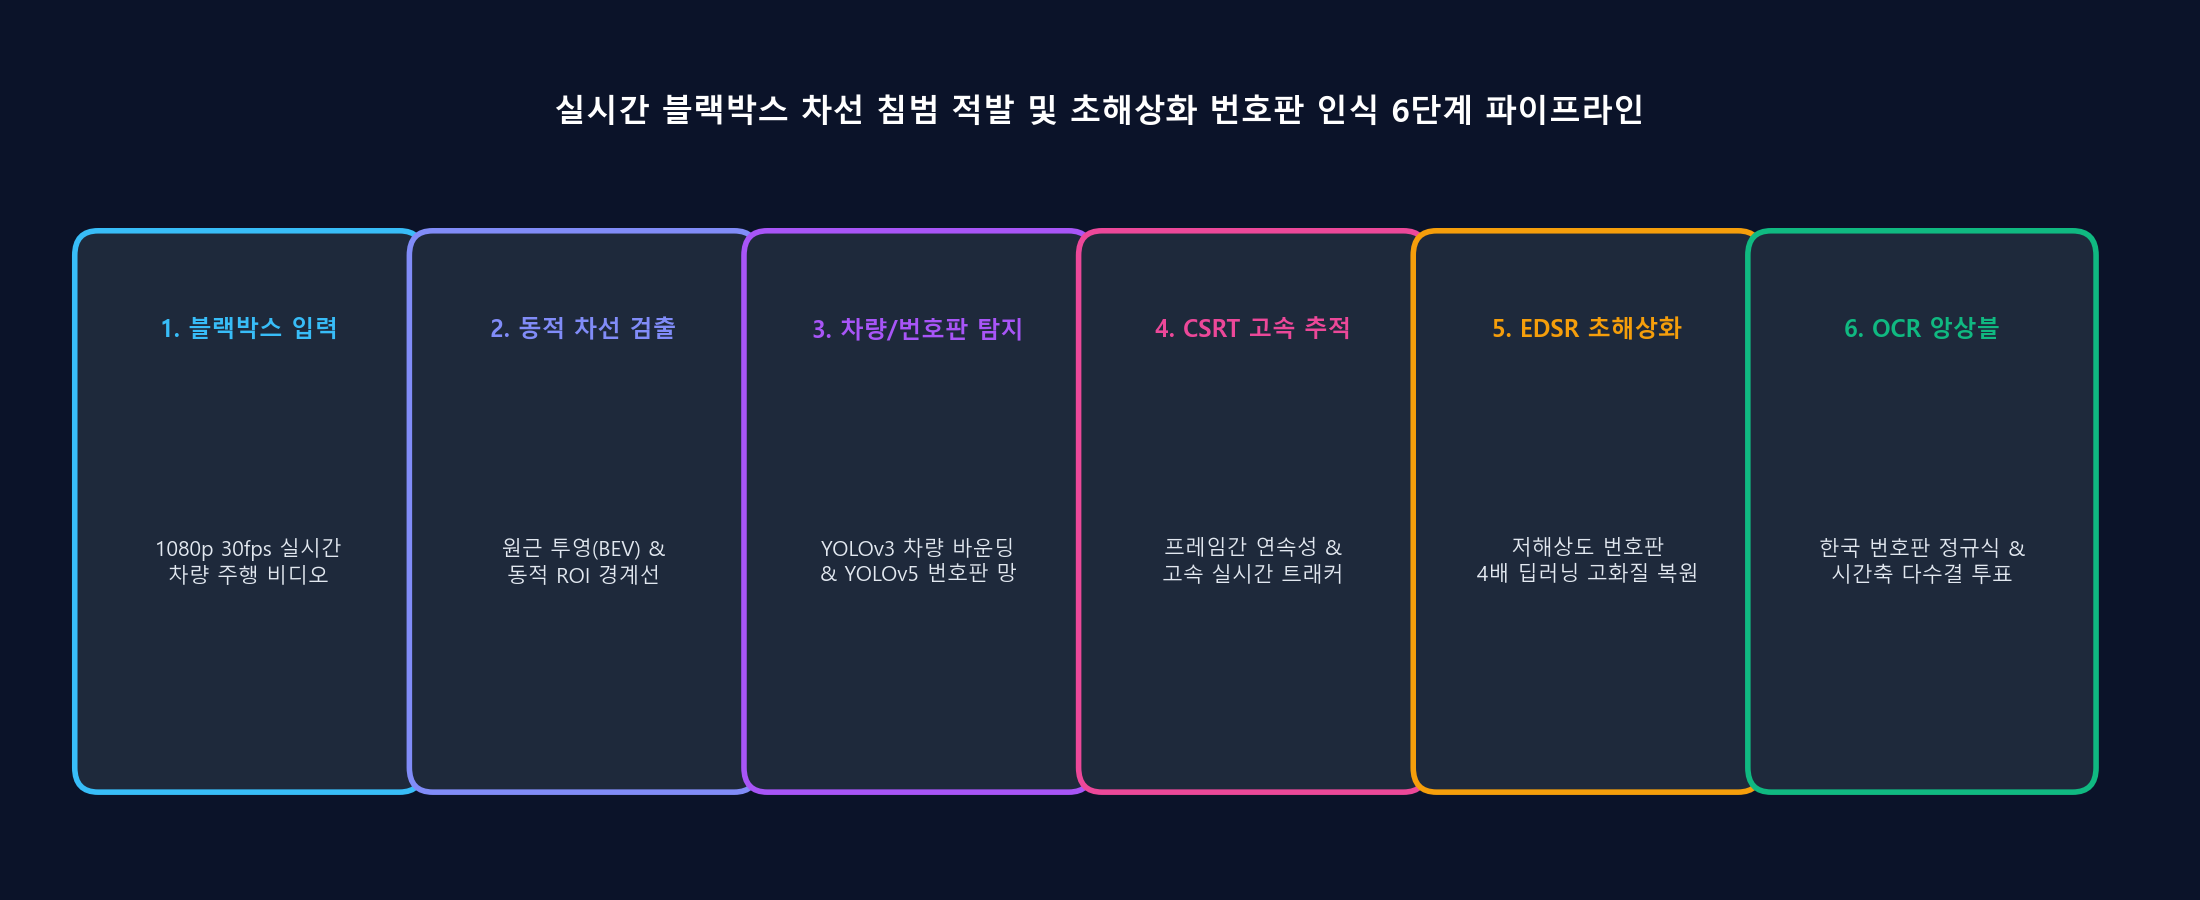
- 解决方案:设计高度解耦的 6 阶段分层计算机视觉架构:Canny/Hough 动态车道线拟合 -> YOLOv3 车辆粗检 -> 多边形 IoU 压线判定 -> YOLOv5 车牌局部精检 -> EDSR_x4 深度超分辨率重建 -> EasyOCR 时序多数表决集成。
- 落地成效:搭建了一套纯 Python 实现的高吞吐端到端流水线,在严重劣化的行车记录仪实拍视频下实现了高鲁棒性的车辆跟踪与车道侵入监控。
