[Webots 机器人] evaluate_qlearning:确定性导航定量评估与 DQN·SARSA 对比基准 (#4)
· 阅读需 5 分钟

📌 核心要点 (TL;DR)
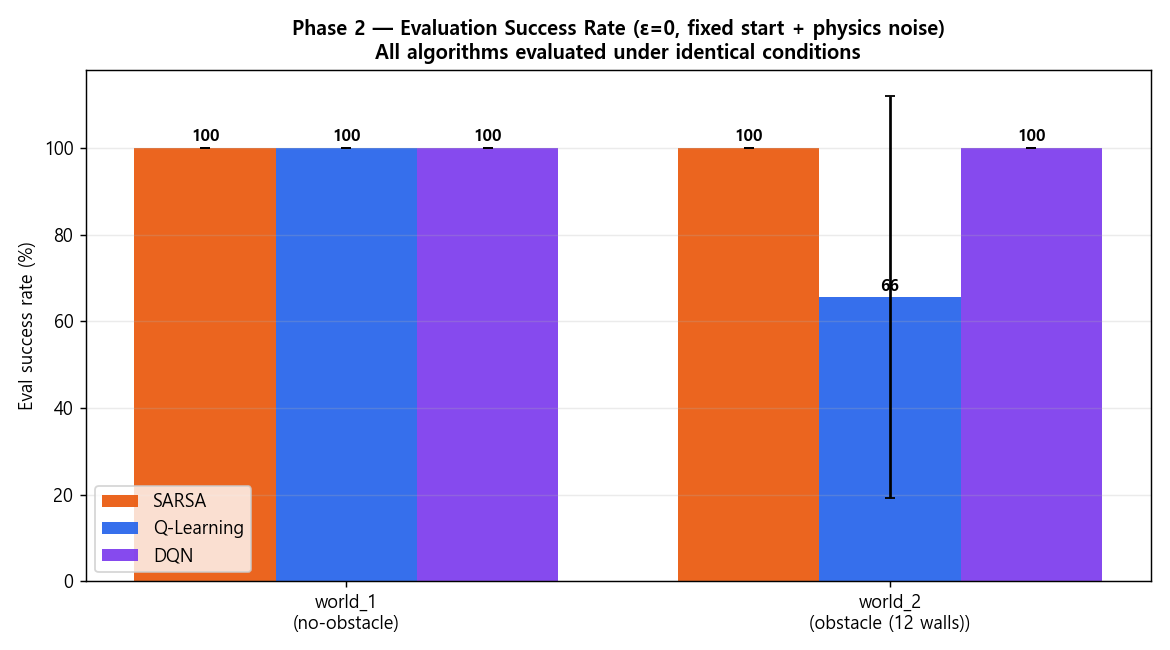
- 目的 (Objective):在完全关闭训练探索噪声 (ε=0) 的纯确定性策略 (Greedy Policy) 下,验证策略在真实部署环境中的自律导航可靠性与路径质量。
- 评估方法 (Evaluation):通过
evaluate_qlearning.py脚本,在 5 组独立测试随机种子 (Eval Seeds 0~4) 上执行共计 30 轮评估,严密监测成功率、理论最短路径比率 (Path Efficiency) 及接近障碍险情 (Near-miss) 频次。- 实验结果 (Result):表格型 Q-Learning 在 12 墙障碍地图中斩获 93.3% 的确定性到达成功率,且单步推理延迟仅为 0.02ms,在执行效率与轻量化上显著优于沉重的深度神经网络 DQN 与保守的在线学习 SARSA。