[Stanford CS329A #6] 训练期扩展与强化学习:DeepSeekMath、GRPO与大规模推理优化
· 阅读需 17 分钟

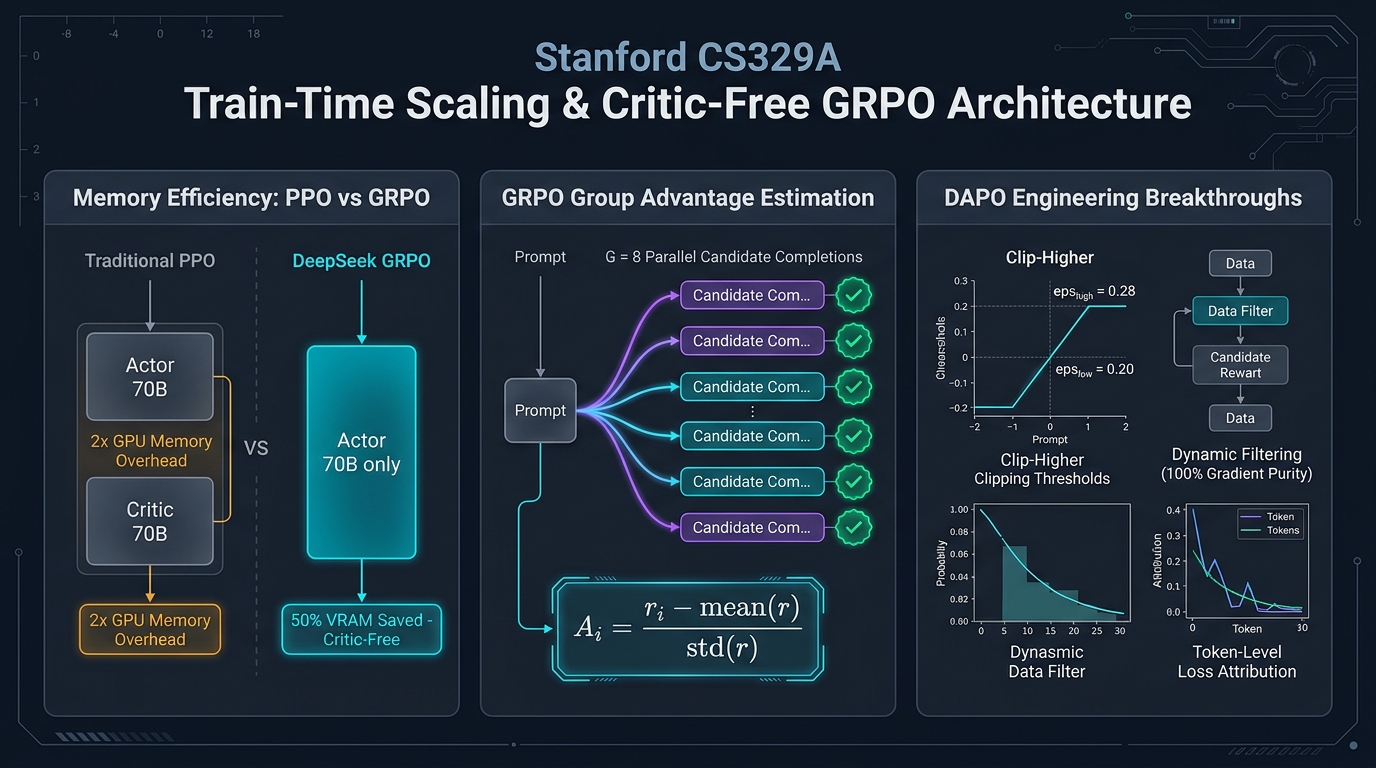
欢迎来到斯坦福大学2025秋季最新研究生课程——**CS329A: Self-Improving AI Agents(自主进化AI智能体)**的第六篇深度工程解析。
在第1讲至第5讲(Part 1: 基础理论篇)中,我们全面剖析了如何对已经预训练完成并处于冻结状态的模型,通过注入测试期算力(Test-time Compute)来榨取性能极限:构建 MCTS 搜索树、结合编译器报错自纠错,以及使用弱验证器集成过滤最优答案。
然而,我们必须直面残酷的数学现实: 给一个小学生在考场上多留十分钟思考,他能够证明大学高等微积分中的定理吗?如果模型本身的神经网络突触(权重参数,$\theta$)内部从未编码过该概念与推理逻辑,那么无论是采样一万次还是展开庞大的波束搜索,产出的都不是真正的智能,而仅仅是随机概率下的侥幸。
今天正式开启的 Part 2: Training & Evolution(训练与自主进化篇,第6讲~第9讲),正是直击这一核心命题:
“与其在每次推理时耗费昂贵算力进行外挂搜索,为什么不在训练期(Train-time)倾注海量算力,将模型的神经突触与参数权重永久性地淬炼为顶尖推理专家?”
在第6讲中,我们将深度解构破除人工标注枷锁、催生现代顶尖推理模型的**后训练强化学习(Post-Training RL)**三大核心支柱:
- 用自我生成的推演过程教会自己的自举范式: STaR(Self-Taught Reasoner, Zelikman et al., Stanford 2022)
- 彻底消灭 Critic 价值网络的强化学习革命: DeepSeekMath 与 GRPO(Group Relative Policy Optimization, 2024)
- 千卡 GPU 集群实战工程秘诀: DAPO(Decoupled Clip & Dynamic Sampling, 2025)
flowchart TD
    subgraph ParadigmShift ["范式巨变:推理期算力 vs 训练期算力"]
        direction TB
        TestTime["Part 1: 推理期扩展 (Test-Time Scaling)<br/>• 神经网络权重冻结 (θ = 常数)<br/>• 外挂运行时搜索 (MCTS, ReAct, RLEF)<br/>• 极高的响应时延与高昂的服务端推理成本"]
        --> TrainTime["Part 2: 训练期扩展 (Train-Time RL)<br/>• 梯度下降主动优化网络参数 (θ ← θ + Δθ)<br/>• 强化学习将深层战略规划直觉刻入突触<br/>• 生产环境单次前向传播 (Single-Pass) 极速推理"]
    end

    subgraph RLEvolution ["数学推理强化学习三大进化里程碑"]
        direction TB
        M1["STaR (斯坦福 2022)<br/>• 仅收集自身答对的推演过程进行监督微调<br/>• 事后合理化 (Rationalization): 逆向搭建推理逻辑桥梁<br/>• 6B 参数模型在 CommonsenseQA 媲美 175B 的 GPT-3"]
        --> M2["GRPO (DeepSeekMath 2024)<br/>• 彻底砍掉 Critic 价值模型 (GPU 显存占用直接腰斩)<br/>• G 个输出成组归一化 Z-score 计算优势值 Advantage<br/>• 7B 开源模型在 MATH 基准测试力克谷歌 540B Minerva"]
        --> M3["DAPO (工业级大规模开源 2025)<br/>• 非对称 Clip-Higher (0.28 vs 0.20) 遏制熵崩塌<br/>• 动态采样彻底过滤零方差无效批次<br/>• Qwen-32B 以一半训练步数打破 DeepSeek-R1-Zero 纪录"]
    end

    ParadigmShift ==> RLEvolution