[Maeumjigi 心语伴侣毕业设计开发日志 #9] Llama 3.1 领域微调实战排错与第 6 周中期答辩汇报
· 阅读需 3 分钟

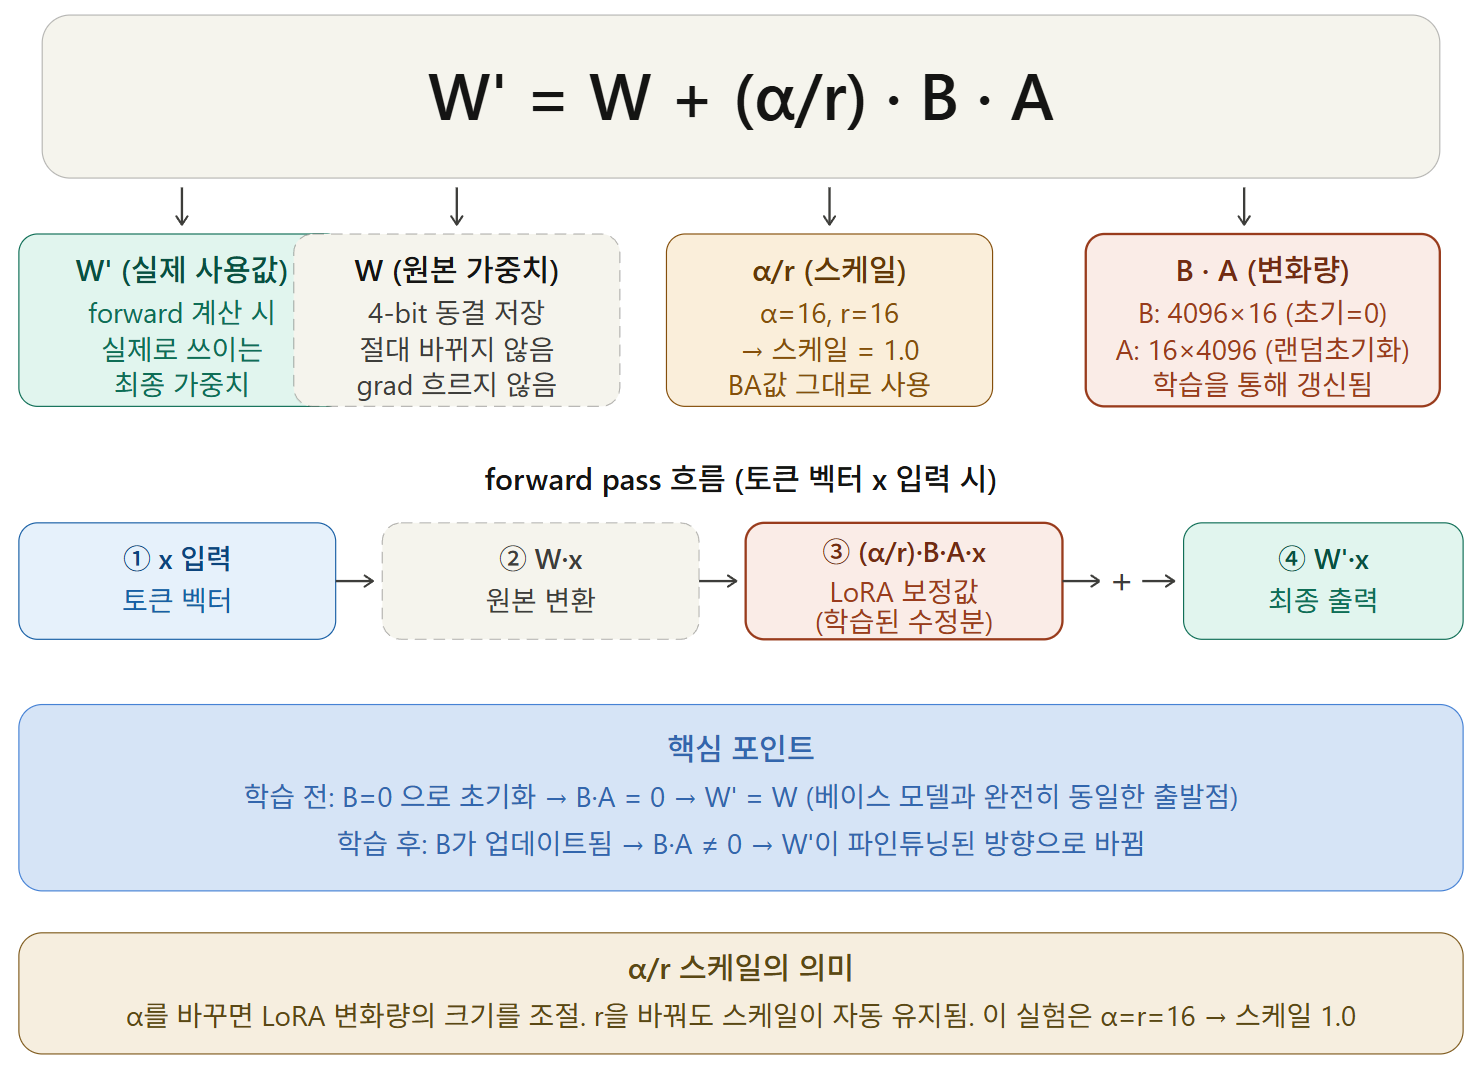
4 月 9 日,依托昨天完成的自动化 Notebook,我们终于迎来了人工智能大模型 (Llama 3.1) 的首轮正式微调训练。 然而现实充满荆棘,无数报错接踵而至。与此并行的,还有必须在深夜同步赶制第 6 周毕业设计中期答辩材料的极限挑战。
4 月 9 日,依托昨天完成的自动化 Notebook,我们终于迎来了人工智能大模型 (Llama 3.1) 的首轮正式微调训练。 然而现实充满荆棘,无数报错接踵而至。与此并行的,还有必须在深夜同步赶制第 6 周毕业设计中期答辩材料的极限挑战。
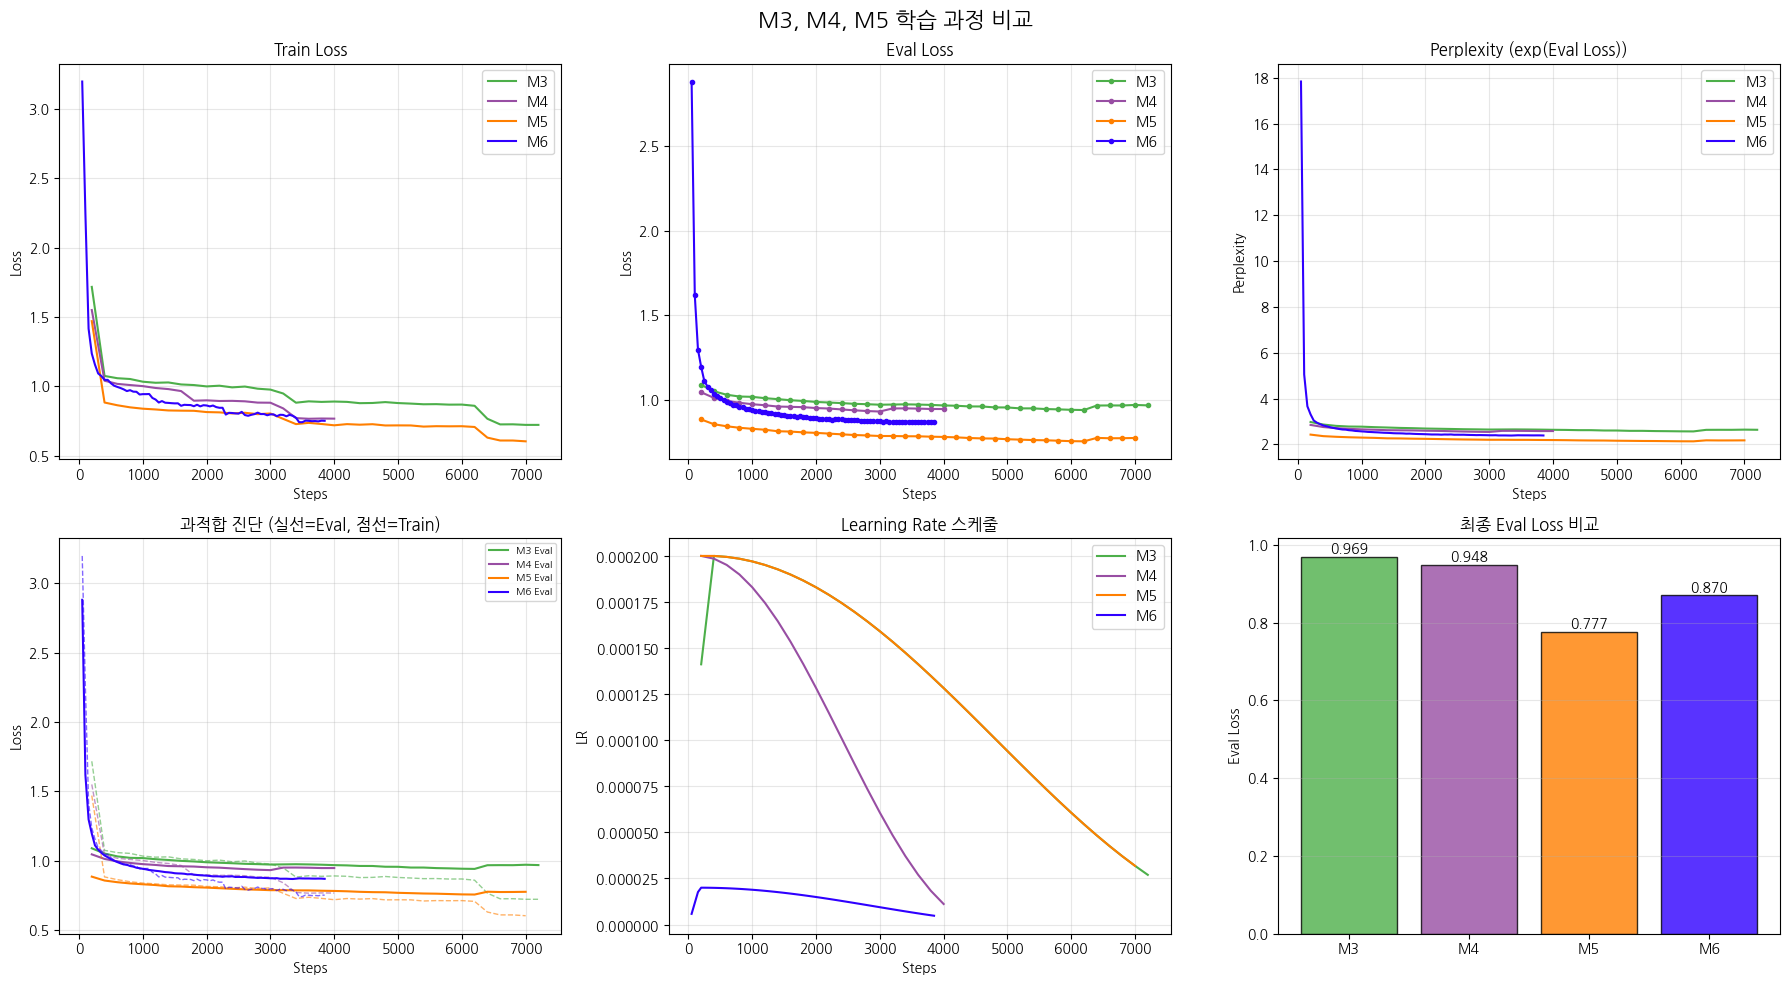
4 月 8 日,是我们在推进 Maeumjigi 项目期间经历的最严峻危机,也是令人哭笑不得的技术插曲——Claude API 达到月度配额上限与突发扣费账单危机。
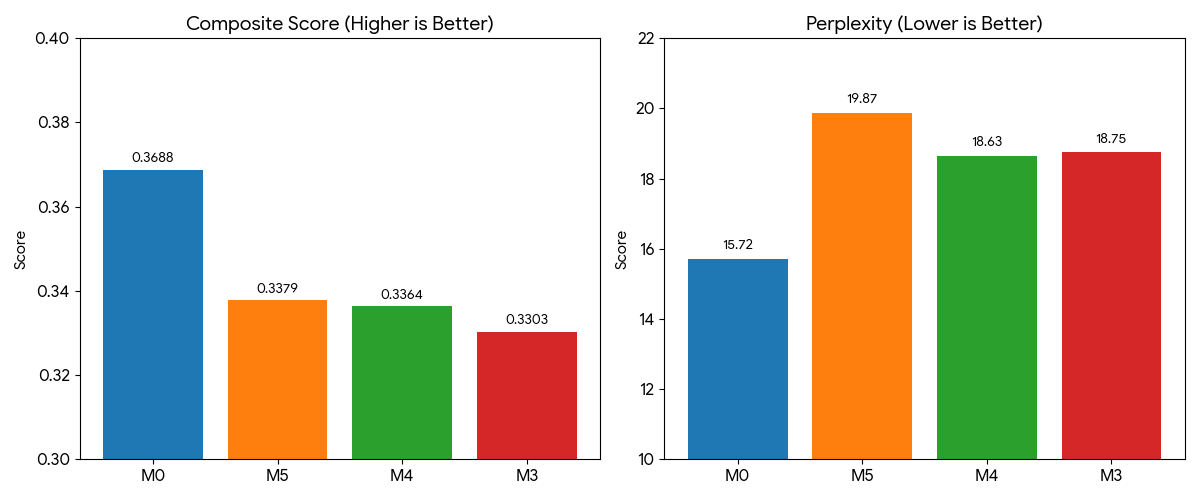
这是记录 4 月 3 日的开发实录。在这一天,我们正式启动了为深度学习大模型 (Llama 3.1) 喂养高品质心理对话语料的数据深度精炼工程。 这也是我们首次构建起由高级大语言模型 (Claude) 自主阅读上下文并高精度标注复杂情绪标签的庞大流水线。
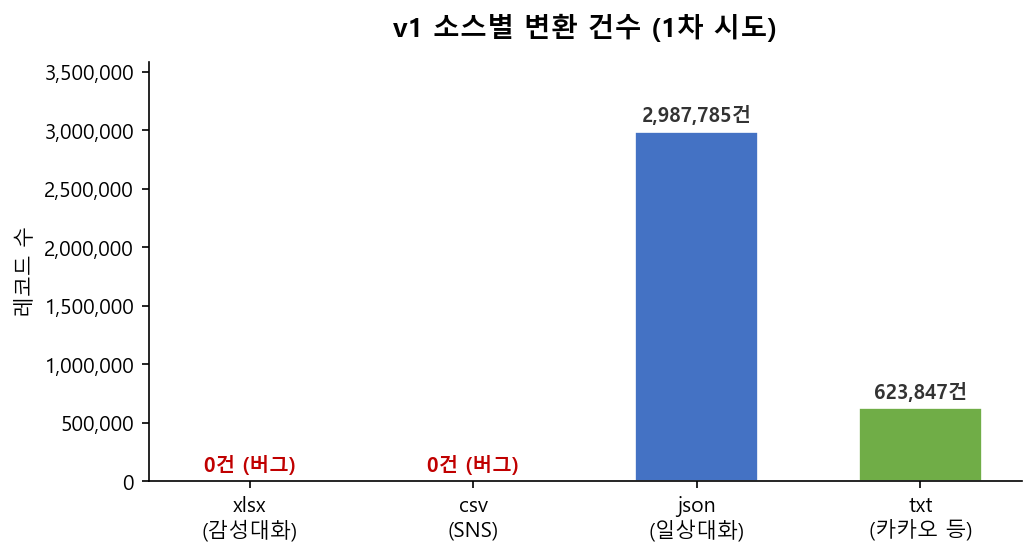
April 1, 2026, was the day our engineering team launched the automated preprocessing pipeline for the massive counseling corpora that would form the foundation of Maeumjigi. Training a high-performance open-source Large Language Model (LLM) like Meta Llama 3.1 requires rigorous data hygiene: converting unstructured multi-party dialogues into clean, token-bounded, and special-token-aligned instruction datasets.
这是记录 3 月 31 日的开发实录。在这一天,我们既对国防会议中心预约提醒 App 进行了 Android 端构建测试, 又正式启动了暗示项目将彻底转型为前沿 AI 项目的 Llama 3.1 领域微调数据预处理流水线。