[Stanford CS329A #3] 稳健答案验证:过程奖励模型(PRM)、集成与可扩展监督
· 阅读需 16 分钟

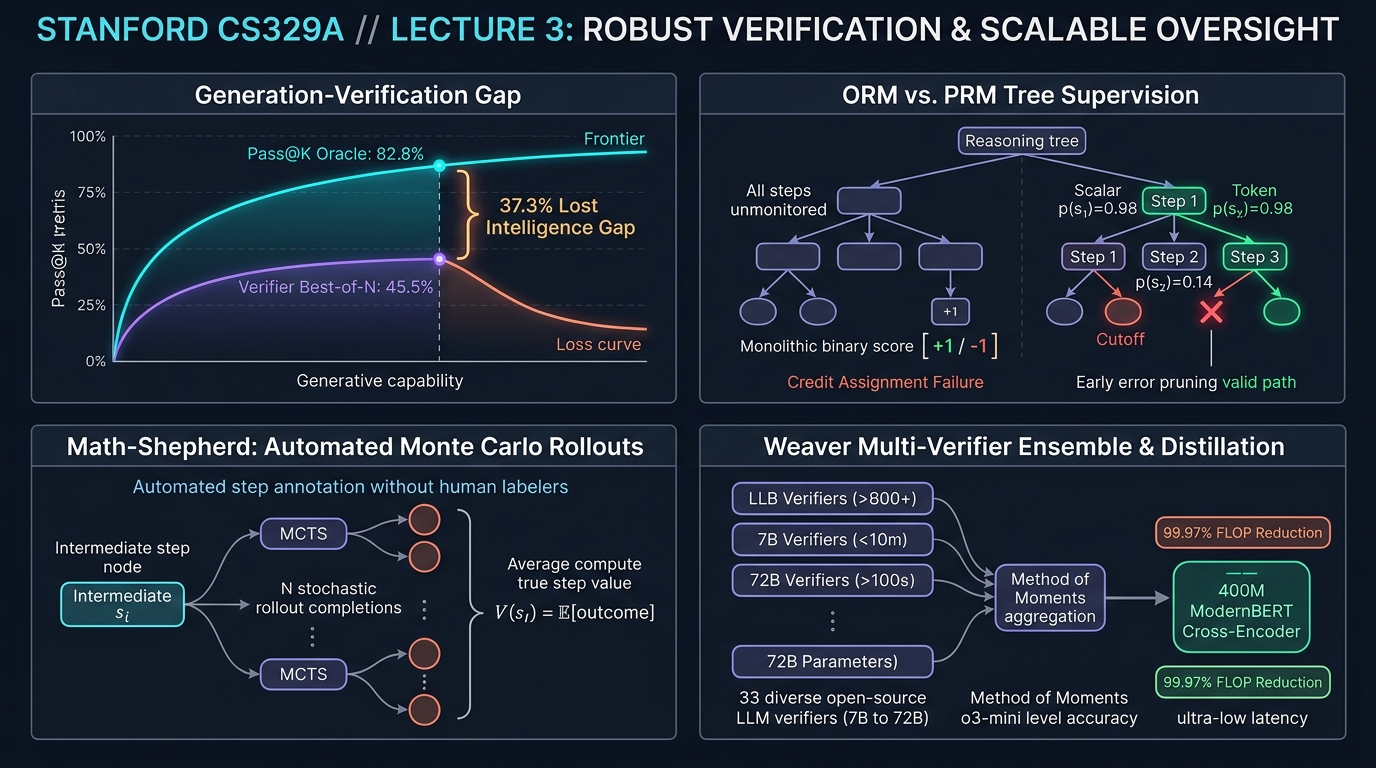
欢迎阅读斯坦福大学2025年秋季前沿研究生课程**CS329A: Self-Improving AI Agents(自我演进AI智能体)**的第三篇专业工程深度解析。
在上一讲(第二讲)中,我们系统剖析了推理时间计算缩放(Test-time Compute Scaling),并得出了一个深刻的结论:单纯让模型产生数千个候选答案($pass@k$)能够将理论上的覆盖率推向99%以上,但**“如果没有高精度的验证器(Verifier)从浩瀚的错误草垛中挑出唯一正确的绣花针,无论是多数投票还是盲目重抽样,模型性能都会迅速撞墙停滞”**。
今天第三讲所探讨的,正是解决这一致命瓶颈的核心系统级工程:稳健答案验证(Robust Verification)。
人类数学家或软件工程师在解决复杂课题时,绝不会凭空一笔画出完美推导;他们写下一行演算,复核代数合理性,捕捉正负号的笔误,并在误入歧途前及时回溯(Backtracking)。相反,标准的自回归语言模型只能向未来单向输出标记。一旦初始推理发生轻微偏差,模型为了自我圆谎,便会在此基础上炮制出越来越荒谬的幻觉(Hallucination)。
那么,“我们能否训练独立的验证模型,对生成模型每一步的中间推理进行逐行严格质检,提前修剪死胡同?”
从OpenAI的奠基之作Cobbe GSM8K验证器,到Lightman的分步过程监督(PRM800K),再到无需人类标注、基于蒙特卡洛自动扩展打分的Math-Shepherd,以及最新通过统计物理矩估计法集成33个弱验证器达到o3-mini水准的Weaver(NeurIPS 2025),我们将系统拆解并掌握验证器工程(Verifier Engineering)的最前沿技术。
flowchart TD
    subgraph Gap ["核心痛点:生成-验证差距 (Generation-Verification Gap)"]
        direction TB
        G1["Pass@100 理论上限: 82.8% (生成端上限)"]
        G2["多数投票法实际提取率: 45.5% (实际提取效果)"]
        G1 -.->|"选别失败导致损失 37.3%p 潜在智能"| G2
    end

    subgraph Solutions ["答案验证系统的四代演进路径"]
        direction TB
        S1["结果奖励模型 (ORM)<br/>• 仅针对最终答案给出二元打分 (+1 / -1)<br/>• 信用分配失效 (Credit Assignment Failure)"]
        --> S2["过程奖励模型 (PRM800K)<br/>• 标记级分步监督打分 p(step_i)<br/>• 早期错误感知即刻剪枝与概率乘积评估"]
        --> S3["Math-Shepherd (无监督MCTS扩展)<br/>• 无需人类标注的自动蒙特卡洛分步标注<br/>• 评测表现全面超越人类标注的PRM800K"]
        --> S4["Weaver 弱验证器集成<br/>• 矩估计法 (Method of Moments) 无监督集成 (33个弱验证器)<br/>• 400M ModernBERT 交叉编码器蒸馏 (计算量削减 99.97%)"]
    end

    Gap ==> Solutions