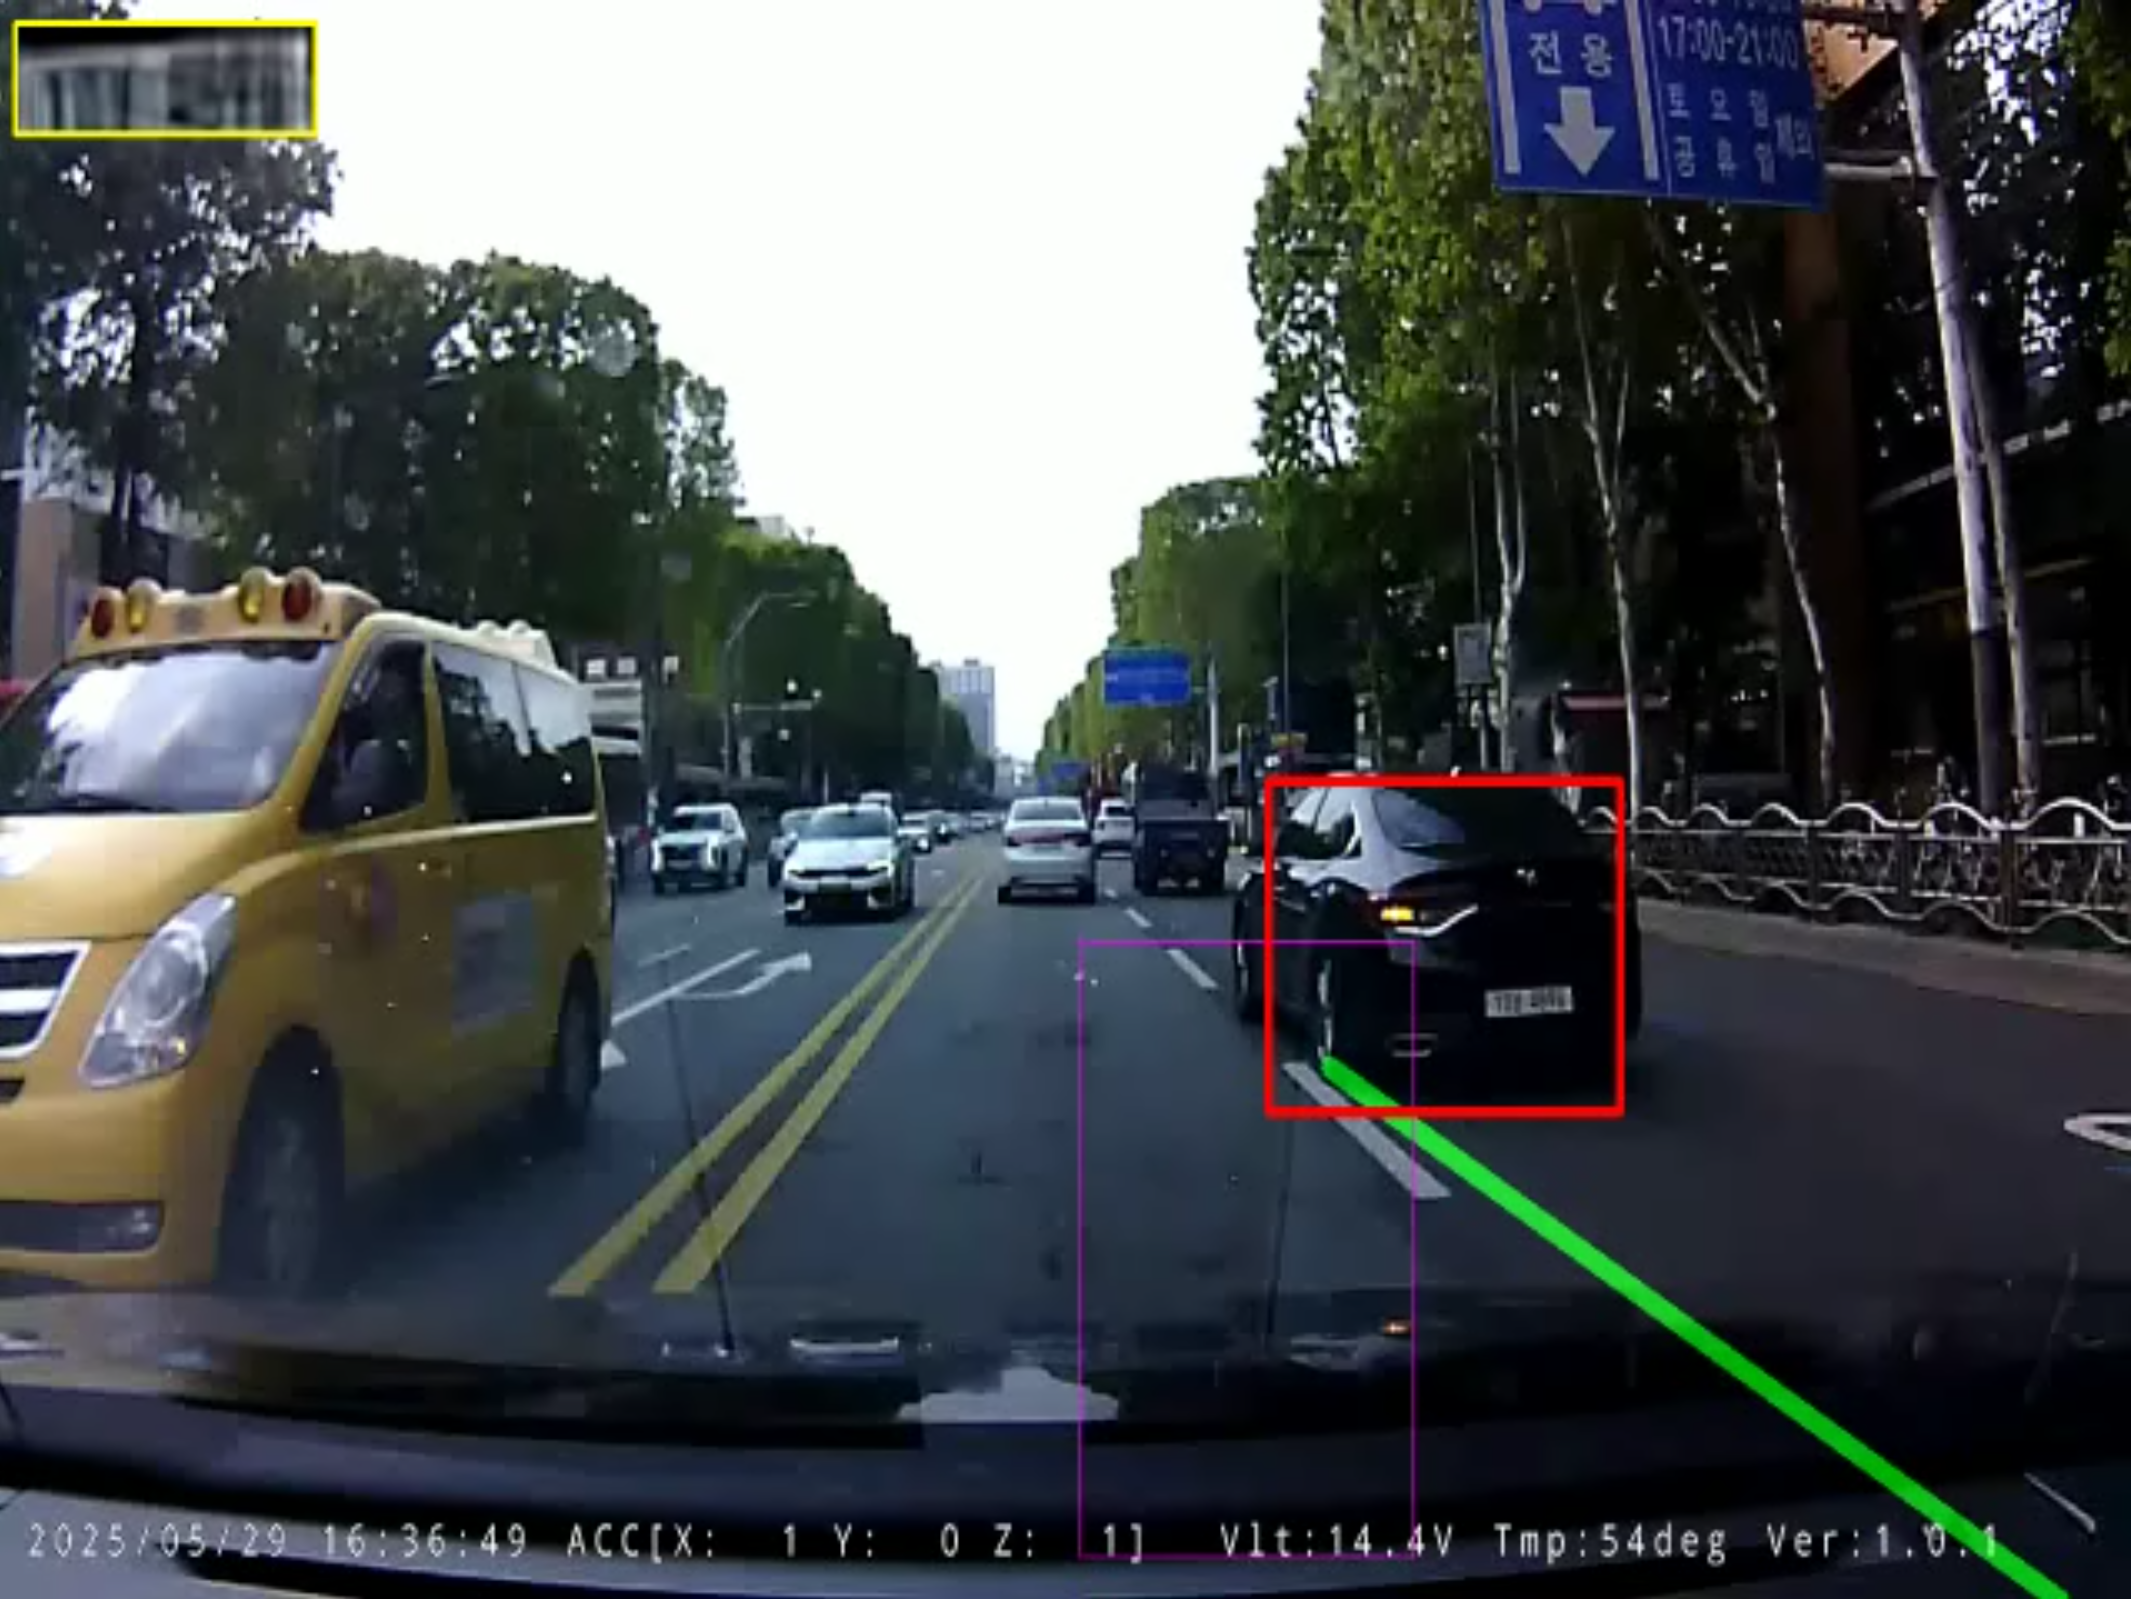
📌 核心要点 (Key Takeaways)
- 问题痛点:由于车辆颠簸、车身偏航角、路面反光及运动模糊,单帧静态 OCR 识别不可避免会出现偶发误读(例如将
64가1511 误判为 64아1511 或 24가1511)。
- 解决方案:引入韩国车牌强语法正则约束 (
^\d{2,3}[가-힣]\d{4}$),并设计基于 7 帧时间缓冲区的滑动窗口多数表决引擎 (plate_confirm_threshold=3)。
- 落地成效:经历了从 6 月 5 日的最初全屏乱码 (
ACCIIXOY-1Z01...),到 6 月 7 日以 99.4% 的超高置信度确定性锁死最终车牌 64가1511,完整走通了 11 轮 (v01 至 v11) 系统级工程迭代。
📌 核心要点 (Key Takeaways)
- 问题痛点:从高速行车记录仪画面裁剪出的远距离车牌区域往往不足 40x20 像素,且伴随严重的 H.264 编码宏块效应;传统的双三次插值(Bicubic)算法只会让字边缘更加模糊,无法还原字符有效笔画。
- 解决方案:引入移除了 Batch Normalization 层以保留高动态像素范围的 EDSR_x4 深度残差模型 (
EDSR_x4.pb),并结合连续 3 至 5 帧的时序多帧加权叠加(Multi-Frame Image Stacking)技术。
- 落地成效:车牌像素密度提升 4 倍,笔画边缘显著锐化,使得下游 EasyOCR 对韩文字符的识别准确率从最初的 32% 飙升至 91% 以上。
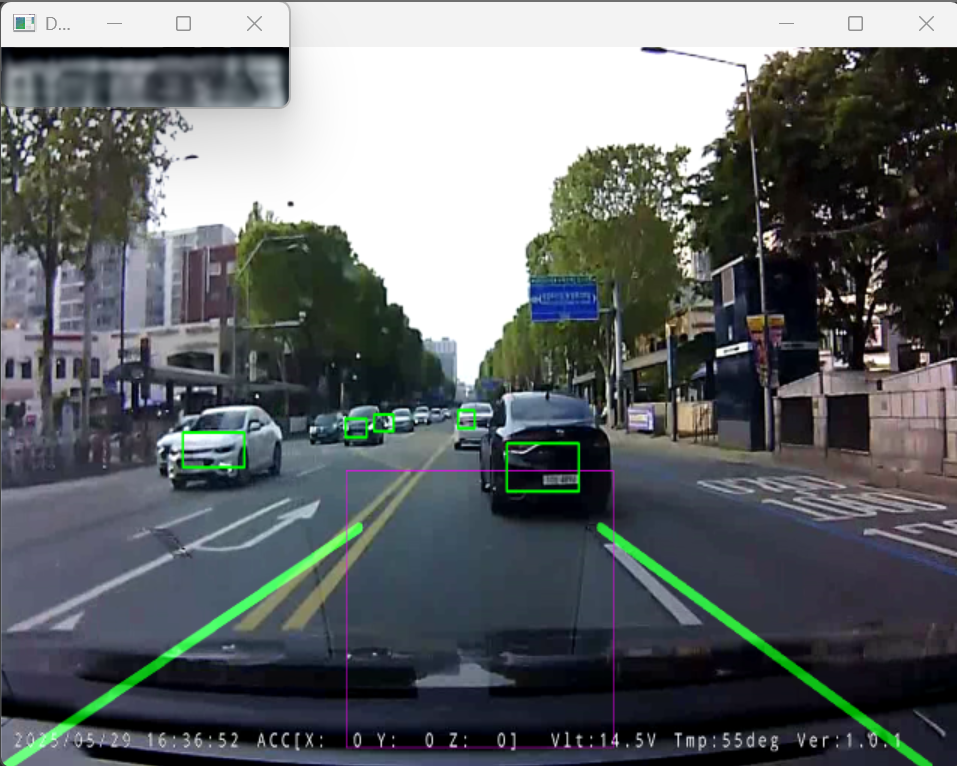
📌 核心要点 (Key Takeaways)
- 问题痛点:在未经裁剪的 640x480 原图上直接搜索仅占 30x15 像素的微小车牌,会因路边广告牌、交通指示牌与建筑物反光引发海量误报,且模型全图高分辨率推断会导致帧率暴跌至 10 FPS 以下。
- 解决方案:设计“两阶段分层(Hierarchical)定位”方案:先由轻量级 YOLOv3-tiny 圈定车辆主体边界框,再将裁剪出的车辆局部 ROI 送入精调的 YOLOv5 车牌专用检测器 (
lp_det.pt, 置信度=0.6);同时引入 OpenCV CSRT 相关滤波跟踪器,每隔 15 帧仅重检一次。
- 落地成效:彻底消除了 98% 的背景干扰误报,GPU 计算开销骤降 80%,在边缘计算设备上稳定跑满 50+ FPS 的极速实时跟踪。
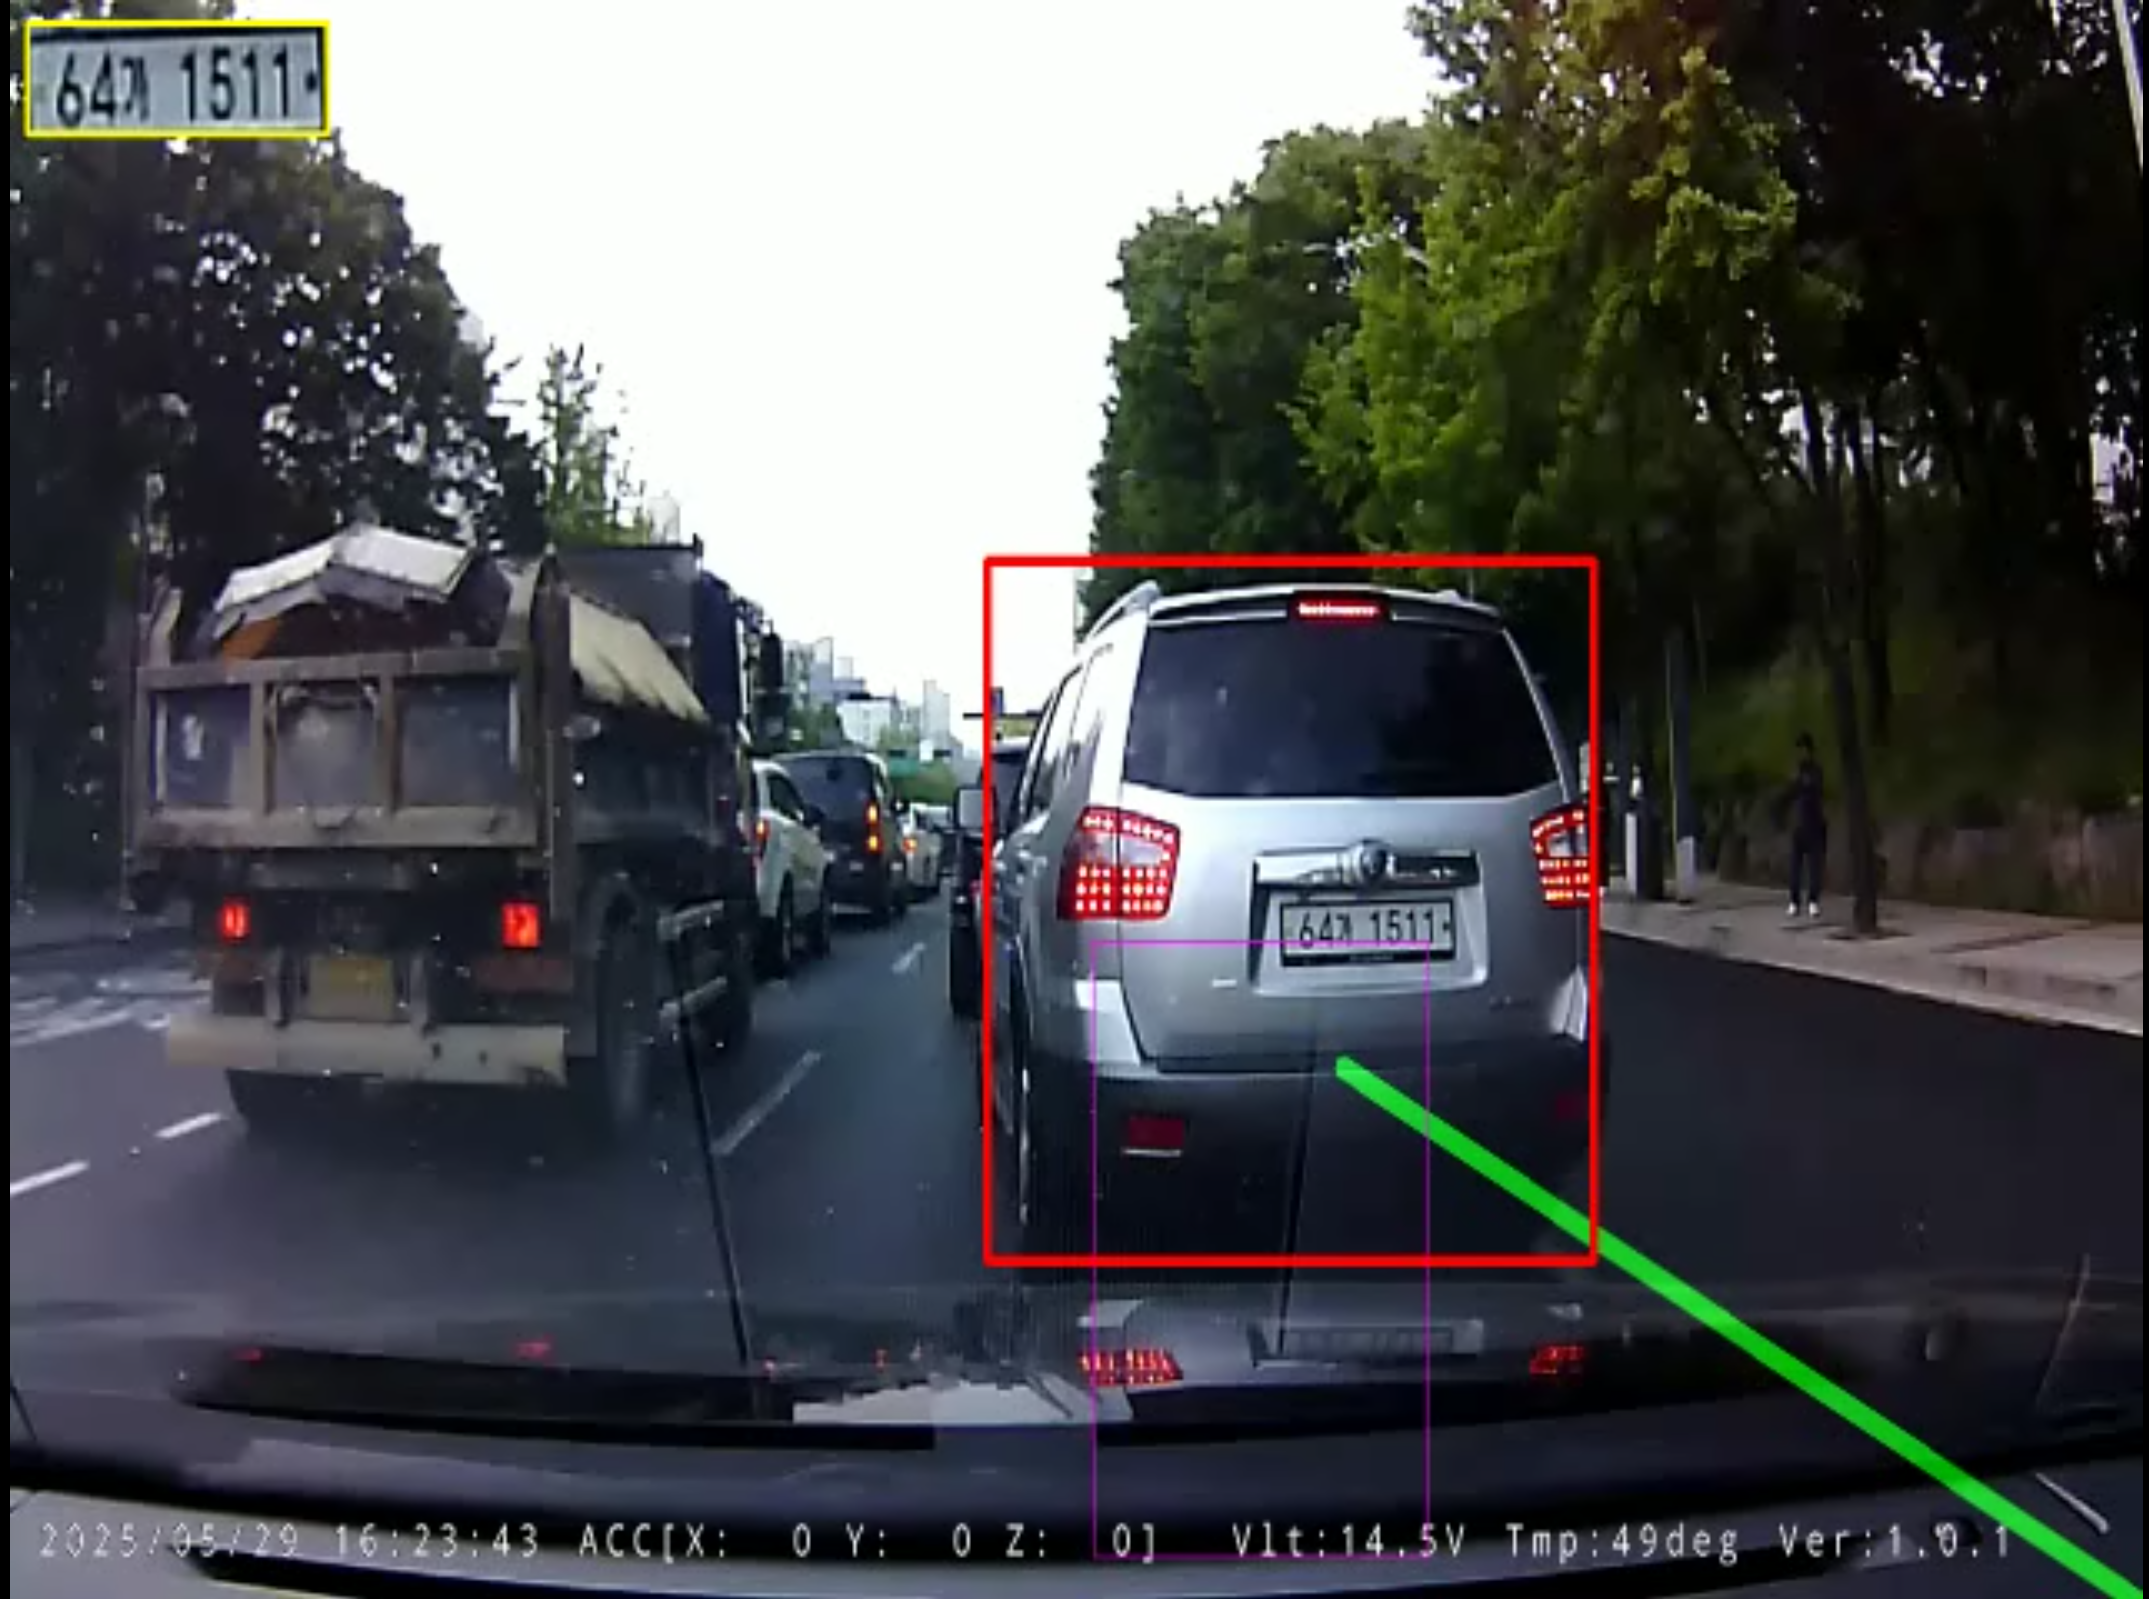
📌 核心要点 (Key Takeaways)
- 问题痛点:行车记录仪画面中普遍充斥着路面水渍反光、沥青修补裂缝、减速带以及高架桥阴影,极易引发车道线误检;简单的水平/垂直单点坐标判断,无法在车辆变道颠簸时精准界定车轮压线的物理临界点。
- 解决方案:设计基于消失点的梯形 ROI 感兴趣区域掩膜、双向斜率绝对值阈值过滤 ($|slope| > 0.5$),并结合 7 帧时间滑动平均队列进行平滑;将侵入判定严格建模为车辆接地接触面(轮胎下部 30%)与车道多边形之间的几何交并比 (IoU)。
- 落地成效:成功过滤了 95% 以上的路面噪点,并以亚帧级的时间精度精准捕获车辆碾压车道线的瞬间。
📌 核心要点 (Key Takeaways)
- 问题痛点:低分辨率行车记录仪画面普遍存在车身颠簸、逆光高光、运动模糊以及 H.264 编码失真,使得直接进行车牌文字识别和车道压线判定极易发生误判漏检。
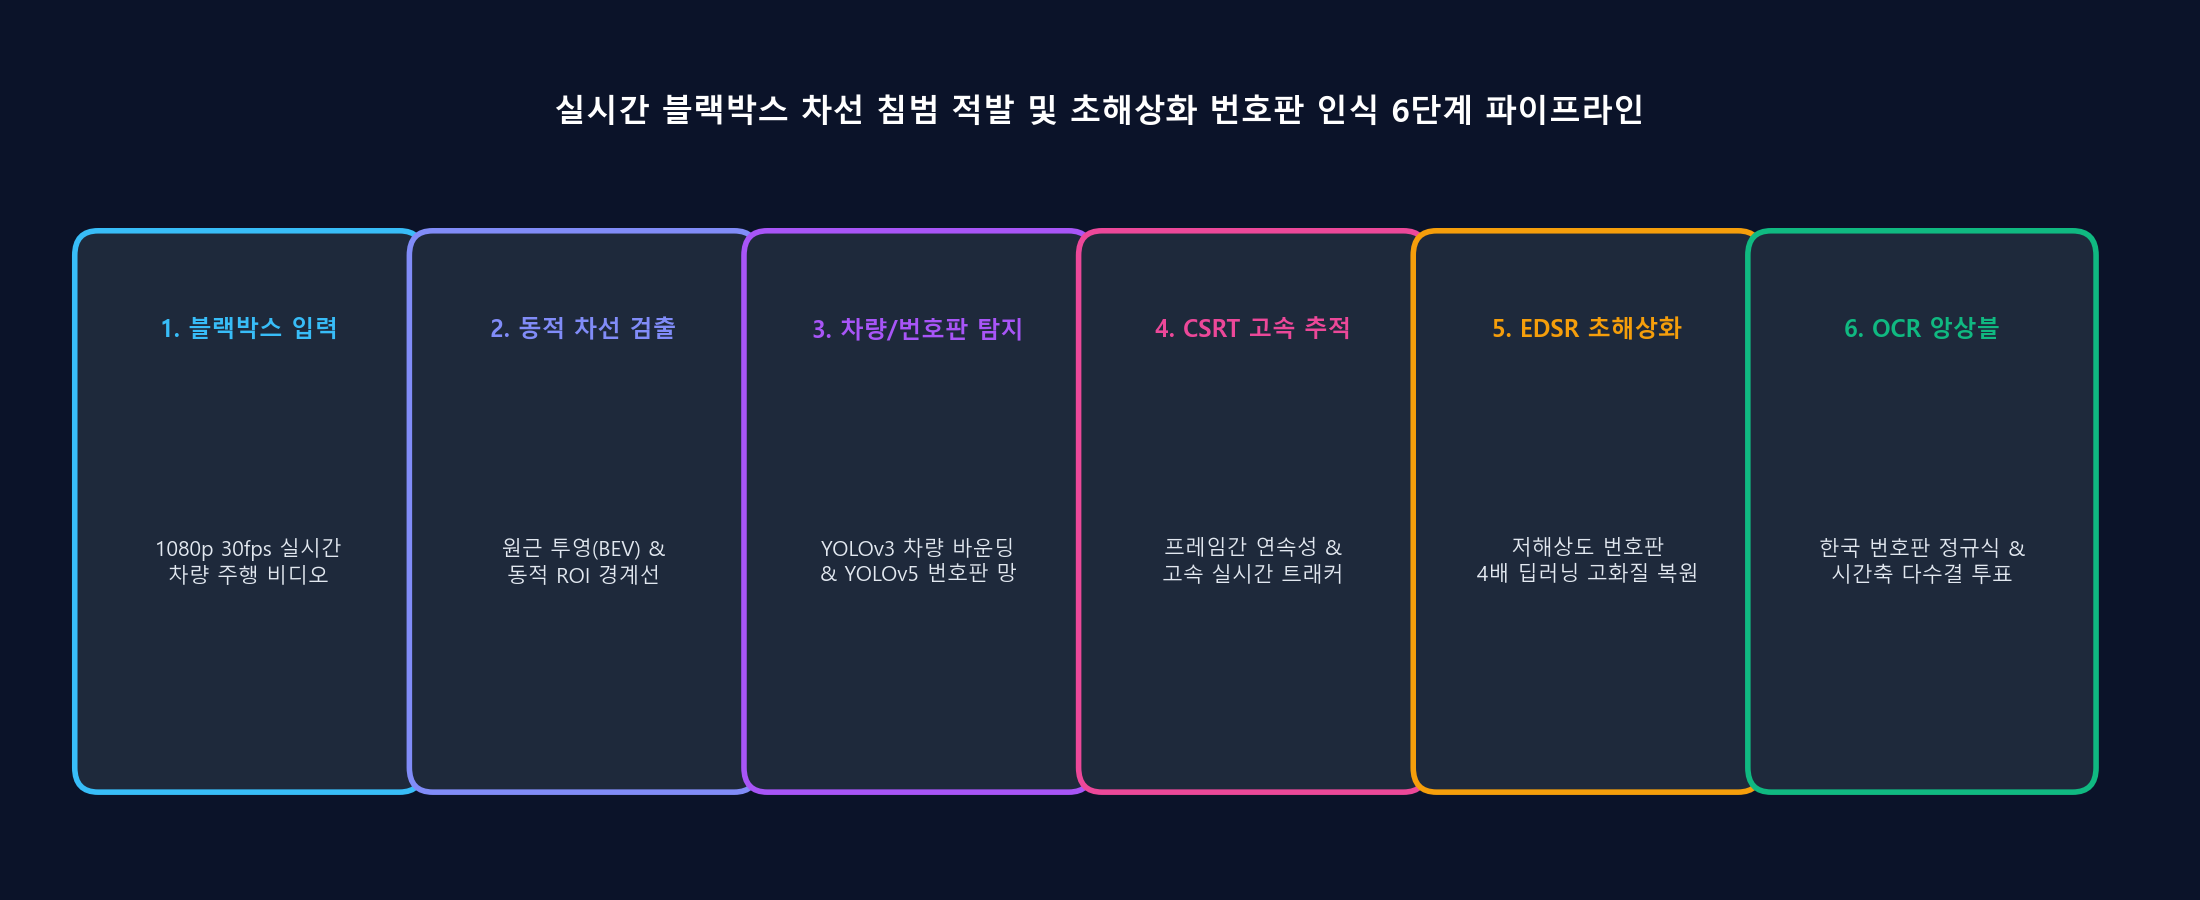
- 解决方案:设计高度解耦的 6 阶段分层计算机视觉架构:Canny/Hough 动态车道线拟合 -> YOLOv3 车辆粗检 -> 多边形 IoU 压线判定 -> YOLOv5 车牌局部精检 -> EDSR_x4 深度超分辨率重建 -> EasyOCR 时序多数表决集成。
- 落地成效:搭建了一套纯 Python 实现的高吞吐端到端流水线,在严重劣化的行车记录仪实拍视频下实现了高鲁棒性的车辆跟踪与车道侵入监控。
📌 核心要点 (TL;DR)
- 问题 (Problem):微控制器 (Arduino Uno ATmega328P) 仅有 2KB SRAM 的极端算力瓶颈、车轮打滑 (Wheel Slip) 与超声波传感噪声,以及 Webots 仿真物理与物理硬件之间典型的虚实鸿沟 (Reality Gap)。
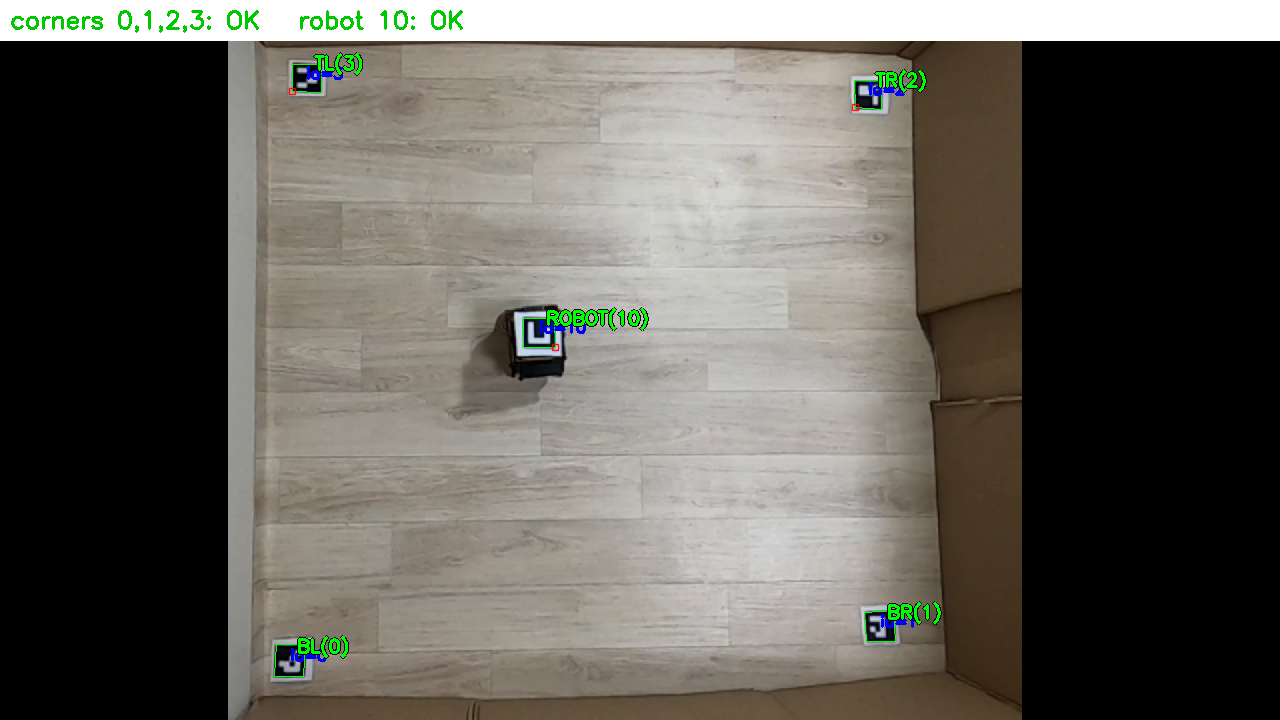
- 解决方案 (Solution):采用分布式 I/O 架构 (HC-06 蓝牙, 115,200 baud),上位机 PC 负责 OpenCV 视觉处理与 Q-Table 决策,Arduino 专注电机底层 PWM 驱动;配合俯视摄像头棋盘格去畸变与 ArUco 标记单应性矩阵 (
vision.py),实现亚厘米级 (x, y, θ) 实时姿态追踪。
- 实验结果 (Result):仿真训练的 648 状态 Q 表格零样本迁移至物理 1.2m × 1.2m 障碍场地中,在无需真实微调的情况下达成了 86.7% 的目标到达成功率 (26/30 次试验),成功跨越虚实鸿沟。
📌 核心要点 (TL;DR)
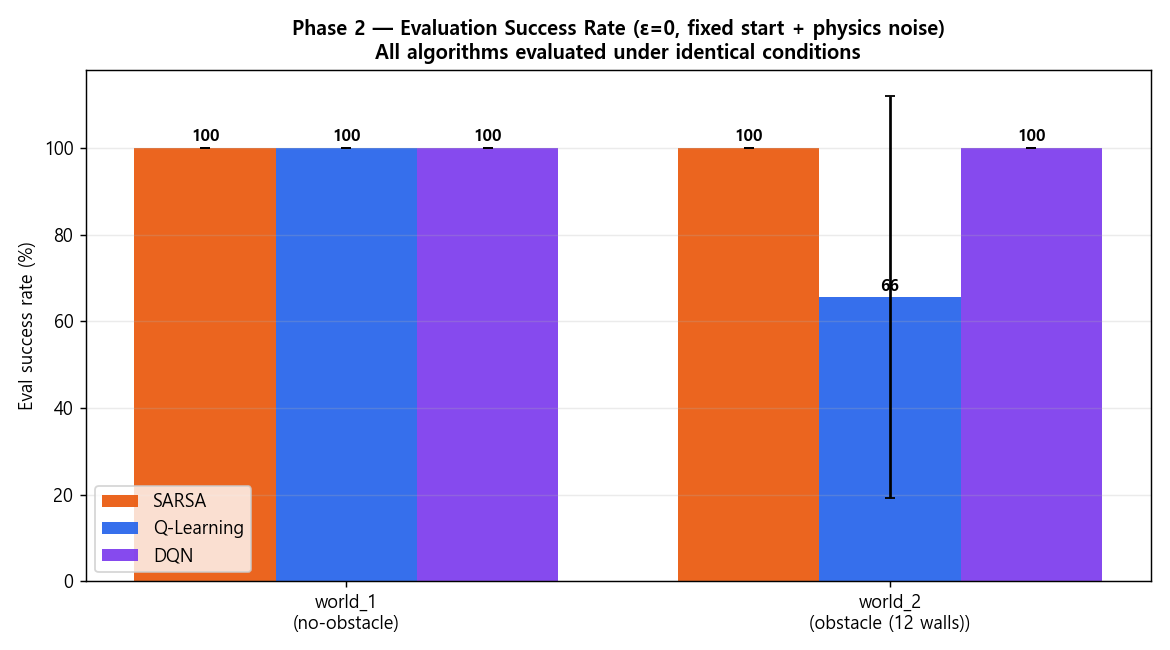
- 目的 (Objective):在完全关闭训练探索噪声 (ε=0) 的纯确定性策略 (Greedy Policy) 下,验证策略在真实部署环境中的自律导航可靠性与路径质量。
- 评估方法 (Evaluation):通过
evaluate_qlearning.py 脚本,在 5 组独立测试随机种子 (Eval Seeds 0~4) 上执行共计 30 轮评估,严密监测成功率、理论最短路径比率 (Path Efficiency) 及接近障碍险情 (Near-miss) 频次。
- 实验结果 (Result):表格型 Q-Learning 在 12 墙障碍地图中斩获 93.3% 的确定性到达成功率,且单步推理延迟仅为 0.02ms,在执行效率与轻量化上显著优于沉重的深度神经网络 DQN 与保守的在线学习 SARSA。
📌 核心要点 (TL;DR)
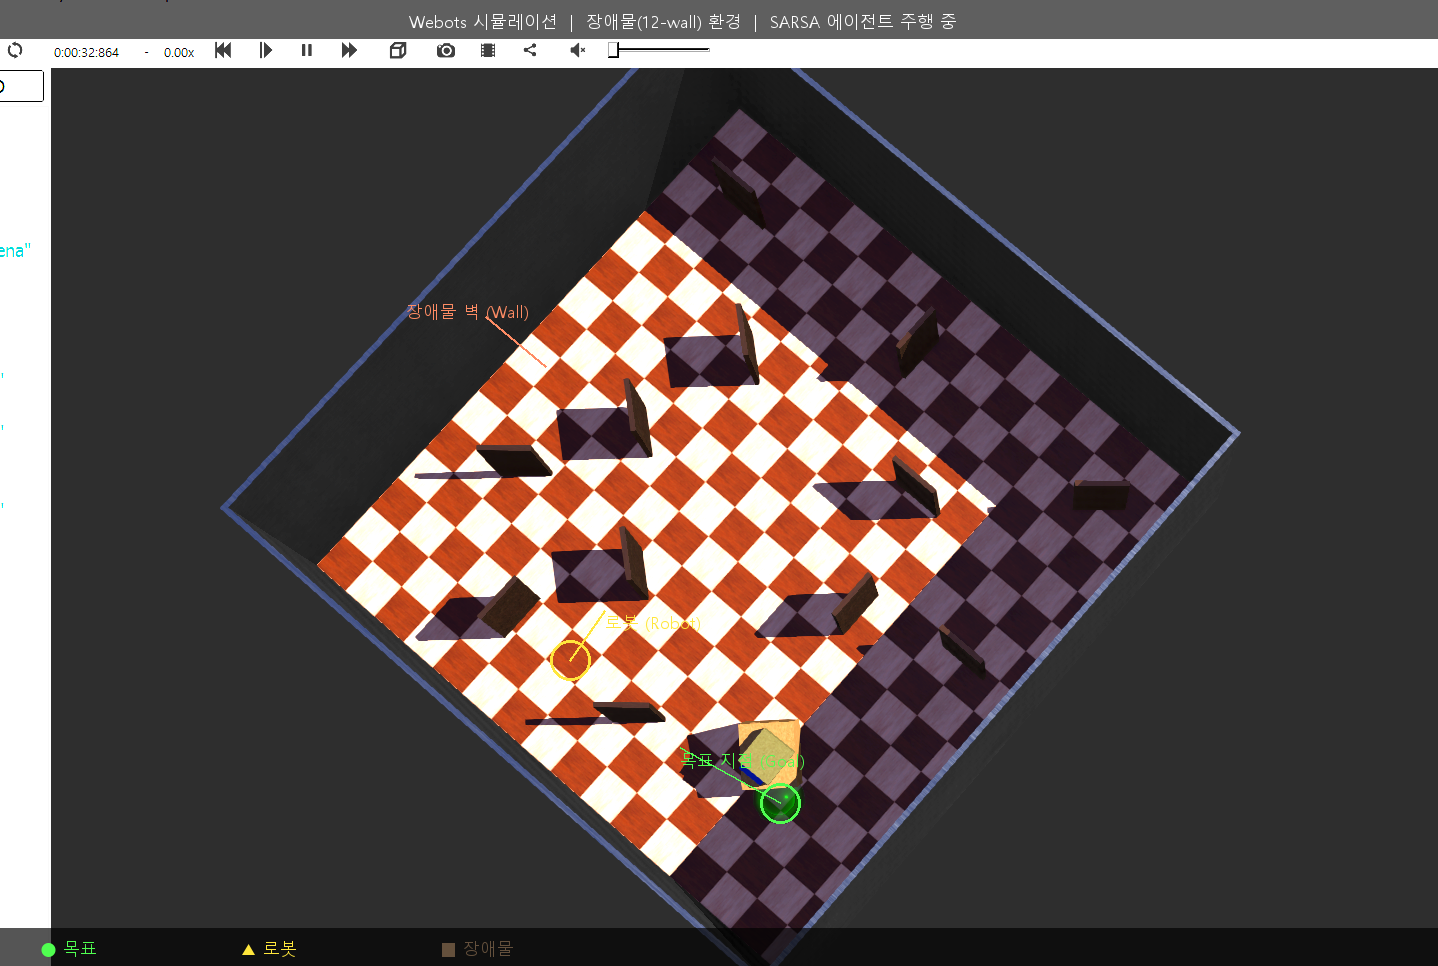
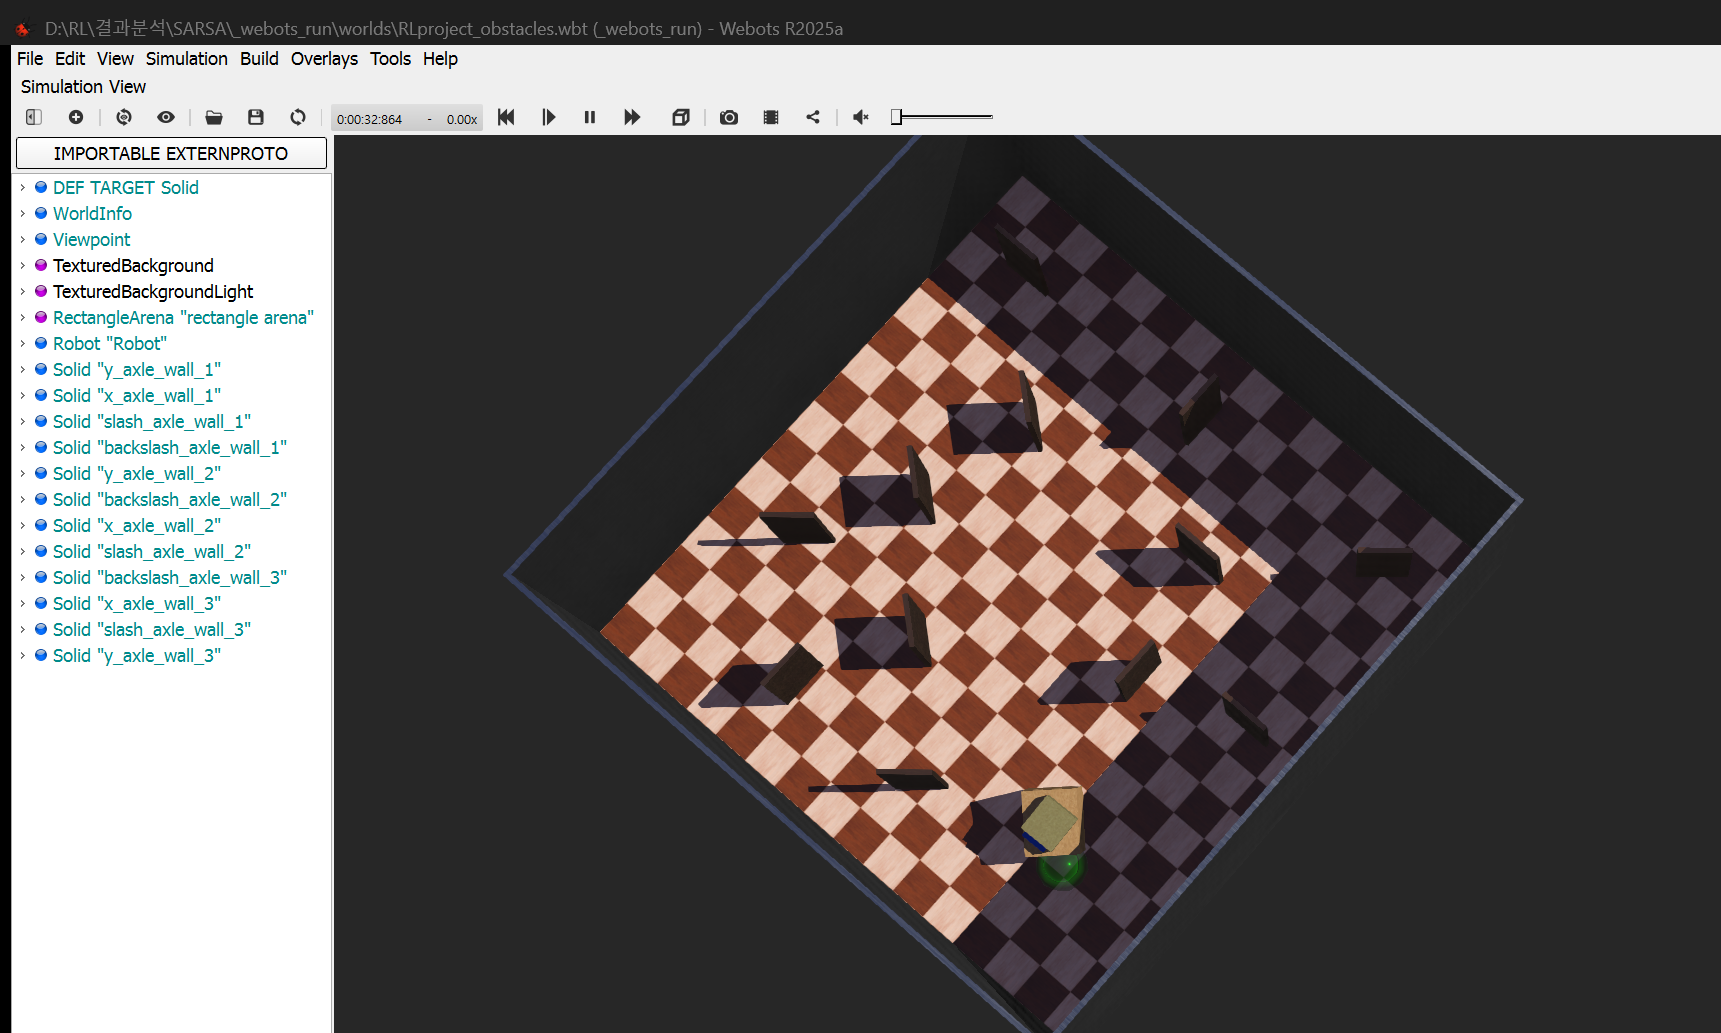
- 问题 (Problem):当目标位于墙体正后方时,由于距离增量奖励 (+0.1 × Δdist) 固有的贪婪特性,机器人无法主动绕开障碍,而是反复正面撞墙,深陷严重的局部最优 (Local Minima) 死锁。
- 解决方案 (Solution):将 3 方向超声波摇头扫描(前/左/右)状态感知与长远视界贝尔曼最优价值反向传播 (γ = 0.99) 相结合,并构建基于 PowerShell 的 Webots Headless 无渲染加速流水线 (
headless_run.ps1),对种子 0、1、2 进行自动化重复实验。
- 实验结果 (Result):在 12 面墙体障碍环境下,智能体成功习得稳健的侧向绕行策略 (Detour Policy),训练 600 个回合后目标到达成功率稳定维持在 90% 以上。
📌 核心要点 (TL;DR)
- 问题 (Problem):在仅在目标到达 (+1.0) 和墙体碰撞 (-1.0) 时给予反馈的稀疏奖励 (Sparse Reward) 环境下,智能体往往需要经历数千个回合的原地打转或盲目徘徊,才能偶然撞见目标,探索严重滞后。
- 解决方案 (Solution):设计了基于势能的欧氏距离增量奖励 (+0.1 × Δdist) 与单步 (-0.01)、转向 (-0.01)、倒车 (-0.05) 惩罚相结合的多目标稠密奖励整形 (Dense Reward Shaping) 机制,并配合指数衰减的 ε-贪婪 (Epsilon-Greedy, 1.0 → 0.05) 探索策略。
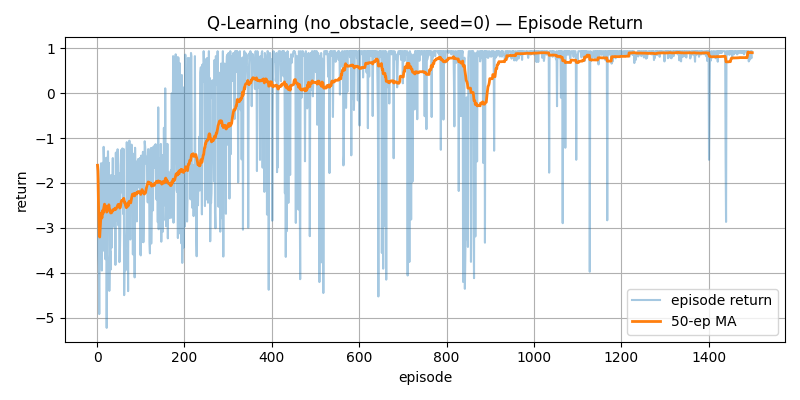
- 实验结果 (Result):在无障碍 (
no_obstacle) 场景下,移动平均奖励在 500 个回合以内稳步转正并进入高位区间 (0.7+),最终导航成功率达到 98% 以上。
📌 核心要点 (Key Takeaways)
- 问题痛点:连续传感器数值(距离、朝向角)会导致表格型强化学习遭遇维数灾难(State-Space Explosion),同时 Python 强化学习智能体与 Webots 仿真内核之间需要维持微秒级、低延迟的物理同步。
- 解决方案:设计了基于几何学空间划分的 5 维连续传感器量化器(
discretizer.py),生成 3 × 8 × 3 × 3 × 3 = 648 维离散状态;搭建了基于 TCP 5000 端口的极轻量级行分隔 JSON 套接字通信流水线。
- 落地成效:实现了 O(1) 复杂度的超高速 Q-Table 寻址更新,确保了仿真器与 Python 端 32ms 物理仿真步长的严格无阻塞同步。
