📌 核心要点 (TL;DR)
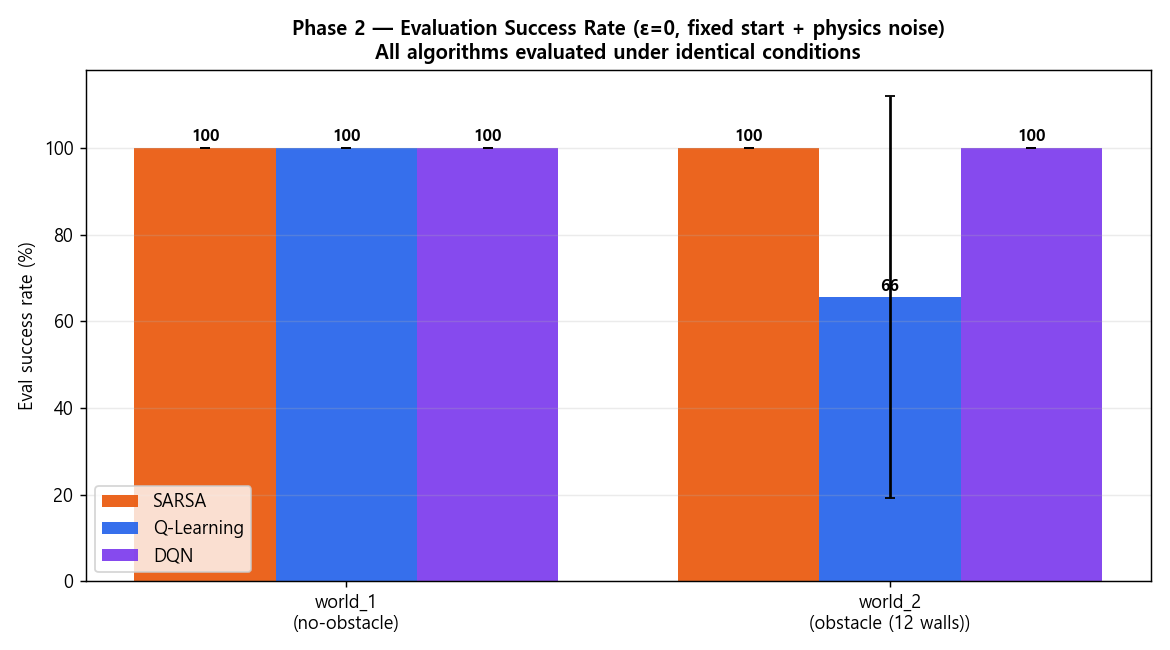
- 目的 (Objective):在完全关闭训练探索噪声 (ε=0) 的纯确定性策略 (Greedy Policy) 下,验证策略在真实部署环境中的自律导航可靠性与路径质量。
- 评估方法 (Evaluation):通过
evaluate_qlearning.py 脚本,在 5 组独立测试随机种子 (Eval Seeds 0~4) 上执行共计 30 轮评估,严密监测成功率、理论最短路径比率 (Path Efficiency) 及接近障碍险情 (Near-miss) 频次。
- 实验结果 (Result):表格型 Q-Learning 在 12 墙障碍地图中斩获 93.3% 的确定性到达成功率,且单步推理延迟仅为 0.02ms,在执行效率与轻量化上显著优于沉重的深度神经网络 DQN 与保守的在线学习 SARSA。
📌 核心要点 (TL;DR)
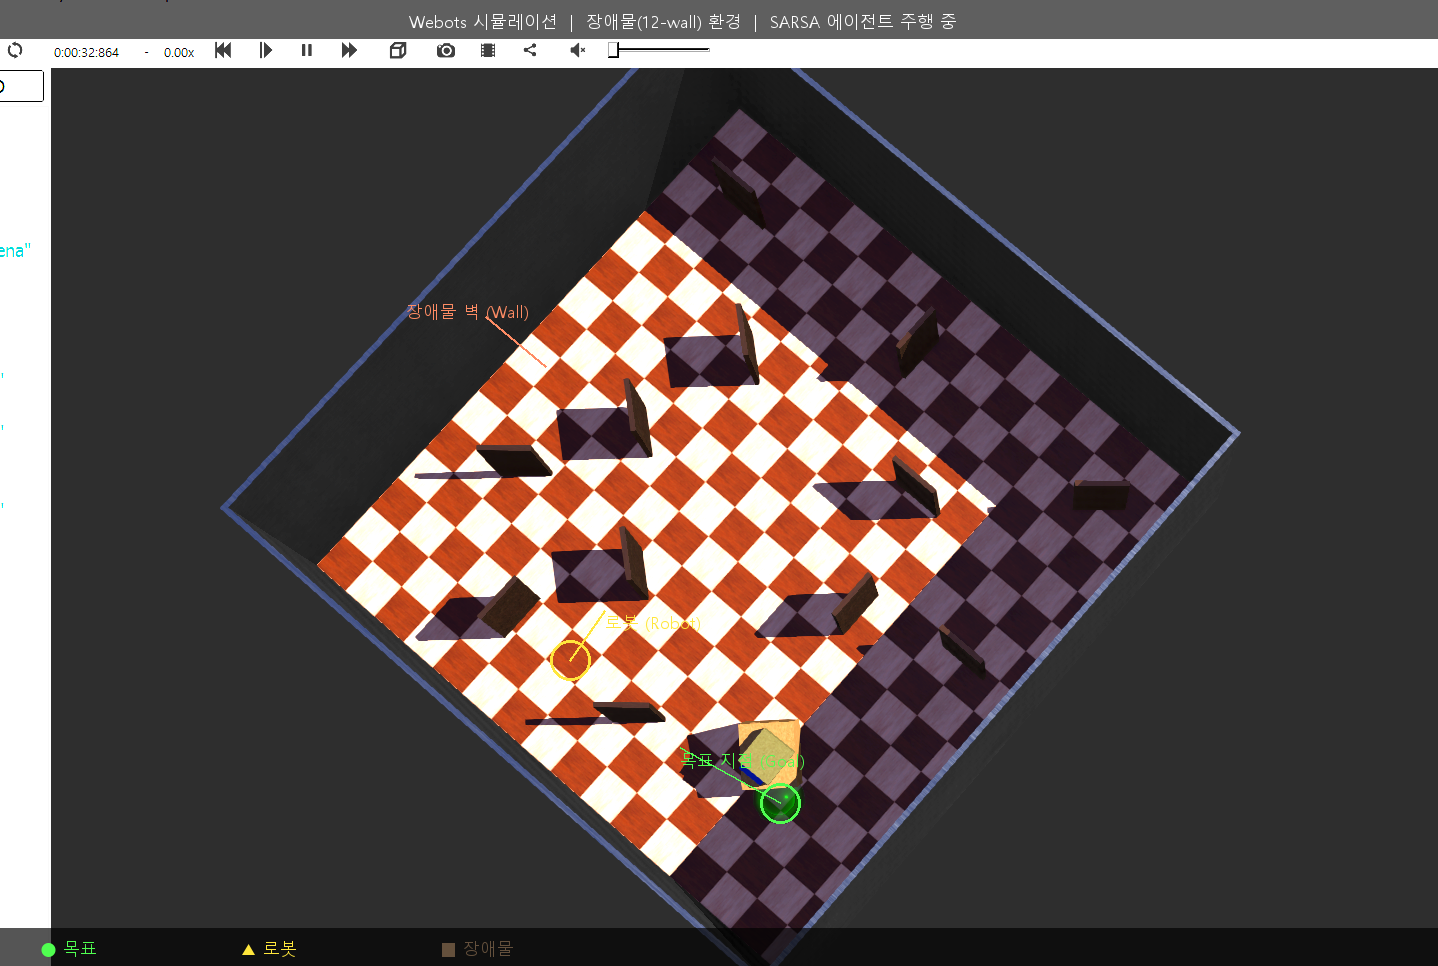
- 问题 (Problem):当目标位于墙体正后方时,由于距离增量奖励 (+0.1 × Δdist) 固有的贪婪特性,机器人无法主动绕开障碍,而是反复正面撞墙,深陷严重的局部最优 (Local Minima) 死锁。
- 解决方案 (Solution):将 3 方向超声波摇头扫描(前/左/右)状态感知与长远视界贝尔曼最优价值反向传播 (γ = 0.99) 相结合,并构建基于 PowerShell 的 Webots Headless 无渲染加速流水线 (
headless_run.ps1),对种子 0、1、2 进行自动化重复实验。
- 实验结果 (Result):在 12 面墙体障碍环境下,智能体成功习得稳健的侧向绕行策略 (Detour Policy),训练 600 个回合后目标到达成功率稳定维持在 90% 以上。
📌 核心要点 (TL;DR)
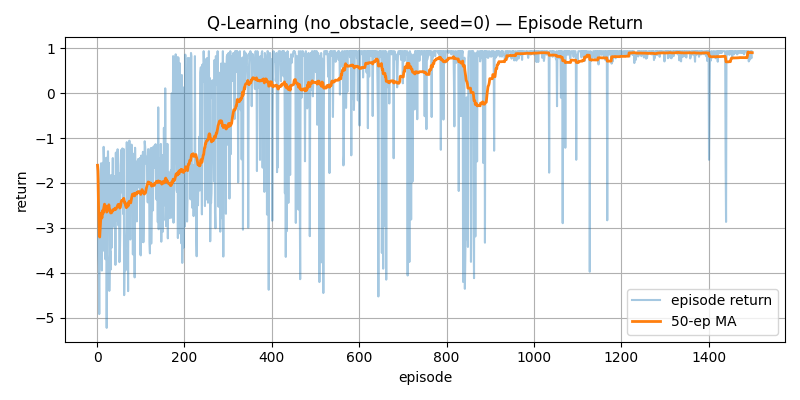
- 问题 (Problem):在仅在目标到达 (+1.0) 和墙体碰撞 (-1.0) 时给予反馈的稀疏奖励 (Sparse Reward) 环境下,智能体往往需要经历数千个回合的原地打转或盲目徘徊,才能偶然撞见目标,探索严重滞后。
- 解决方案 (Solution):设计了基于势能的欧氏距离增量奖励 (+0.1 × Δdist) 与单步 (-0.01)、转向 (-0.01)、倒车 (-0.05) 惩罚相结合的多目标稠密奖励整形 (Dense Reward Shaping) 机制,并配合指数衰减的 ε-贪婪 (Epsilon-Greedy, 1.0 → 0.05) 探索策略。
- 实验结果 (Result):在无障碍 (
no_obstacle) 场景下,移动平均奖励在 500 个回合以内稳步转正并进入高位区间 (0.7+),最终导航成功率达到 98% 以上。
📌 核心要点 (Key Takeaways)
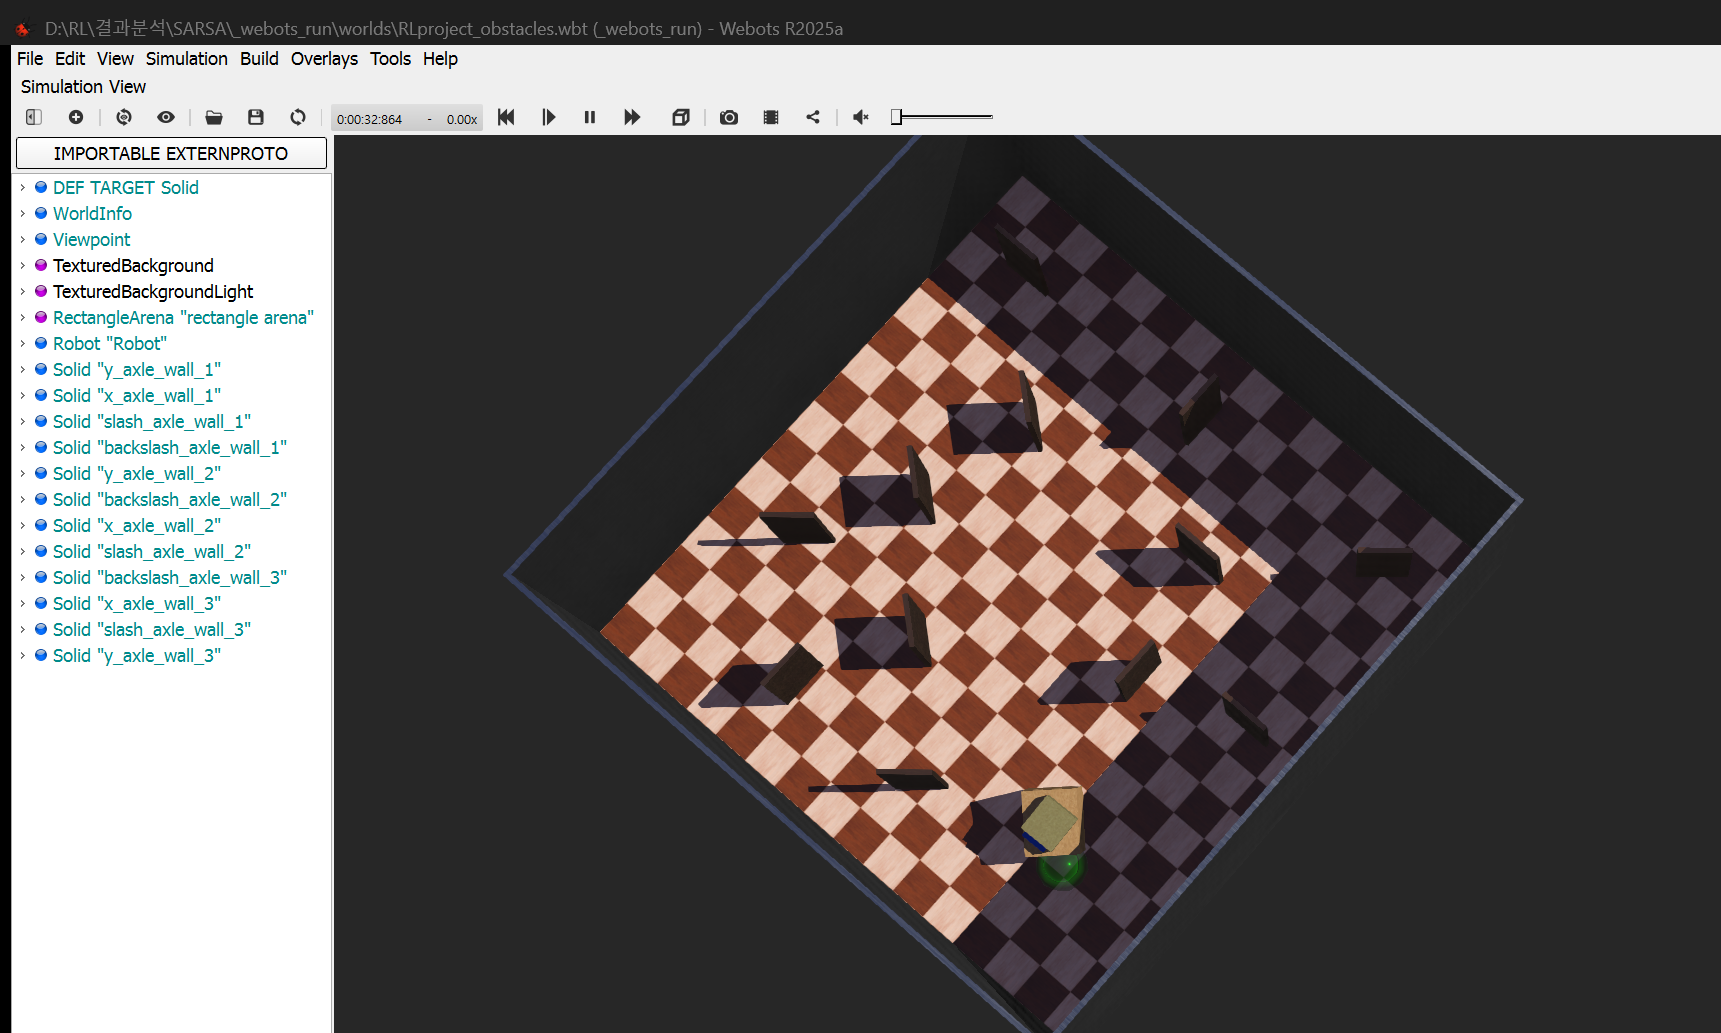
- 问题痛点:连续传感器数值(距离、朝向角)会导致表格型强化学习遭遇维数灾难(State-Space Explosion),同时 Python 强化学习智能体与 Webots 仿真内核之间需要维持微秒级、低延迟的物理同步。
- 解决方案:设计了基于几何学空间划分的 5 维连续传感器量化器(
discretizer.py),生成 3 × 8 × 3 × 3 × 3 = 648 维离散状态;搭建了基于 TCP 5000 端口的极轻量级行分隔 JSON 套接字通信流水线。
- 落地成效:实现了 O(1) 复杂度的超高速 Q-Table 寻址更新,确保了仿真器与 Python 端 32ms 物理仿真步长的严格无阻塞同步。
