[Stanford CS329A #4] 工具调用与代码执行反馈:ReAct、RLEF与宪法级自我修正
· 阅读需 17 分钟

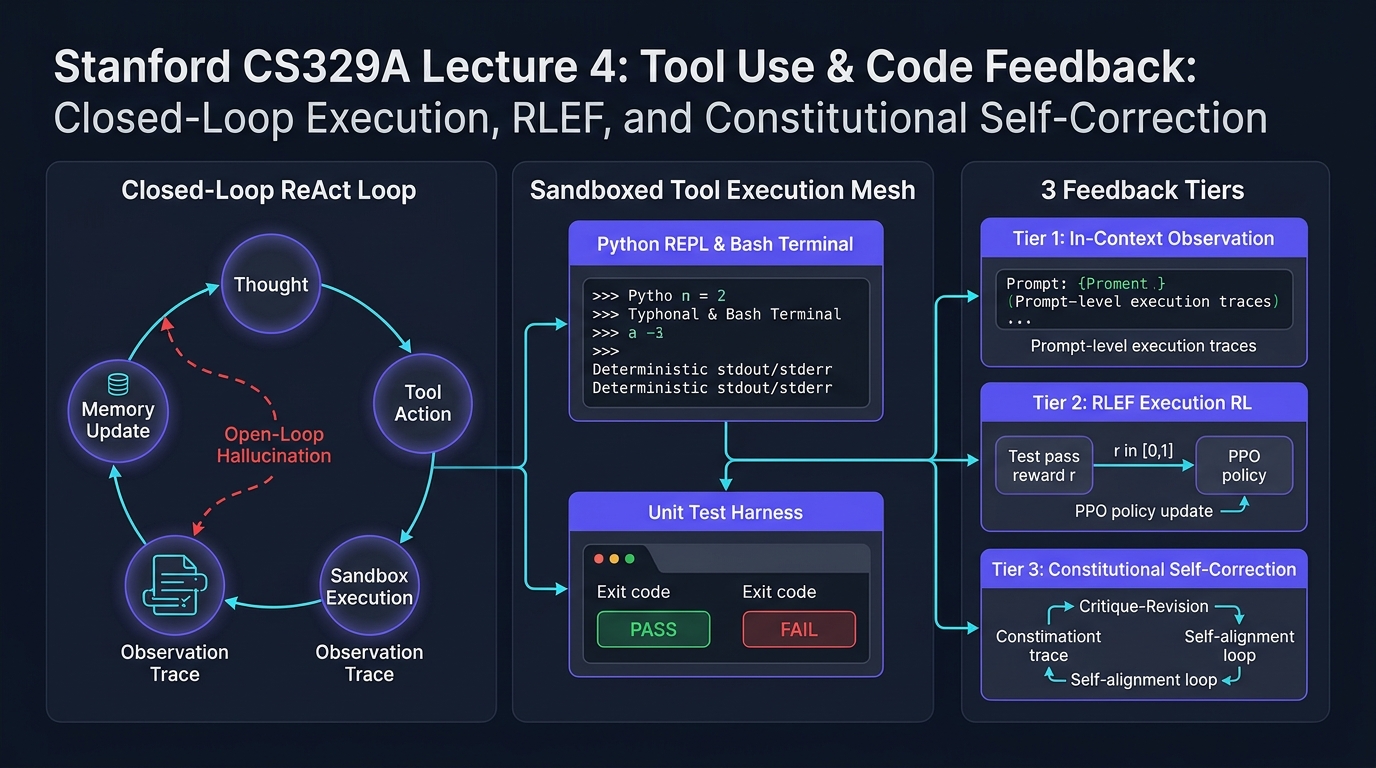
欢迎来到斯坦福大学2025秋季最新研究生课程——**CS329A: Self-Improving AI Agents(自主进化AI智能体)**的第四篇深度工程解析。
在第2讲与第3讲中,我们系统剖析了测试时计算扩展(Test-time Compute Scaling)与过程奖励模型(PRM),掌握了语言模型如何展开推理搜索树并验证中间数学推导的内在逻辑。然而,无论思维链(CoT)推理多么精妙,仅仅局限于纯文本生成的模型本质上依然是**“被关在封闭考场内答卷的学生”**。它们只能依赖预训练阶段写入神经网络的静态、冻结参数记忆(Parametric Memory)。面对实时演变的世界现实、动态Web API或语法要求严苛的代码执行环境,与外部物理隔离的模型不可避免地会陷入以假乱真的“幻觉(Hallucination)”。
今天的第4讲正是带领智能体走出封闭考场的决定性转折点:工具调用(Tool Use)与代码执行反馈循环(Feedback Loops)。
现代自主智能体不再将代码或API调用仅仅视作最终的文本输出,而是将其转化为与外部环境进行交互的感知器(Sensor)与执行器(Actuator)。本讲中,我们将深入拆解将静态语言模型升级为自主闭环智能体的三大核心反馈层级:
- 提示词层面的环境交互反馈: 思维与行动协同并进的 ReAct(Yao et al., 2022)
- 策略网络层面的执行诊断反馈: 将编译器与测试集报错直接刻入模型权重的 RLEF(Reinforcement Learning from Execution Feedback, 2024)
- 自主监督层面的价值对齐修正: 以自然语言宪法原则替代高昂人工标注的 Constitutional AI(Anthropic, 2022)
flowchart TD
    subgraph ClosedLoop ["闭环智能体核心架构 (Closed-Loop)"]
        direction TB
        Agent["自主智能体核心 (LLM Policy)"]
        Thought["内部语言推导 (Thought Space L)"]
        Action["可执行工具调用 (Action Space A)"]
        Sandbox["隔离代码沙箱 (Python REPL / Shell / Search)"]
        Obs["确定性环境观测反馈 (Stdout / Stderr)"]

        Agent --> Thought
        Thought --> Action
        Action --> Sandbox
        Sandbox --> Obs
        Obs -->|"更新上下文记忆 (c_{t+1})"| Agent
    end

    subgraph FeedbackTiers ["智能体反馈的三大进化层级"]
        direction TB
        T1["层级 1: 上下文环境交互反馈 (ReAct)<br/>• 思考与行动交错循环: Thought + Action + Observation<br/>• 多跳知识检索任务中事实捏造幻觉率降至 0%"]
        --> T2["层级 2: 策略权重级执行反馈 (RLEF)<br/>• 马尔可夫决策过程(MDP)建模: State, Action, Sandbox Reward<br/>• 公开/私有双重测试集结合 PPO 算法优化<br/>• Llama-3.1-70B 在 CodeContests 1@3 准确率从 27.5% 跃升至 40.1%"]
        --> T3["层级 3: 价值对齐自主修正 (Constitutional AI)<br/>• 基于自然语言原则的批评-修正 SFT 数据飞轮<br/>• 基于 AI 反馈的强化学习(RLAIF)训练偏好模型<br/>• 彻底打破传统人工标注的算力与规模瓶颈"]
    end

    ClosedLoop ==> FeedbackTiers