[Maeumjigi 心语伴侣毕业设计开发日志 #17] 第二轮微调胜利收官与自动化评估流水线的硬编码陷阱
· 阅读需 2 分钟

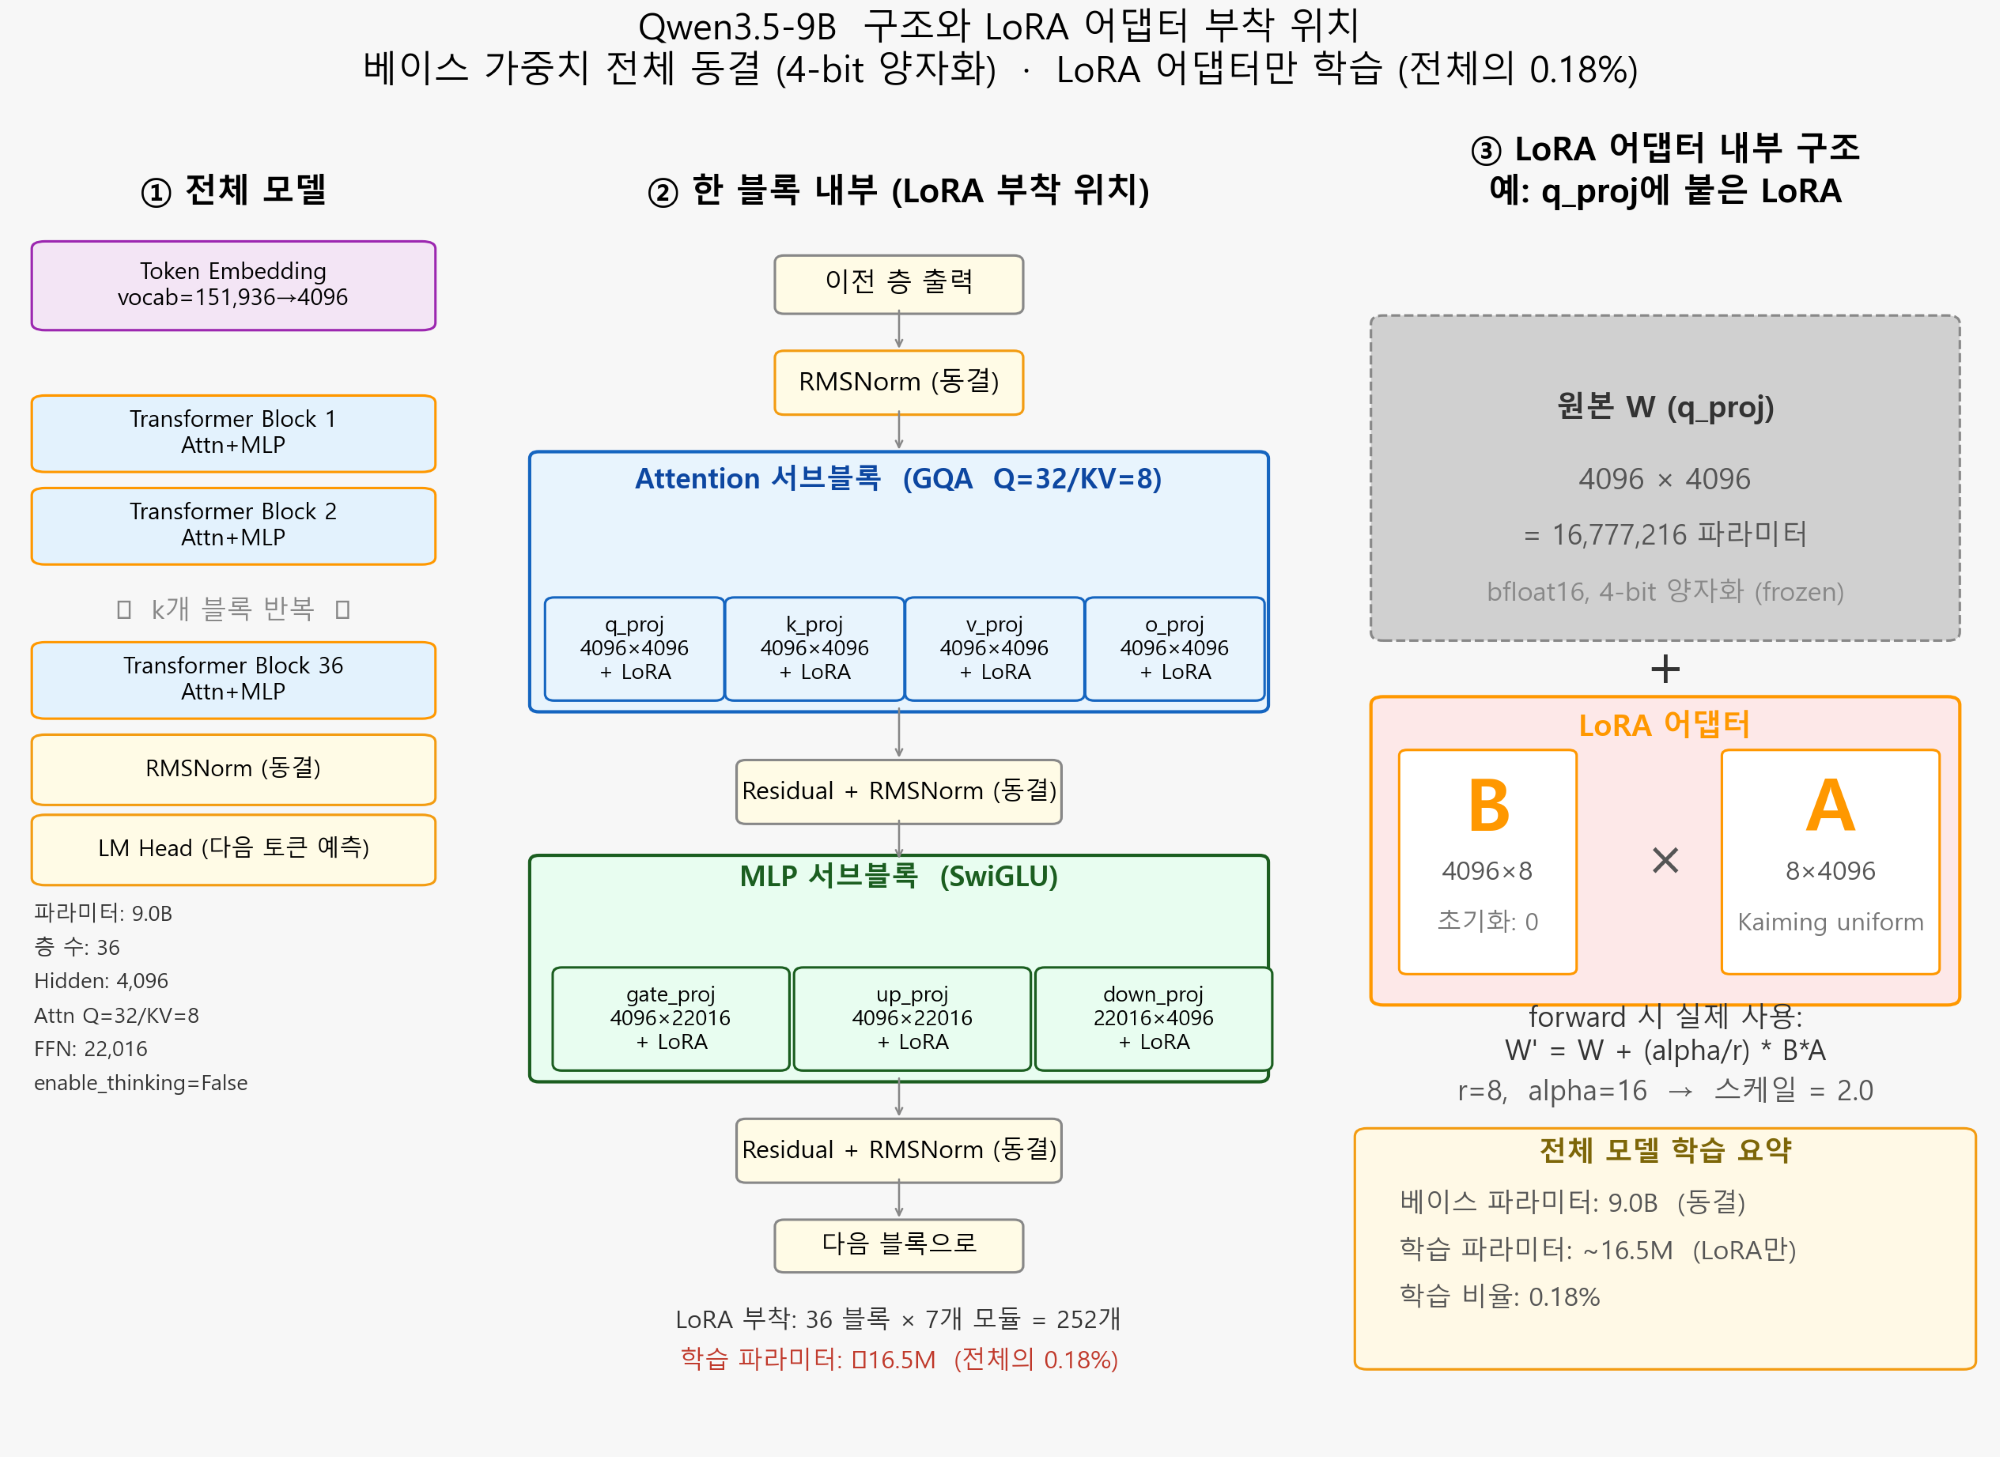
为了拨乱反正、纠正 LoRA 超参数配比倒置而仓促启动的第二轮微调 (fine_tuning_2) 多卡并行长跑,终于在 5 月 12 日迎来了胜利的曙光!
为了拨乱反正、纠正 LoRA 超参数配比倒置而仓促启动的第二轮微调 (fine_tuning_2) 多卡并行长跑,终于在 5 月 12 日迎来了胜利的曙光!
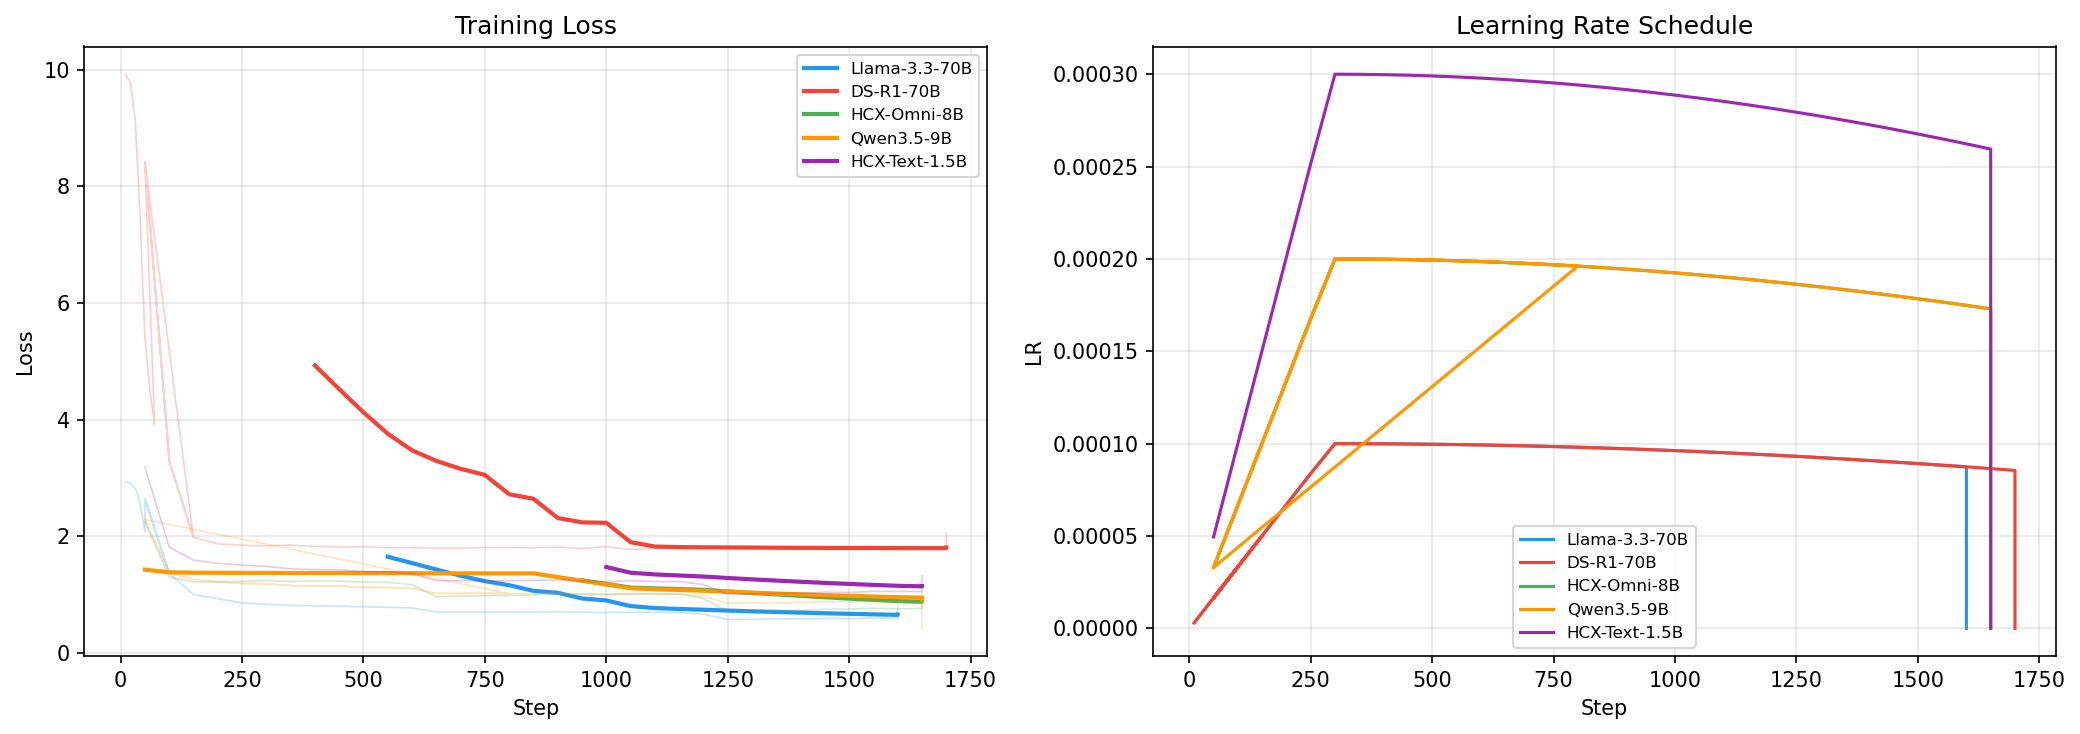
在领教了 70B 庞大参数量在微调过程中的显存地狱后,5 月 4 日,我们果断决定实施战略转向。
尽管我们曾通过将 Batch Size 压榨至极限,勉强将 70B 模型(Llama 3.3, DeepSeek-R1)推到了 checkpoint-1200 与 1300,但极其漫长迟缓的训练周期使得整体科研迭代效率极度低下。