[Maeumjigi 心语伴侣毕业设计开发日志 #21] 语料混合配比黄金分割与第 4 轮微调全面打响
· 阅读需 3 分钟

5 月 21 日与 22 日两天,Maeumjigi 毕业设计团队全量投入了针对全新高品质语料的大规模批处理生成,并正式拉开了第 4 轮微调实验 (fine_tuning_4) 的帷幕。
5 月 21 日与 22 日两天,Maeumjigi 毕业设计团队全量投入了针对全新高品质语料的大规模批处理生成,并正式拉开了第 4 轮微调实验 (fine_tuning_4) 的帷幕。
5 月 19 日至 20 日的两天时间里,第三轮微调 (fine_tuning_3) 的评估自动化与面向生产级 App 服务的全栈功能深度打磨实现了全面齐头并进。
在彻底修复昨天排查出的别名硬编码缺陷后,5 月 13 日,我们终于重启了第二轮微调大模型真实端到端的推理生成能力基准测试。
为了拨乱反正、纠正 LoRA 超参数配比倒置而仓促启动的第二轮微调 (fine_tuning_2) 多卡并行长跑,终于在 5 月 12 日迎来了胜利的曙光!
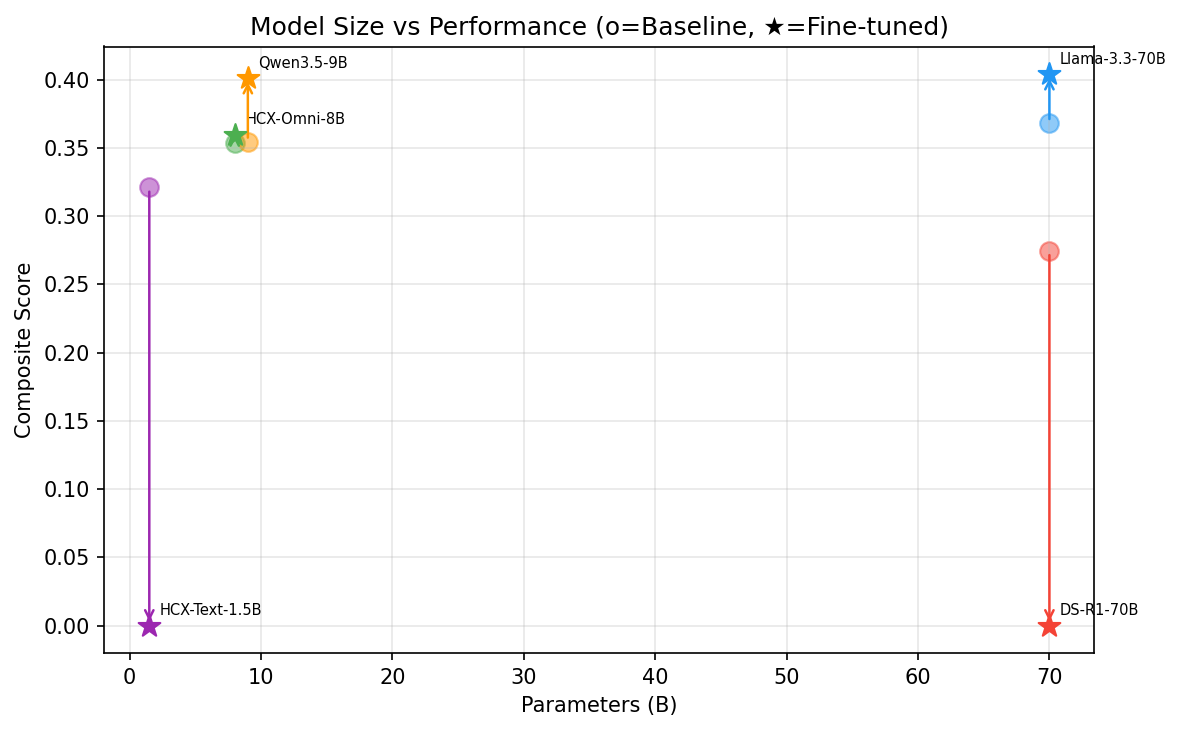
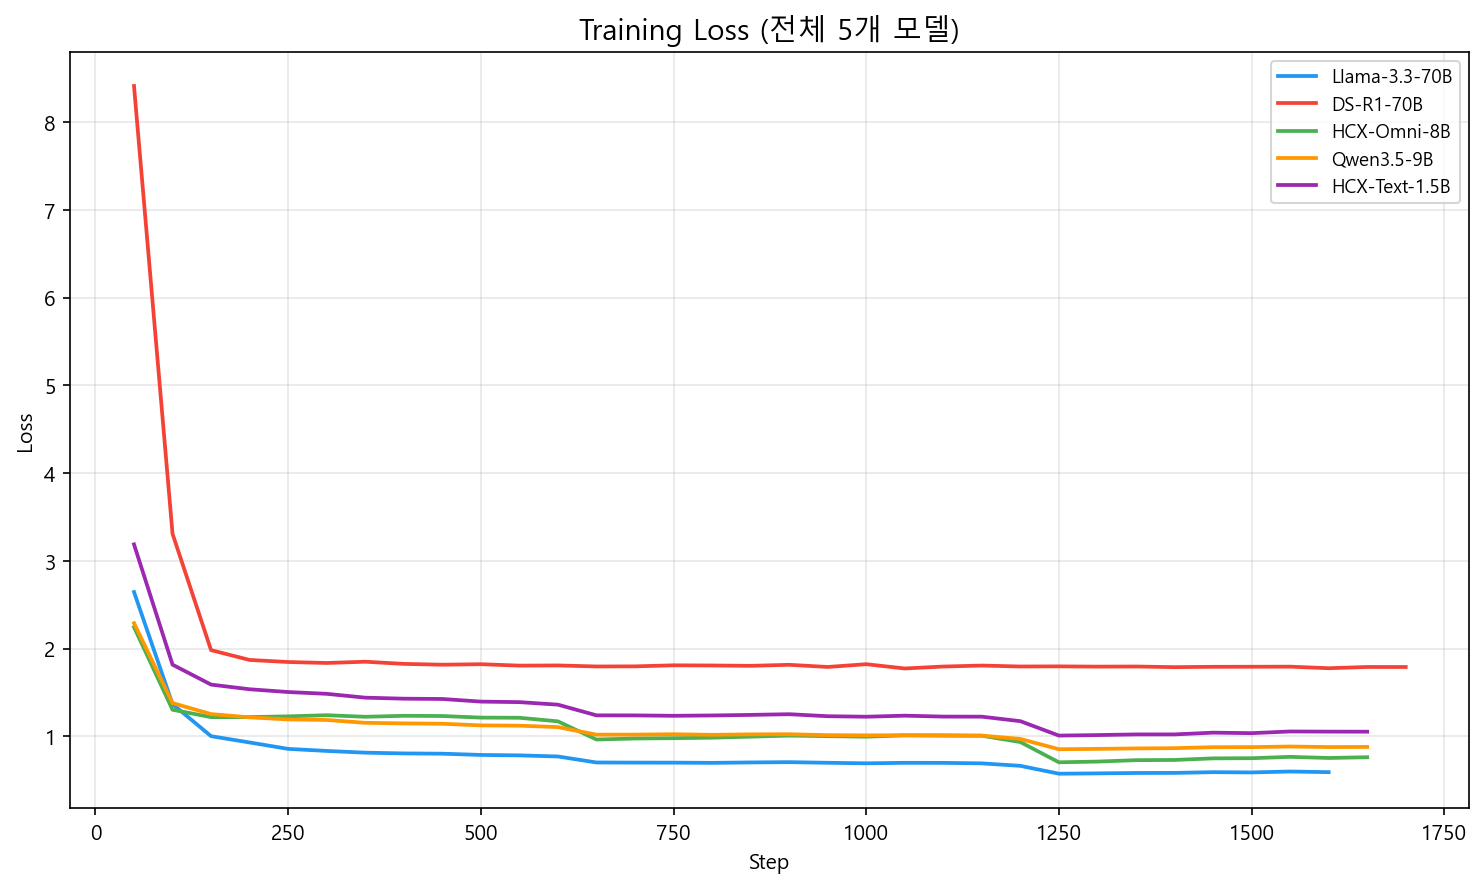
5 月 7 日,我们对倾注心血完成微调的 5 大代表性大模型(Llama 3.3-70B、DSR1-70B、HCX-Omni-8B、Qwen35-9B、HCX-Text-1.5B)的实验数据进行了全景汇总, 并全面展开了深度可视化与轻量化本地评测环境的搭建。
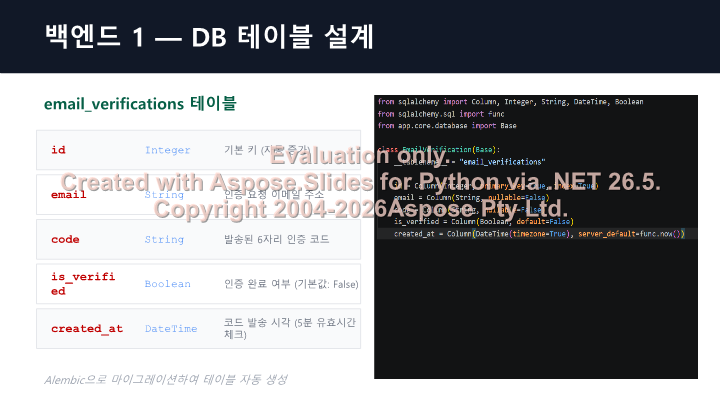
这是记录 3 月 31 日的开发实录。在这一天,我们既对国防会议中心预约提醒 App 进行了 Android 端构建测试, 又正式启动了暗示项目将彻底转型为前沿 AI 项目的 Llama 3.1 领域微调数据预处理流水线。
这是记录 3 月 30 日、正式启动 Maeumjigi 项目雏形“国防会议中心预约提醒”应用程序研发的开发实录。 依托上次确立的团队编码规范,我们制定了详尽的项目推进计划,并为测试驱动开发 (TDD) 筑牢了基底。