[Maeumjigi 心語伴侶畢業專題開發日誌 #8] API 扣費超額危機與 Google Colab 微調指令碼構築
· 閱讀時間約 3 分鐘

4 月 8 日,是我們在推進 Maeumjigi 專案期間經歷的最嚴峻危機,也是令人哭笑不得的技術插曲——Claude API 達到月度配額上限與突發扣費帳單危機。
背景掛機的慘痛教訓:「產生 10 筆資料居然要燒掉 1 美元?」
- 問題背景:以為昨天做完初步最佳化便高枕無憂,我們便將大規模合成資料集指令碼掛在背景持續運轉後離開。
- 推進過程:
「緊急問題:呼叫觸發了月度消費告警,帳單超額熔斷!本以為背景會安穩執行,結果扣費失控!」 「這怎麼可能?僅產生 10 筆多輪對話居然消耗了整整 1 美元?這不合常理!」
- 成果沉澱:在大模型深度合成高品質心理語料的過程中,隨著多輪歷史上下文(Input Tokens)不斷累積疊加,每個請求的 Token 開銷呈階梯式暴漲,最終觸發平台月度配額上限導致程式中止。我們緊急下達整改指令:「立刻在控制台即時列印預計 Token 消耗、即時帳單金額與推進進度百分比,並強制加入硬性預算阻斷熔斷機制。」這成為我們使用雲端 API 與大模型基礎設施時極其深刻的工程監控啟示錄。
編寫面向 Llama 3.1 訓練的 Colab 全套程式碼
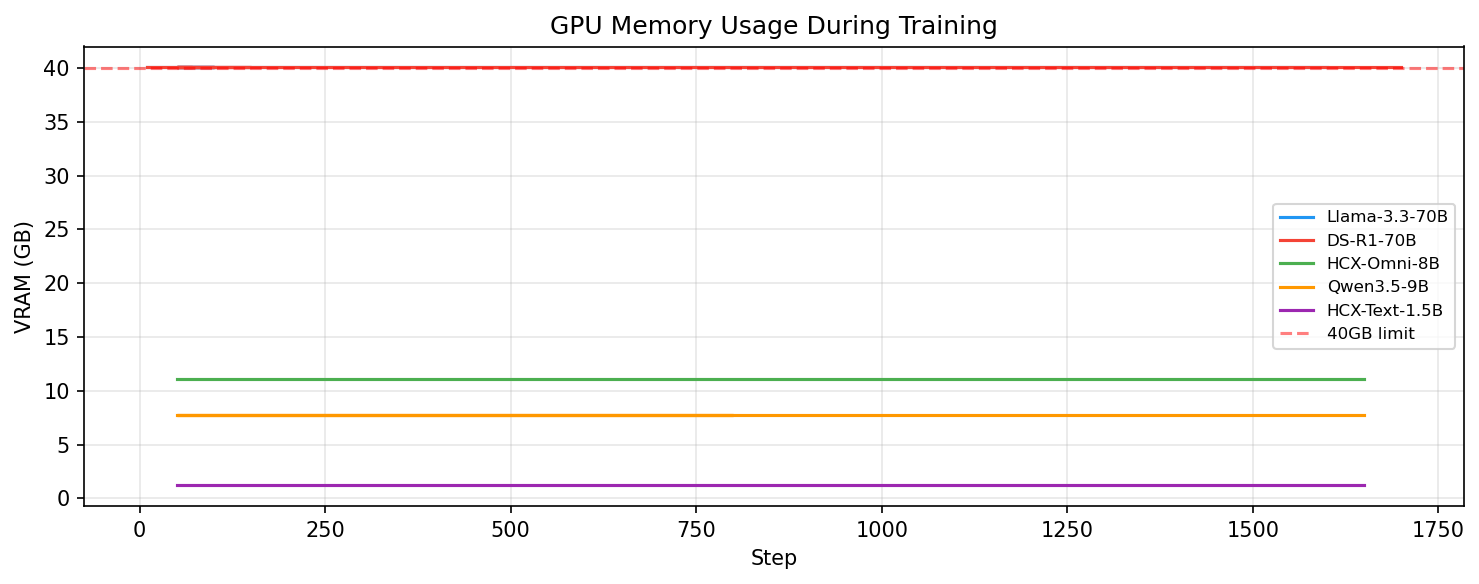
- 問題背景:隨著高品質清洗語料逐漸齊備,必須編寫驅動 Llama 3.1 模型深度微調的程式碼。面對個人電腦消費級顯示卡顯示記憶體嚴重不足的現實,團隊轉向 Google Colab 雲端 GPU 訓練環境。
- 推進過程:
「請編寫一份能在 Google Colab 上無縫執行 llama31_finetuning_experiment_plan_revised.md 的完整 Jupyter Notebook。」 「將訓練資料嚴格按 9:1 的比例切分為 Train/Val 集合,剔除多餘的 Test 切分以最大化訓練樣本量。」
- 成果沉澱:AI 自主解析了微調實驗方案,編寫了結構精煉的
llama31_finetuning_colab.ipynb指令碼。程式碼完美整合了 Unsloth 等前沿顯示記憶體輕量化微調框架,並穩固實作了 9:1 劃分、梯度累積與動態評估邏輯。
今天,我們以一場令人心驚肉跳的「API 帳單洗禮」跨越了真實世界的工程高牆。但作為回報,我們迎來了規整完備的合成訓練集以及專為 Colab 打造的自動化微調 Notebook。 終於,下一站我們將正式踏入大模型的 GPU 實際訓練征程!