[Maeumjigi 心語伴侶畢業專題開發日誌 #9] Llama 3.1 領域微調實戰排錯與第 6 週中期簡報答辯
· 閱讀時間約 3 分鐘

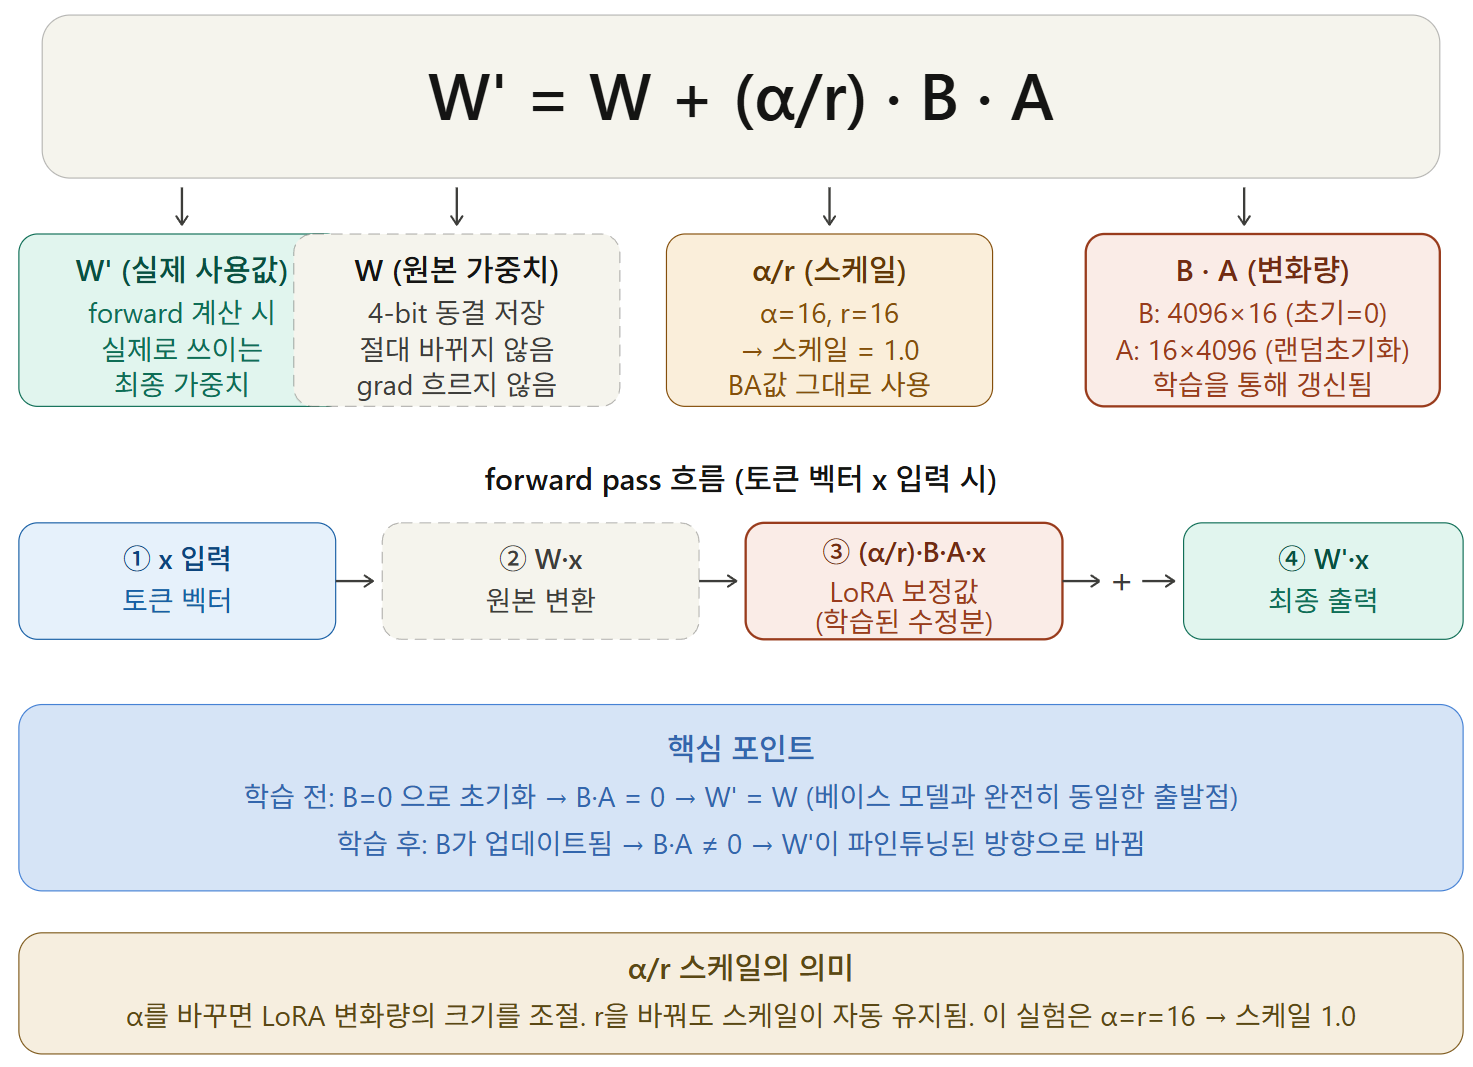
4 月 9 日,依托昨天完成的自動化 Notebook,我們終於迎來了人工智慧大模型 (Llama 3.1) 的首輪正式微調訓練。 然而現實充滿荊棘,無數報錯接踵而至。與此並行的,還有必須在深夜同步趕製第 6 週畢業專題中期簡報資料的極限挑戰。
雲端微調深陷報錯泥潭與技術攻堅
- 問題背景:在 Google Colab 上剛執行
llama31_finetuning_colab.ipynb,各色紅字報錯便鋪天蓋地而來。 - 推進過程:
「請分析在 llama31_finetuning_colab (3).ipynb 中執行 M1 微調時報錯的根本誘因是什麼?」 「推論測試產生的文本末尾殘留著未被解碼剝離的
<|eot_id|>和eos_token,為什麼會出現該截斷異常?」 - 成果沉澱:大模型在吐出長文本訓練資料時,因特殊截斷標記 (
eos_token) 未被正確遮罩以及 GPU 顯示記憶體 OOM 溢位等問題連環爆發。我們將完整的報錯堆疊日誌全量複製投餵給 Claude,開展多輪互動式排錯重構。歷經反覆除錯,訓練終於順利收官,成功匯出了直觀印證收斂趨勢的關鍵圖表학습데이터별학습결과.png(不同資料集下損失收斂對比圖)!
讓 AI 助理全權承接簡報 PPT 製作與資料庫 ERD 重構
- 問題背景:深夜緊盯模型收斂曲線的同時,下週一清晨就要面向教授進行第 6 週前端進展與資料庫架構中期簡報。
- 推進過程:
「Capstone_Week6_Frontend.pptx 包含了現階段的原型截圖。請據此撰寫本週簡報逐字稿與投影片骨架。」 「依據後端已落地的表結構產生實體關係圖 (ERD)……圖表層級過於臃腫分散,請嚴格將 User 核心表置中對齊重構。」
- 成果沉澱:令人驚喜的是,AI 自動將前端截圖整合成邏輯清晰的簡報逐字稿與投影片骨架。面對我們關於「將 User 使用者表置於視覺核心」的高強度多輪微調指令,AI 完美理清了多對多關聯與外部鍵條件約束,輸出了極其規範的資料庫架構關係全景圖。
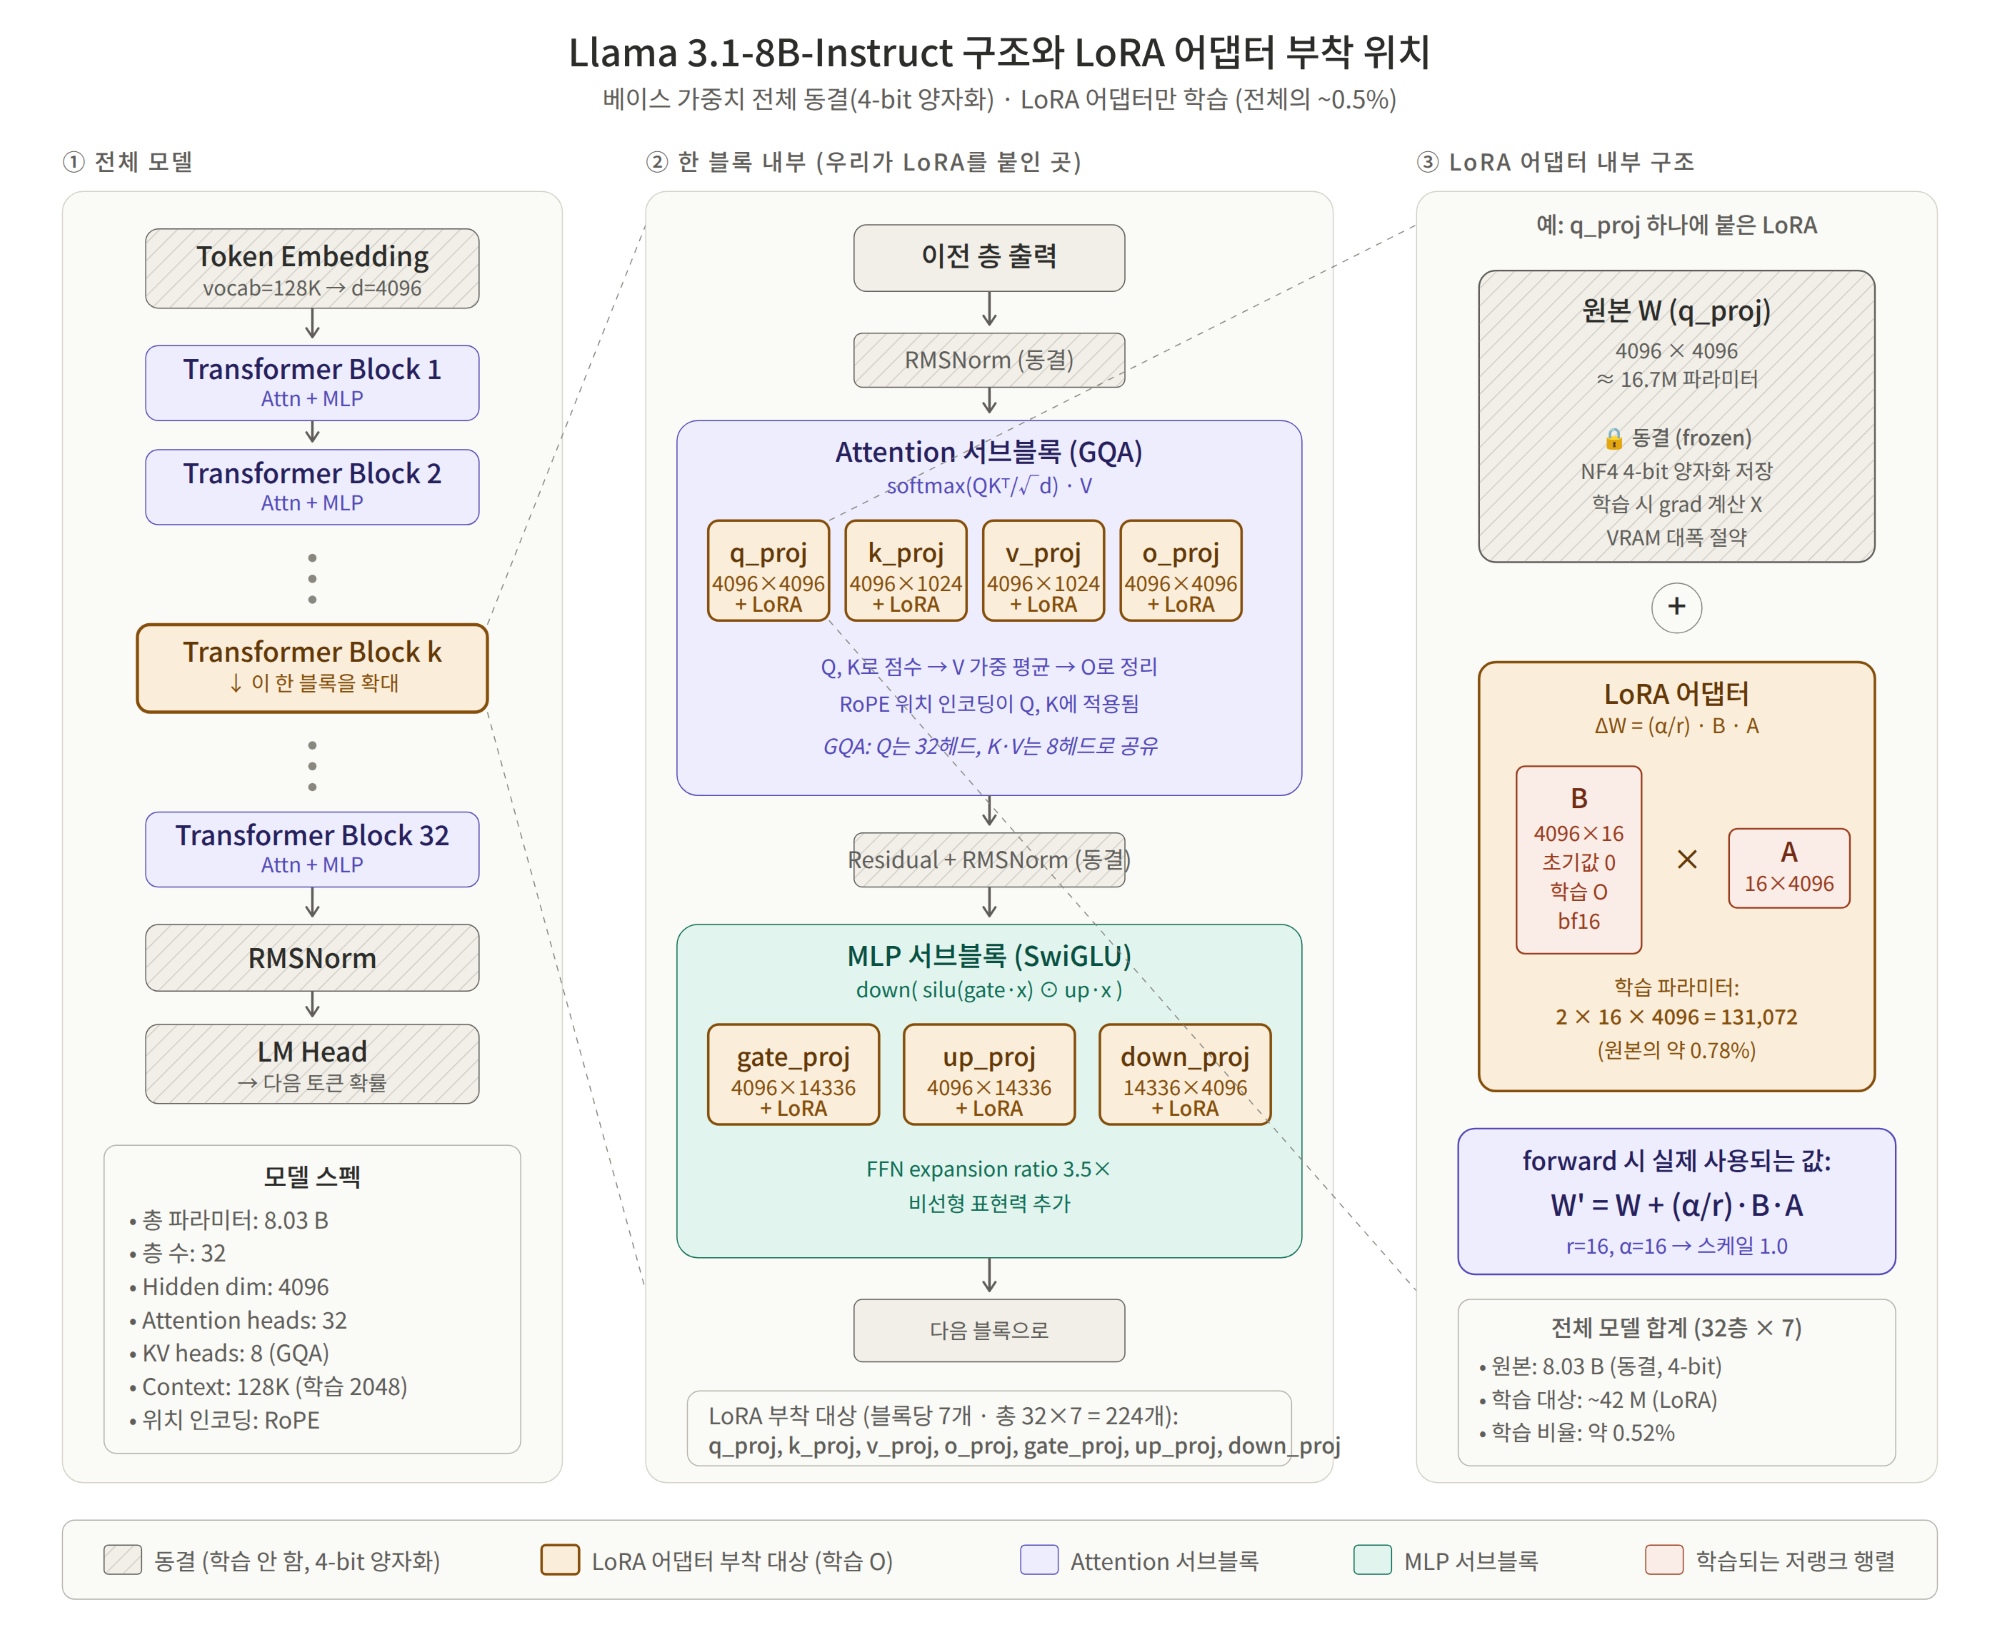
今天,我們真正體會到了親手駕馭最新開源基座 Llama 3.1 領域微調的巨大成就感。同時,也徹底解鎖了讓 AI 全面賦能「程式碼工程、簡報宣講、系統級 DB 架構圖設計」的綜合生產力極限。 經過微調洗禮的心語伴侶 AI 究竟進化得多麼敏銳聰慧?下期我們將全面揭曉定性推論評測戰報!