[Maeumjigi 心語伴侶畢業專題開發日誌 #13] 70B 算力瓶頸與中輕量級模型 (HCX, Qwen) 戰略迂迴

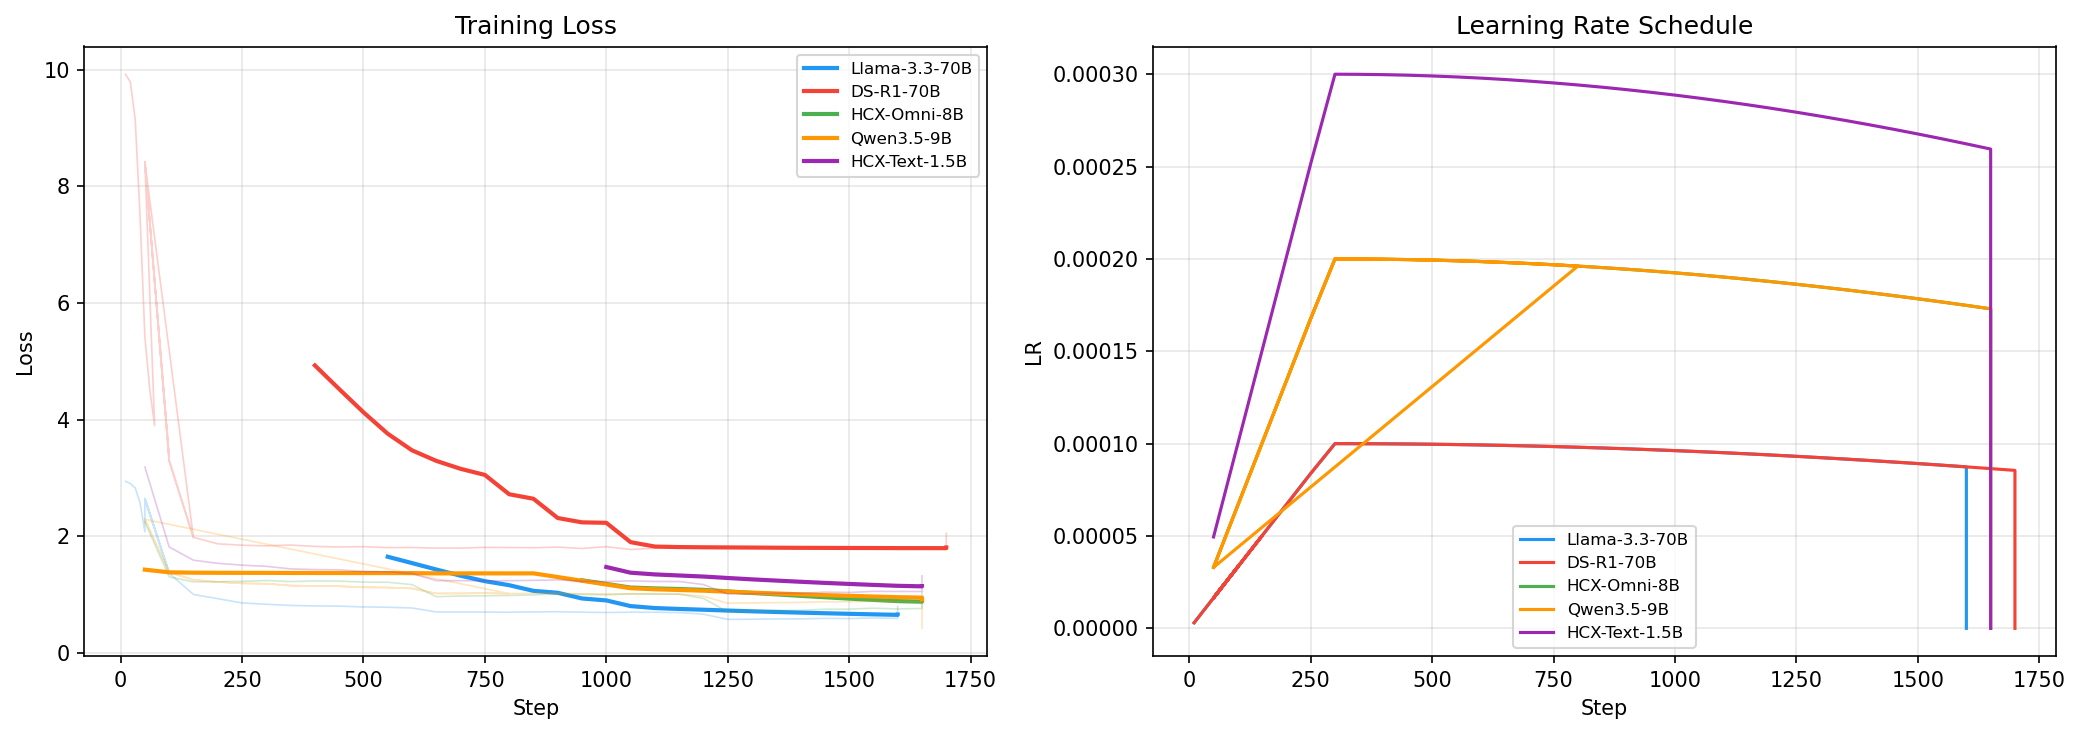
在領教了 70B 龐大參數量在微調過程中的顯示記憶體地獄後,5 月 4 日,我們果斷決定實施戰略轉向。
儘管我們曾透過將 Batch Size 壓榨至極限,勉強將 70B 模型(Llama 3.3, DeepSeek-R1)推到了 checkpoint-1200 與 1300,但極其漫長遲緩的訓練週期使得整體科研迭代效率極度低下。
戰略迂迴:轉向中輕量級基座模型(1.5B ~ 9B)
綜合考量物理 GPU 伺服器算力上限與畢業專題答辯截稿日期,全盤孤注一擲在 70B 巨型模型上顯然具有極高的延期風險。 為此,我們果斷調轉船頭,將微調實驗重點遷移至性價比極高、推論延遲更低的中輕量級開源模型矩陣:HCX-Omni-8B、Qwen35-9B 以及 HCX-Text-1.5B。
「當前針對 HCX-Omni-8B、Qwen35-9B 與 HCX-Text-1.5B 設定的超參數訓練週期依然過長,業內針對該尺寸模型的經典超參數分布是怎樣的?」 「盲目上調 Batch Size 會對心理對話任務的收斂穩定性與泛化能力帶來何種衝擊?」
參數體量變小並不意味著萬事大吉。為了在安全顯示記憶體下跑出最高吞吐,我們逐步微調 Batch Size 與梯度累加步數,與 AI 展開深度技術辯論以尋覓最佳超參數平衡點。我們率先完成了最小尺寸模型 HCX-Text-1.5B 的基準收斂評測,藉以校準全盤微調的技術航向。
檢查點持久化異常與底層系統核心相容性暗礁
在推進 HCX-Omni-8B 順利訓練至第 50 步並嘗試自動序列化保存檢查點時,系統迎面撞上了另一塊隱蔽的技術暗礁:
[RANK 0] Detected kernel version 5.4.0, which is below the recommended minimum of 5.5.0; this can cause the process to hang.
...

JSONDecodeError Traceback (most recent call last)
---> 60 trainer.train(resume_from_checkpoint=...)
控制台不僅警告 Linux 作業系統核心版本偏低可能導致分散式程序假死掛起,更拋出了致命的 JSONDecodeError——檢查點中繼資料檔案在寫入磁碟瞬間發生並行損壞,導致訓練無法平滑接續。
「如果模型在雲端訓練中途意外崩潰中斷,能否從最近完好的檢查點精準斷點續訓?」
雖然 Hugging Face Trainer 原生支援斷點恢復 (resume_from_checkpoint),但一旦檢查點檔案本身在斷電或並行寫入磁碟時損壞,整輪訓練便前功盡棄。即使模型尺寸已經大幅縮減,深層框架與底層基礎設施的種種相容性隱患依然讓我們鏖戰了一整天。
我們究竟能否成功跨過暗礁,將中輕量模型穩穩送入高效收斂軌道?