[Maeumjigi 心語伴侶畢業專題開發日誌 #14] 全模型微調圓滿收官與多卡平行推論評估 (Eval) 管線建置
· 閱讀時間約 2 分鐘

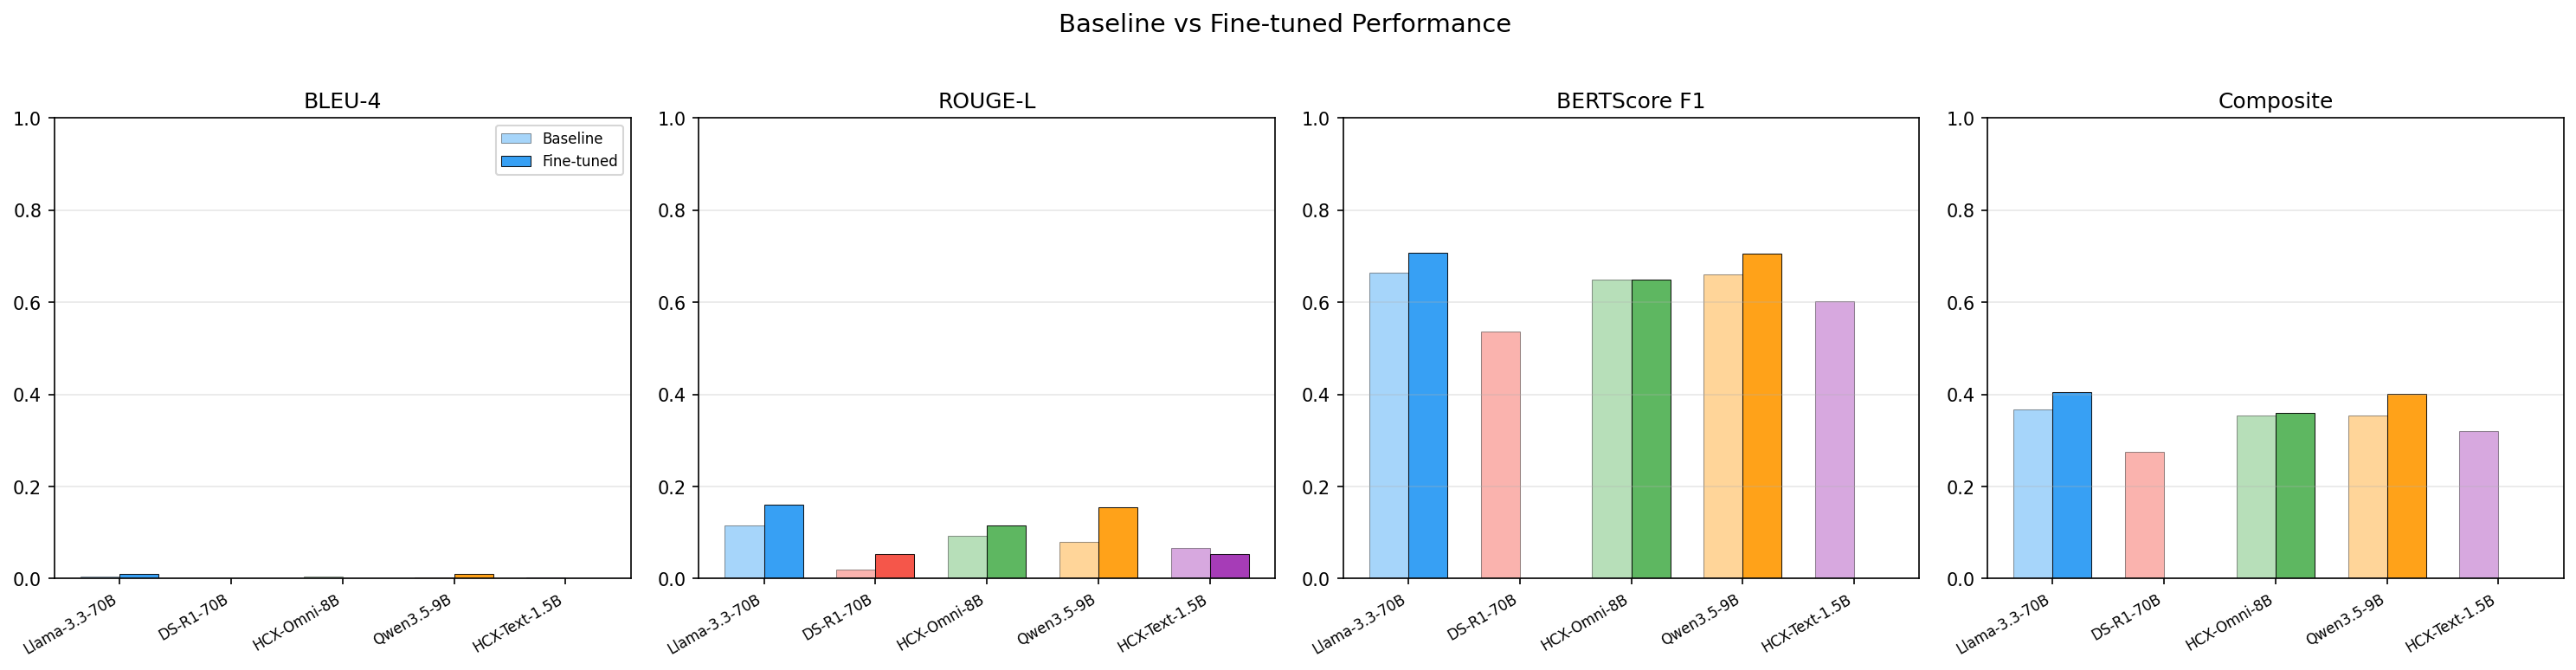
5 月 6 日,歷經數個不眠之夜與超參數反覆調試,我們終於從漫長的微調泥潭中成功破局! 以 HCX-Omni-8B 與 Qwen35-9B 為代表的中輕量級垂直大模型全量微調順利收斂完工。
微調圓滿收工:收斂日誌與損失曲線分析
伴隨訓練步數穩步推進,系統損失 (Loss) 呈現出極其穩健的單調下降收斂態勢:
step= 1200  loss=0.9698  lr=1.88e-04  gpu=7.7GB
step= 1250  loss=0.8523  lr=1.86e-04  gpu=7.7GB
...
step= 1650  loss=0.8783  lr=1.73e-04  gpu=7.7GB
在審視日誌期間,團隊曾反覆向 AI 確認損失打點細節:「當前輸出的是 Train Loss 還是 Eval Loss?我們的監控指令碼是否同步記錄了驗證集指標?」鑑於模型已完整完成所有 Epoch 訓練(「全量微調全部圓滿完工,全面轉入結果綜合評估」),我們依據產生的最新權重檢查點,立即邁向定性推論與定量評估 (Eval) 階段。
雙卡 GPU 負載平衡:建置全自動多卡平行推論管線
依托 20_eval_ft_models.ipynb 指令碼,我們對各大模型針對典型心理傾訴提示詞的產生品質展開盲測。為了支援長程同理心引導,我們將最大產生長度 (max_new_tokens) 統一放寬至 1024。
但在初測時,單卡推論延遲遠超預期:
「訓練時我們明明掛載了兩塊高階顯示卡,為何推論評測只單卡跑,速度這麼慢?」
為了 100% 榨乾伺服器的算力潛能,在 AI 的協同重構下,我們全新編寫了多行程平行推論管線 run_eval_parallel.sh。此舉將基準測試耗時壓縮了數倍,更實作了將各模型的產生文字、回應時延與困惑度 (Perplexity) 全自動彙總匯出為結構化 Excel 報表的高階管線。
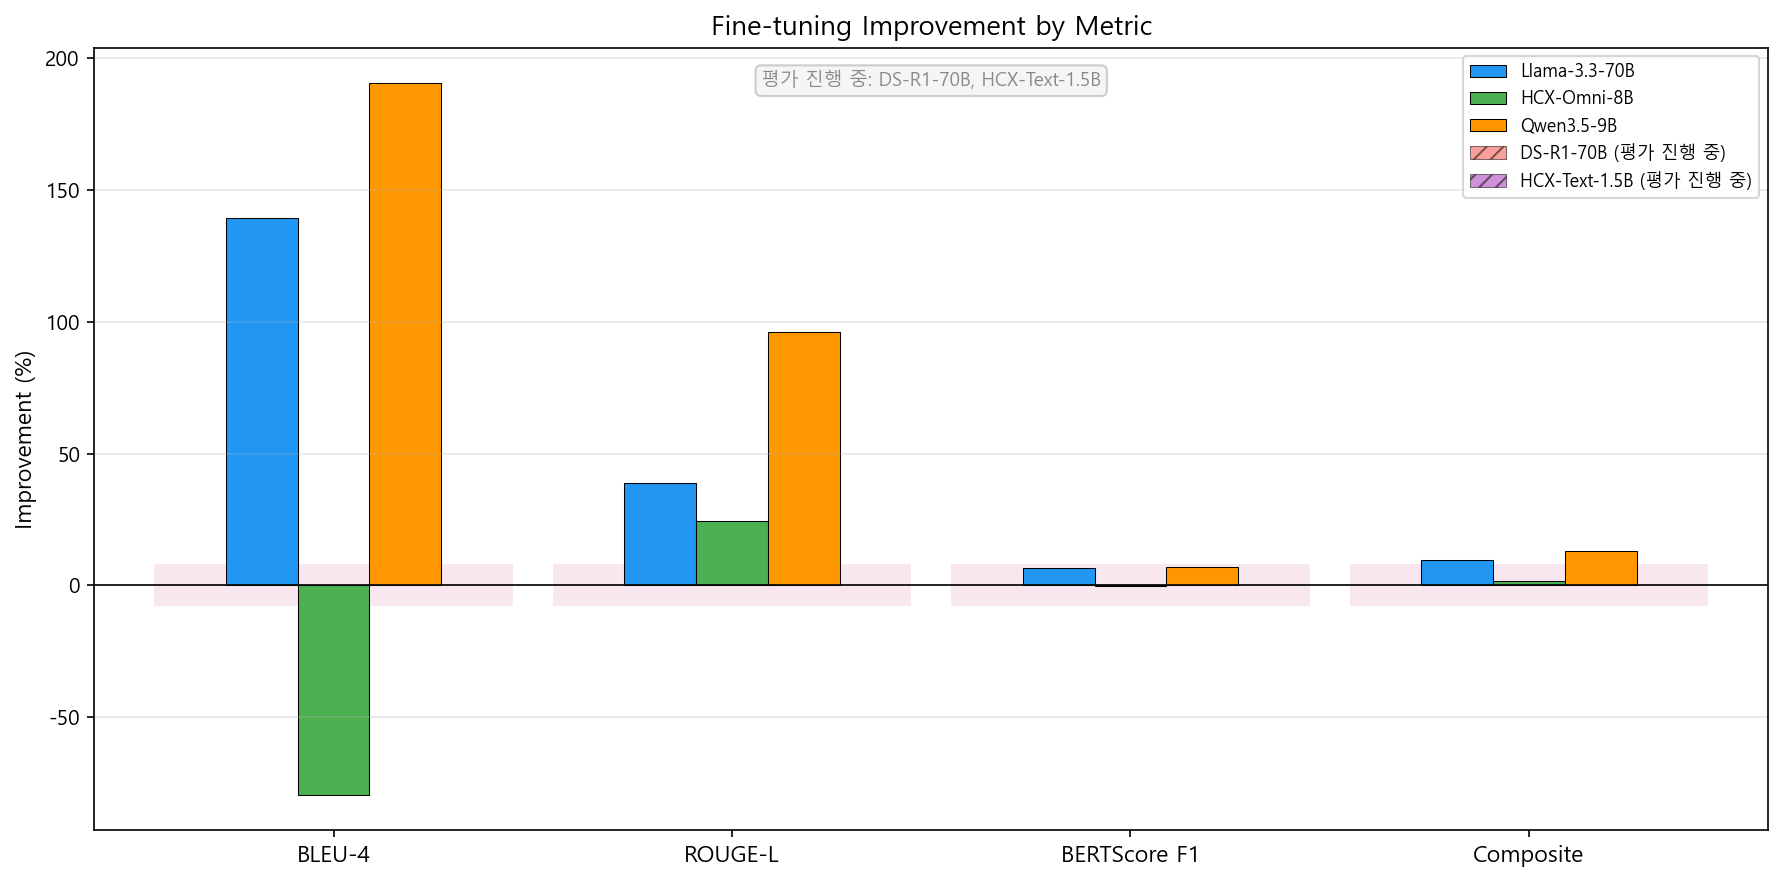
儘管在從 DSR1-70B 切換至下一個模型時曾因 PyTorch 顯示記憶體未完全垃圾回收 (GC) 拋出顯示記憶體佔用衝突,但透過平行指令碼的環境行程隔離設計,該問題被徹底根治。現在,終於到了真刀真槍對比各模型應答水準的決戰時刻!