[Maeumjigi 心語伴侶畢業專題開發日誌 #17] 第二輪微調勝利收官與自動化評估管線的硬編碼陷阱

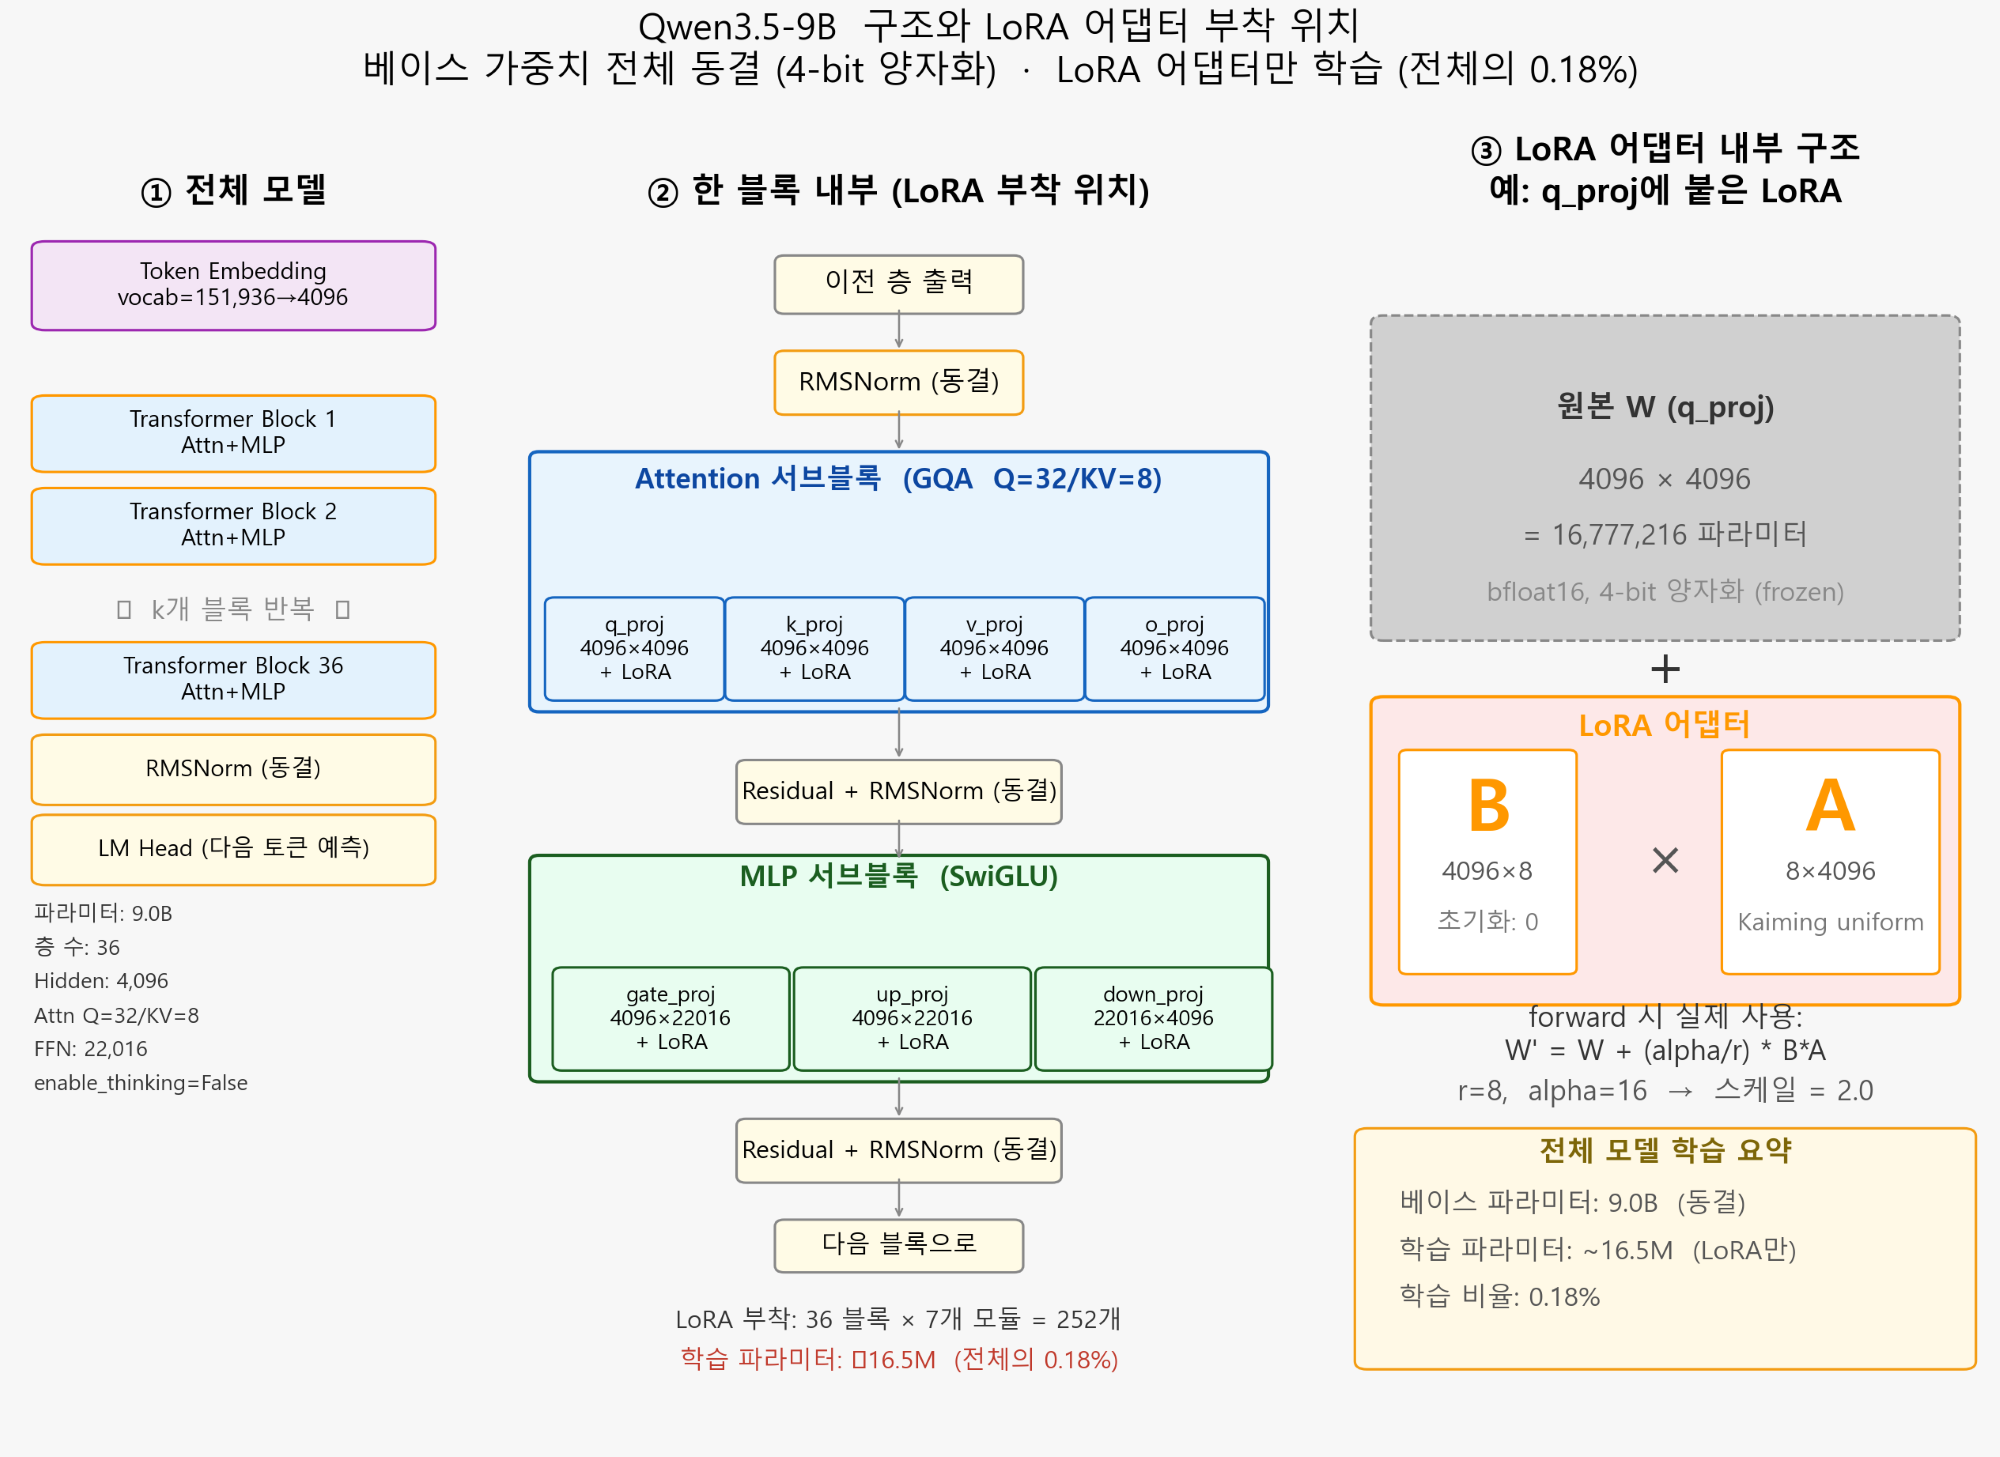
為了撥亂反正、糾正 LoRA 超參數配比倒置而倉促啟動的第二輪微調 (fine_tuning_2) 多卡平行長跑,終於在 5 月 12 日迎來了勝利的曙光!
萃取最佳檢查點 (Best Checkpoint) 與端到端推論管線組裝
涵蓋 3 大模型、6 組超參數組合的矩陣微調全量收斂。我們比對驗證集損失 eval_loss,提取出泛化能力最強的第一梯隊檢查點,歸檔至各模型對應的 adapter 目錄。
為了在背景全自動串接批次處理推論 (Eval) 與結果對比 (Comparison),我們編寫了 run_test_20_30.sh 指令碼:
「當前 HCX-Text-1p5B 模型在 15 分鐘內僅輸出了 12 筆產生結果,GPU 顯示記憶體利用率僅有 1.6GB……」
推論吞吐卻再次陷入令人絕望的龜速泥潭。即便針對參數量僅 1.5B 的極輕量模型,平均每分鐘也吐不出完整的一句話。顯示記憶體利用率長期徘徊在 1.6GB 低位,究其根源在於推論端 Batch Size 被死死鎖死為 1。加之伺服器磁碟空間告警,被迫緊急將專案根目錄整體遷移至 ~/home/data/temporary/,修改了全套指令碼路徑。
樂極生悲:跌入自動化管線的「硬編碼陷阱」
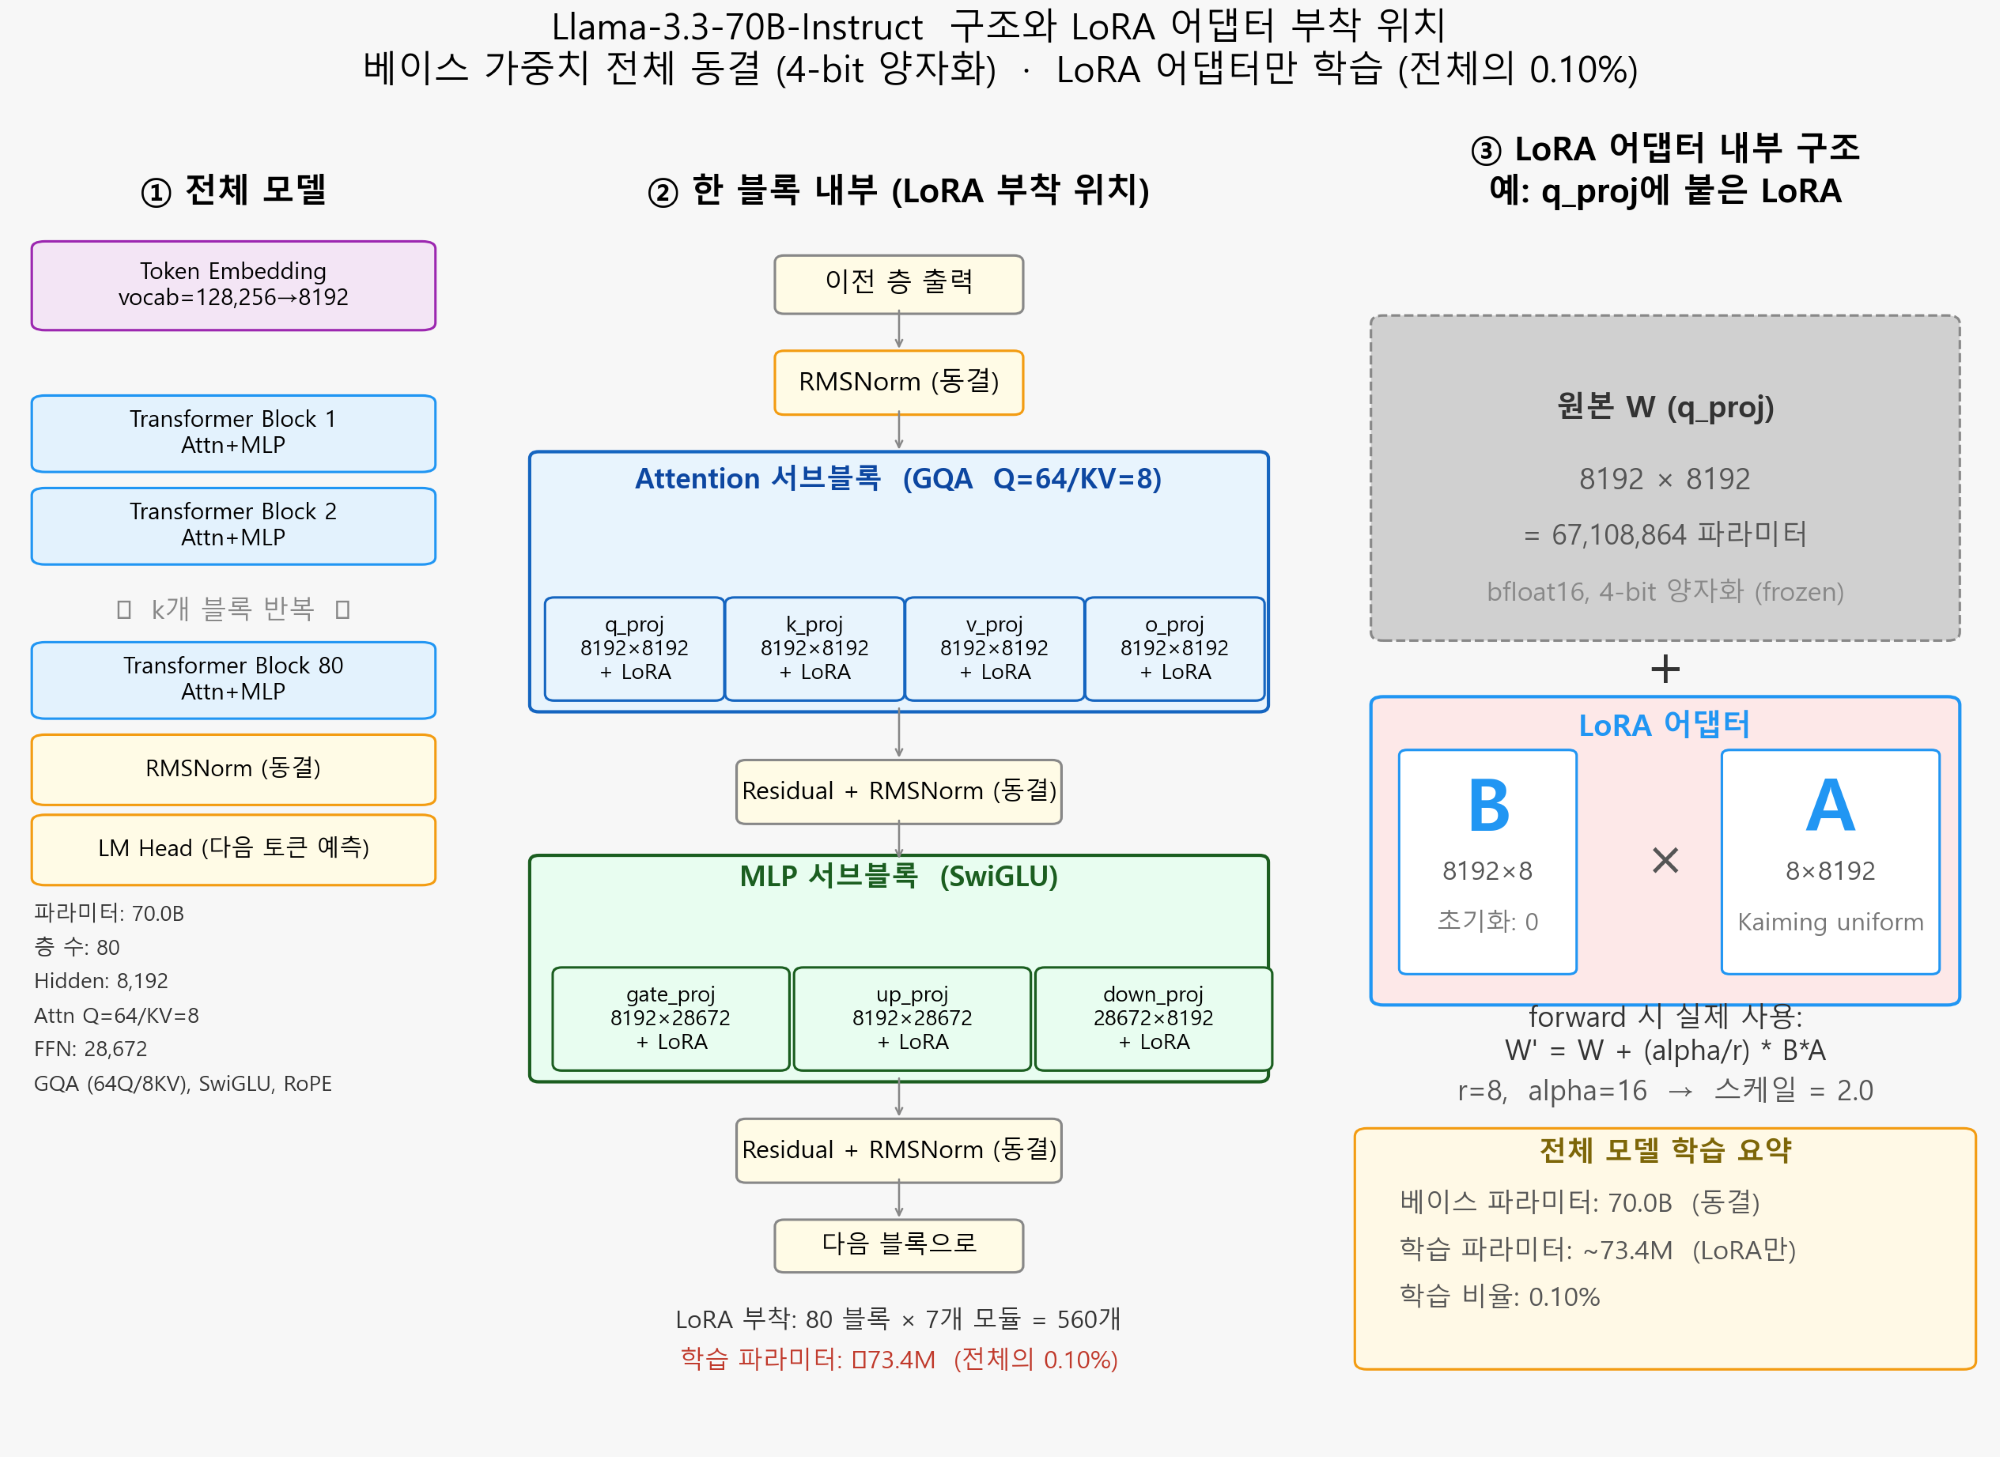
在費盡周折將所有耗時評估指令碼跑完後,團隊卻在程式碼審查時赫然發現了一個令人窒息的隱蔽 Bug:
「為什麼在 20_eval_ft_models.ipynb 中,模型別名居然被死死硬編碼為了 MODEL_ALIAS = 'Qwen35-9B_a16'?!」 「這意味著在伺服器日誌中,即使執行的是 20_eval_HCX-Text-1p5B_a8.ipynb,程式碼底層載入的仍然是 Qwen35-9B_a16?!指令碼檔案名和實際推論模型完全兩碼事?!」
是的,在編寫自動化批次處理範本時,開發者一時疏忽遺留了固定別名硬編碼。表面上指令碼為 HCX 每次都克隆並衍生了獨立的 Notebook,但底層程式碼卻始終單調地載入著 Qwen35-9B_a16 的權重反覆進行著無效重複推測!
這再次印證:大模型深度微調不僅是高深的科學探索,更是對工程細緻度的終極考驗。立刻動手撲滅硬編碼 Bug,重跑推論管線!