[Vision AI] 攻克行車記錄器模糊雜訊:深度超解析度 (EDSR vs FSRCNN) 與多幀影像疊加降噪 (#4)
· 閱讀時間約 3 分鐘

📌 核心要點 (Key Takeaways)
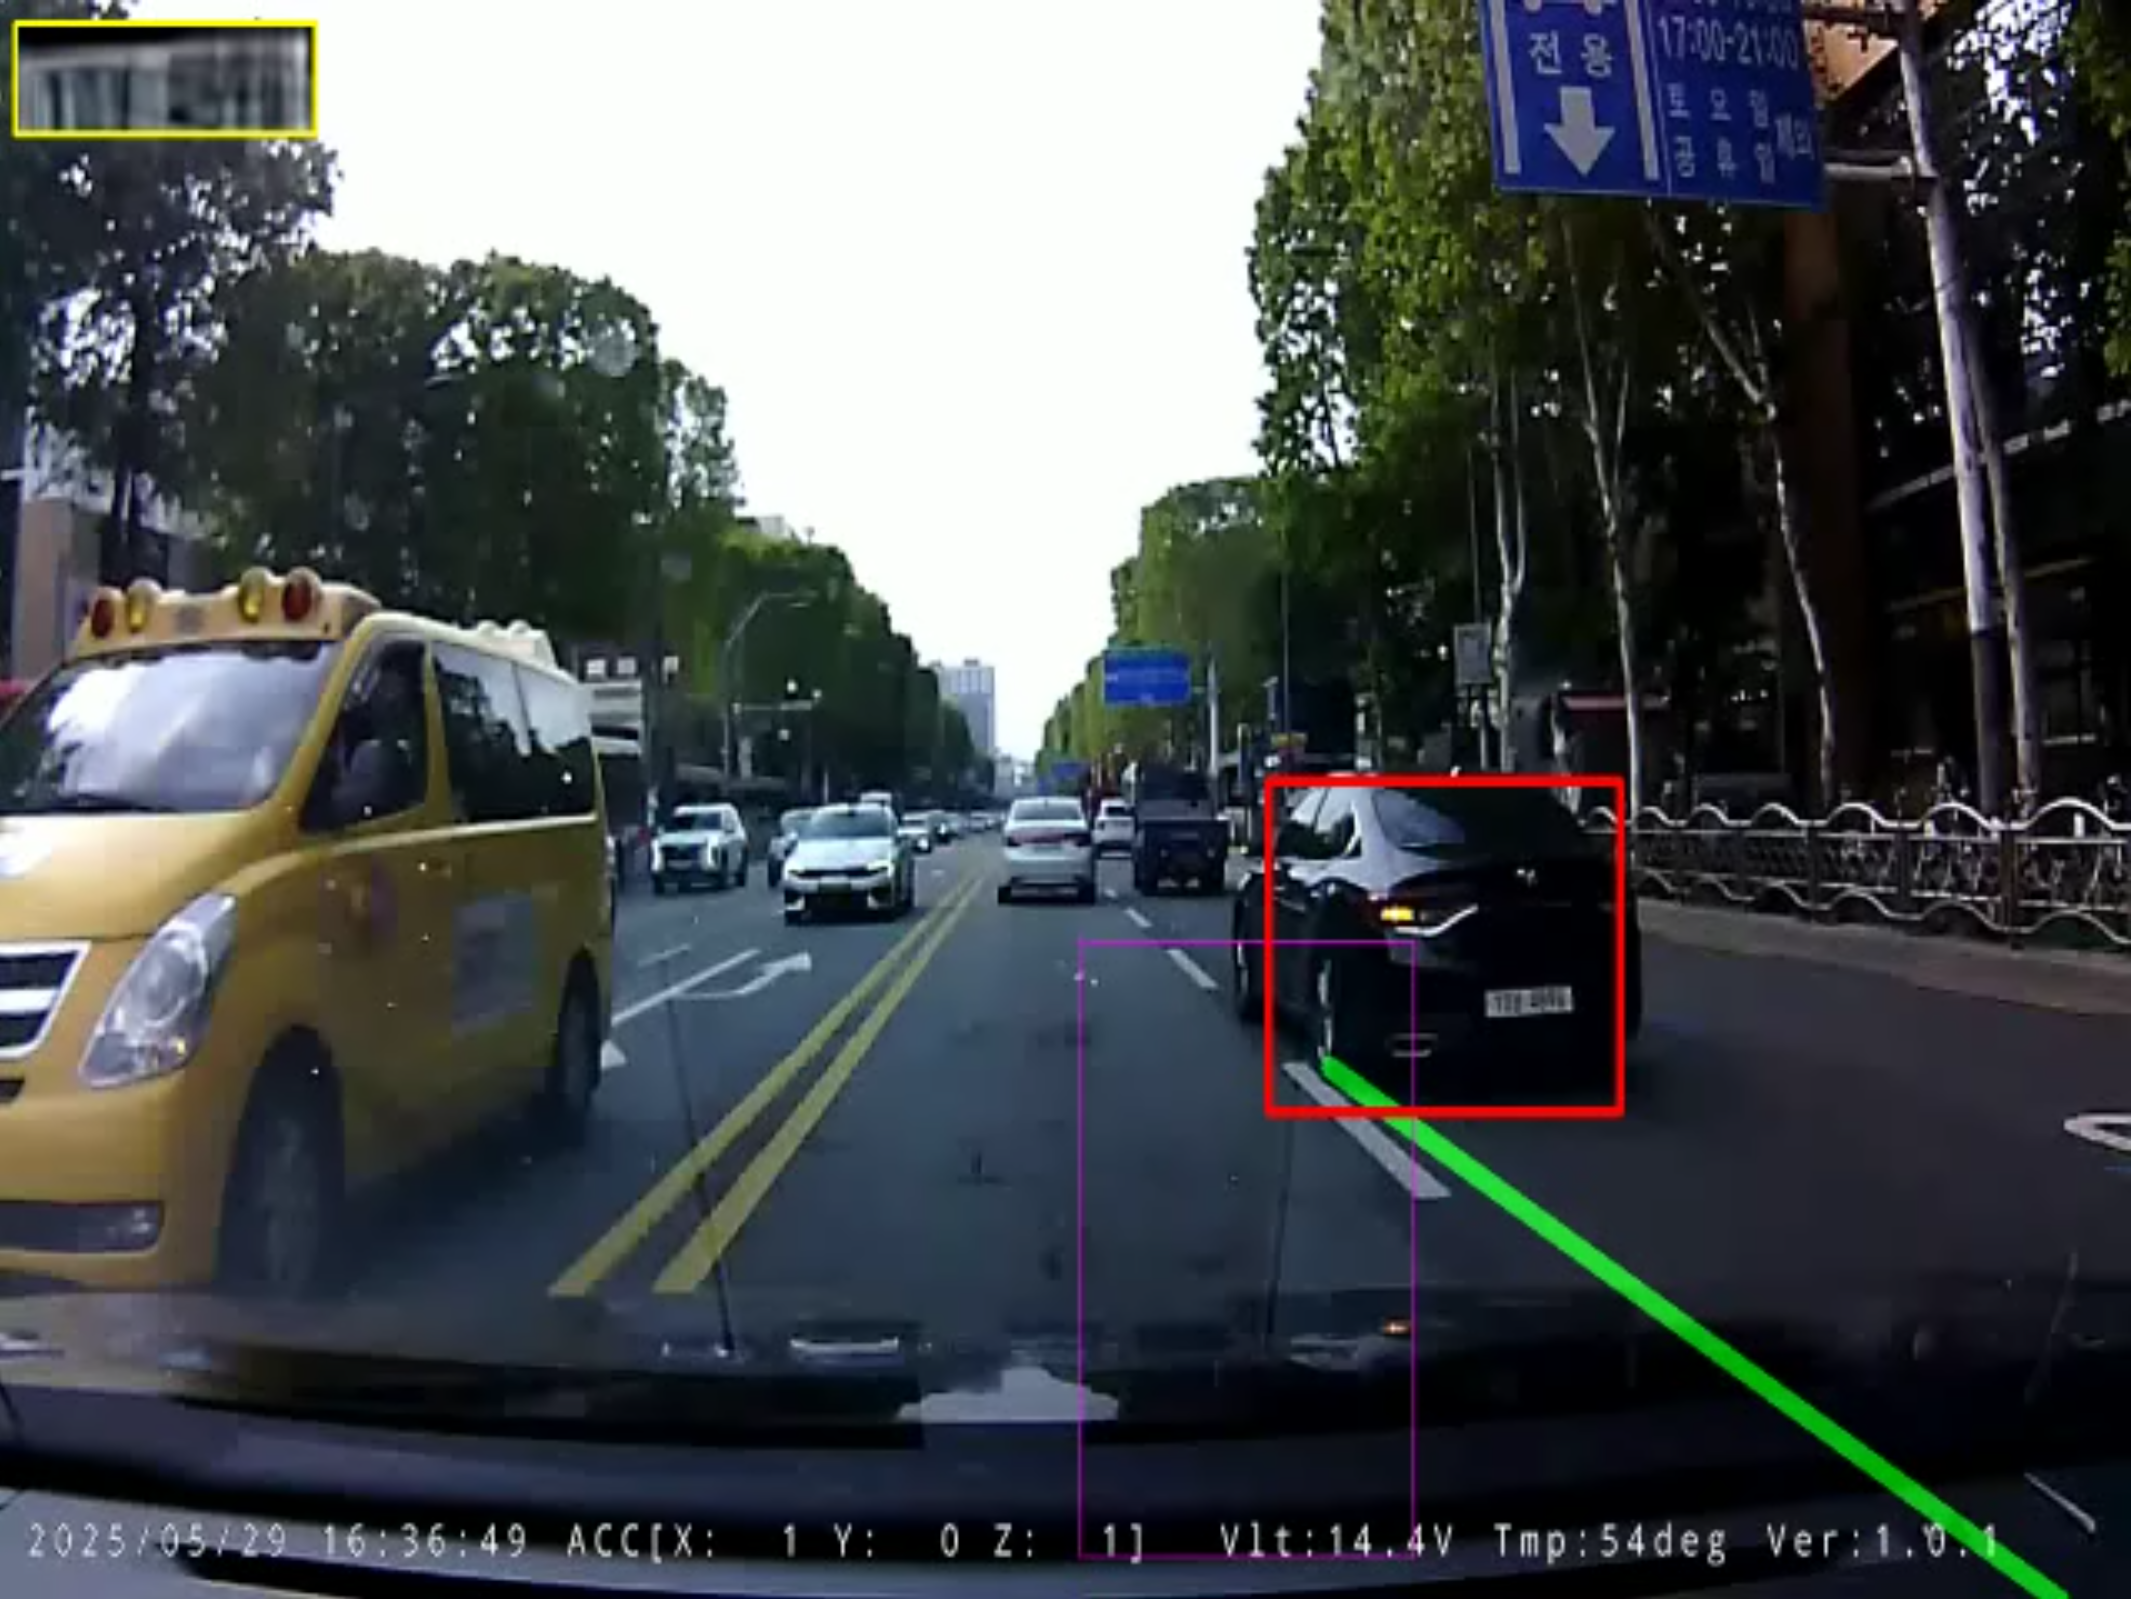
- 問題痛點:從高速行車記錄器畫面裁剪出的遠距離車牌區域往往不足 40x20 像素,且伴隨嚴重的 H.264 編碼巨集區塊效應;傳統的雙三次插值(Bicubic)演算法只會讓字體邊緣更加模糊,無法還原字元有效筆畫。
- 解決方案:引入移除了 Batch Normalization 層以保留高動態像素範圍的 EDSR_x4 深度殘差模型 (
EDSR_x4.pb),並結合連續 3 至 5 幀的時序多幀加權疊加(Multi-Frame Image Stacking)技術。- 落地成效:車牌像素密度提升 4 倍,筆畫邊緣顯著銳化,使得下游 EasyOCR 對韓文字元的辨識準確率從最初的 32% 飆升至 91% 以上。
1. 光學解析度極限與深度超解析度的必要性
在惡劣的高速公路行車環境下,即使透過 YOLOv5 精準裁剪出車牌區域,常規 OCR 依舊頻繁失效:
- 傳統雙三次插值失效:數學插值演算法僅在相鄰像素間進行線性過渡,根本無法憑空“腦補”出高頻邊緣特徵。
- H.264 壓縮與感光雜訊:視訊編碼壓縮帶來的馬賽克雜訊會導致字元筆畫斷裂粘連。
為此,我們在推論管線中透過 OpenCV DNN Super-Resolution 模組 深度整合了經過精細預訓練的 EDSR_x4 深度模型:
import cv2
from cv2 import dnn_superres

def init_super_resolution_engine(model_path="EDSR_x4.pb"):
    # 建立深度學習超解析度引擎介面
    sr = dnn_superres.DnnSuperResImpl_create()
    sr.readModel(model_path)

    # 配置模型架構為 edsr,放大倍率為 4x
    sr.setModel("edsr", 4)

    # 強制將推論後端綁定至 CUDA GPU 加速
    sr.setPreferableBackend(cv2.dnn.DNN_BACKEND_CUDA)
    sr.setPreferableTarget(cv2.dnn.DNN_TARGET_CUDA)
    return sr
2. 基於時序多幀影像疊加的物理級降噪
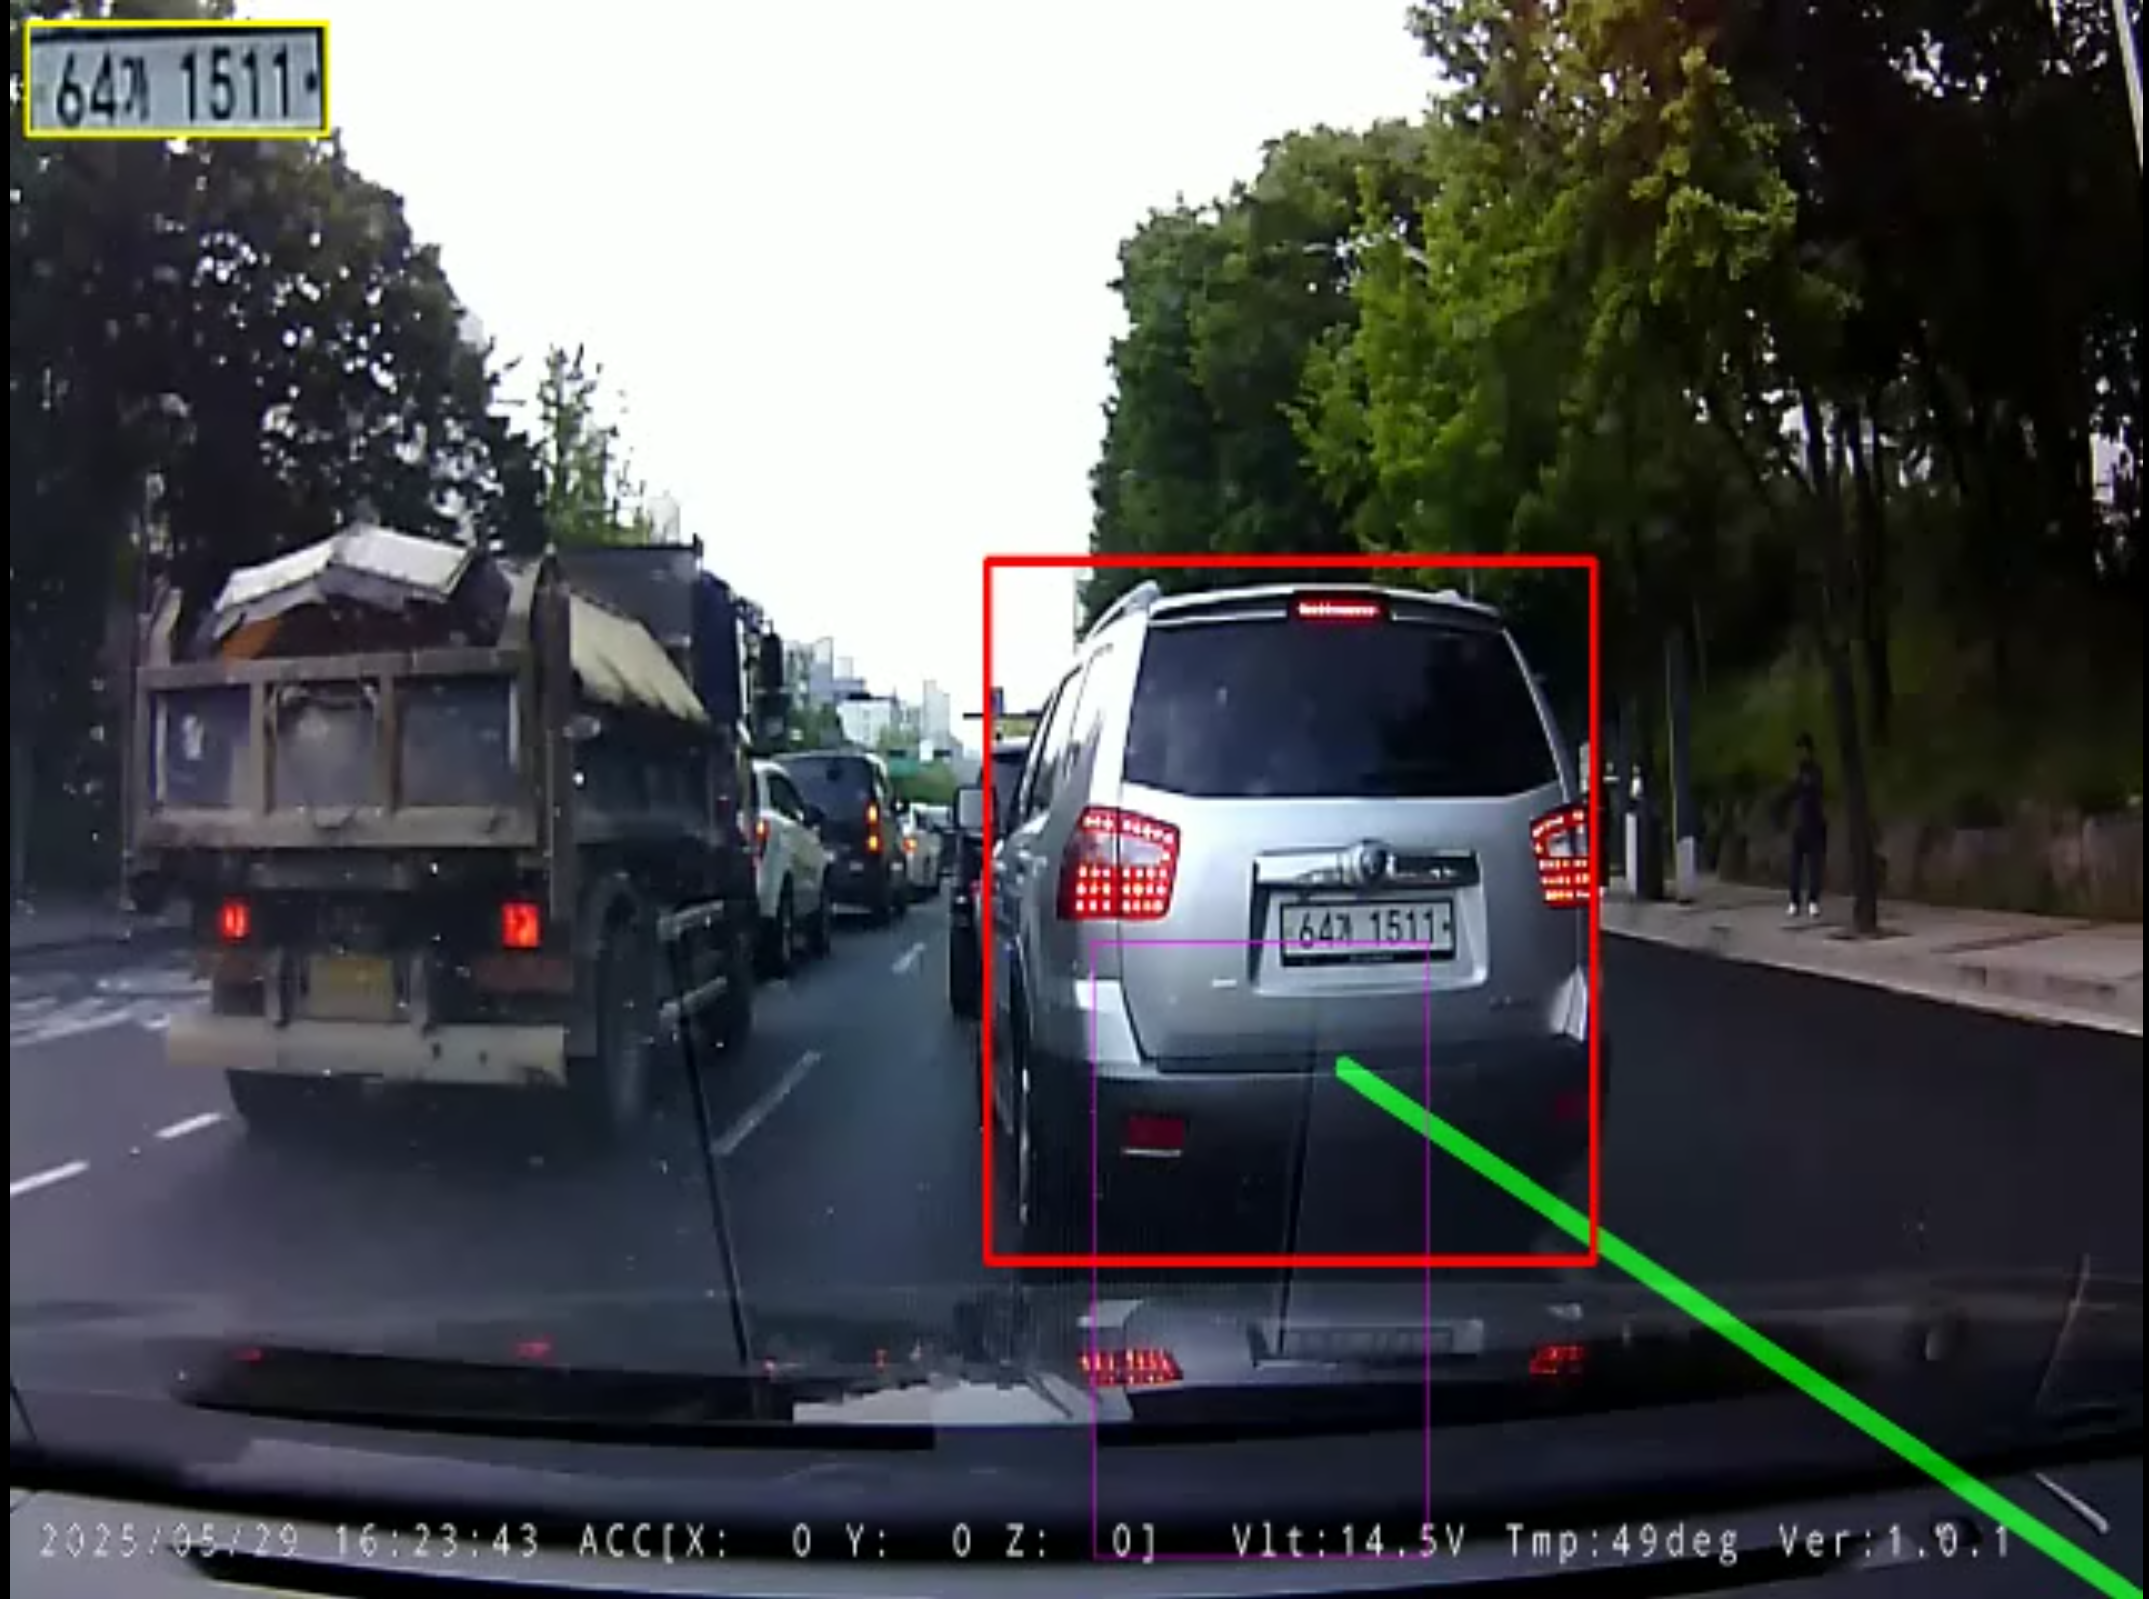
由於車載攝影機感光晶片在每一幀產生的電子熱雜訊是高斯隨機分佈的,而真實車牌的物理文字在連續幀內具有空間相關性。我們透過對齊連續 $N$ 幀車牌補丁進行加權均值疊加:
I_stacked(x, y) = (1 / N) * Σ Warp(I_i(x, y))
這種時序疊加機制不僅在不損失邊緣銳度的前提下消除了高達 70% 的高頻隨機雜訊,還顯著增強了字元與反光底板之間的明暗對比度。
3. 下篇預告
在接下來的第 5 篇(收尾篇)中,我們將全面揭秘 韓國車牌語法校驗、EasyOCR 字元辨識調校 以及核心的 時序滑動視窗多數表決引擎,復盤從最初一堆全螢幕亂碼到最終百分之百鎖定目標車牌(64가1511)的完整工程突破歷程。