Stanford CS329A (第11講): Agent Memory — 智慧體長短期記憶與作業系統式分層架構 (MemGPT, Cartridges, CacheBlend)

當開發者將自主AI智慧體作為長期協同夥伴或自主軟體工程師投入實際生產時,無一例外會遭遇三個令人沮喪的架構瓶頸:
- 「智慧體完全遺忘了昨天多輪對話中敲定的核心系統架構設計決策。」
- 「將包含十萬行代碼的企業代碼庫直接塞進百萬Token的上下文視窗,導致了嚴重的注意力彌散(Lost-in-the-Middle迷失中間現象),每次互動產生高昂的API費用。」
- 「在RAG檢索增強生成場景中拼接多篇檢索文檔切片時,現有的前綴鍵值快取(KV Cache)全部失效,首Token生成延遲(TTFT)飆升至數秒以上。」
人類大腦在這方面展現了絕妙的工程解法:生物腦僅擁有極其微小的物理工作記憶(僅能容納4到7個離散資訊塊),卻能在一瞬間從長時記憶中精準檢索數十年前的知識,並在多領域資訊間自如融合而不會產生認知癱瘓。
在Stanford CS329A: Self-Improving AI Agents的第三部分:智慧體工程(Part 3: Agent Engineering)中,本講聚焦於Agent Memory Architecture(智慧體記憶架構),深入剖析賦予AI系統持久化、分層化記憶的三大核心抽象層級:
- 軟體控制層 (MemGPT, UC Berkeley 2023): 借鑑作業系統虛擬記憶體分頁機制的分層記憶管理。
- 神經網絡表徵層 (Cartridges, 2025): 透過自主學習(Self-Study)與上下文蒸餾,將海量文本壓縮為即插即用的連續KV快取向量。
- 系統基礎設施層 (CacheBlend, EuroSys 2025): 恢復文檔間交叉注意力,使RAG首Token延遲降低3.3倍的選擇性KV快取融合。
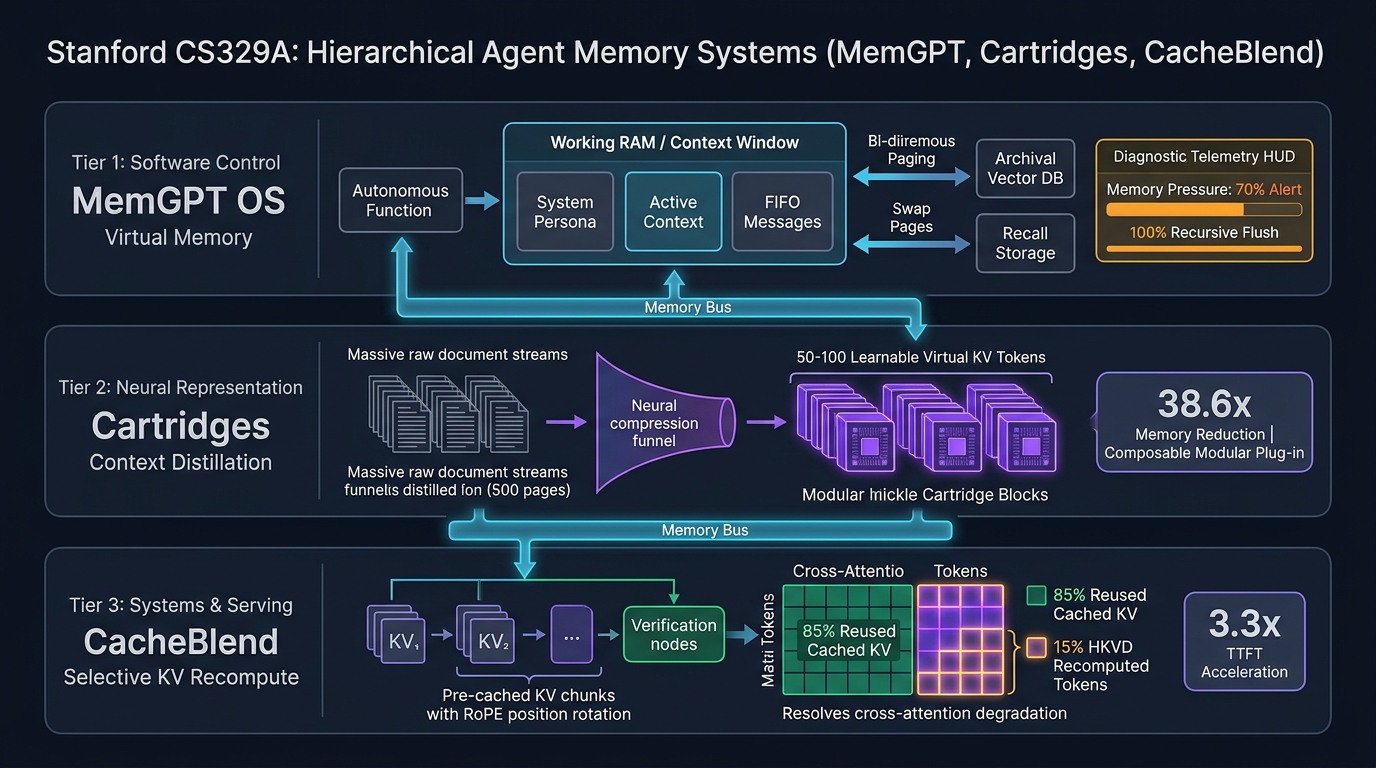
1. 長上下文困境與分層記憶的必然性
僅僅依靠暴力擴展大型語言模型的物理上下文視窗(如從8k擴展到1M+ Token),並不能真正解決智慧體的記憶難題。盲目拉長上下文會引發三個根本性失效:
- 注意力耗散與中間迷失 (Lost-in-the-Middle): Transformer自注意力分佈隨著長度激增而趨於平坦,模型極易忽略掩埋在超長Prompt正中間的細微關鍵證據。
- 經濟不可持續性: 每次對話輪次都全量重傳幾十萬Token,會導致算力預算呈指數級枯竭。
- 靜態瞬態性: 一旦單次推理結束,模型的中間激活態立即消散,智慧體無法在無需外界干預的情況下自主更新內部狀態。
為實現長程自主運作,現代先進智慧體採用Hierarchical Context Management(分層上下文管理),將高頻的**工作上下文 (Working Context)與海量的持久儲存 (Long-Term Storage)**進行解耦。
┌─────────────────────────────────────────────────────────────────────────┐
│               智慧體記憶系統的三大抽象分層架構                          │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│       軟體控制層         │  │     神經網絡表徵層       │  │     系統基礎設施層       │
│         (MemGPT)         │  │       (Cartridges)       │  │       (CacheBlend)       │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • 作業系統式虛擬分頁     │  │ • Self-Study上下文蒸餾   │  │ • 多文檔切片RAG無縫合併  │
│ • 主上下文視窗 (RAM)     │  │ • 連續可微KV快取嵌入     │  │ • 選擇性KV重計算 (15%)   │
│ • 歸檔向量資料庫 (Disk)  │  │ • 顯存佔用驟降 38.6倍    │  │ • RoPE旋轉座標矩陣重構   │
│ • 自主驅逐與遞迴摘要機制 │  │ • 推理吞吐量提升 26.4倍  │  │ • 首Token延遲(TTFT)降3.3x│
│ • 深度長時記憶召回率 92% │  │ • 樂高積木式模組化插拔   │  │ • F1準確率誤差 < 0.01    │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. 軟體控制層: MemGPT (UC Berkeley 2023)
現代計算機作業系統早在數十年前就解決了有限硬體記憶體的調度難題。作業系統透過記憶體管理單元(MMU),在高速物理RAM與大容量磁碟之間透明地換入換出(Swap-in / Swap-out)虛擬記憶體頁,從而為程式設計師提供了無限記憶體的抽象。
加州大學柏克萊分校Packer等學者提出的MemGPT Long-Term Memory將這一作業系統哲學完整引入大型語言模型架構:
「大模型的上下文視窗就是物理記憶體(RAM)。外部的向量資料庫與SQL記錄就是硬碟。透過為模型配備函數調用(Function Calling)原語,使其能夠自主檢查、修改、驅逐並檢索記憶,模型自身便成為了管理記憶的作業系統。」
    ┌────────────────── [主上下文 (RAM: 8k~128k Token 物理視窗)] ─────────────────┐
    │ 1. System Instructions : 系統身分準則與記憶體操作函數說明書 (唯讀)          │
    │ 2. Working Context     : 使用者畫像、不變事實與工作狀態 (讀/寫)              │
    │ 3. FIFO Message Queue  : 最近對話佇列 + (置於佇列頭部的遞迴歷史摘要)         │
    └─────────────────────────────────────────────────────────────────────────────┘
                               ▲                      │
                (換入 / Search)                       │ (換出 / 驅逐與持久化)
                               │                      ▼
    ┌───────────────── [外部儲存 (Disk: 無容量上限持久層)] ───────────────────────┐
    │ 1. Recall Storage   : 帶精確時間戳的全局歷史對話記錄庫 (PostgreSQL)          │
    │ 2. Archival Storage : 海量文檔與企業知識圖譜向量資料庫 (HNSW pgvector)       │
    └─────────────────────────────────────────────────────────────────────────────┘
自主記憶體分頁機制
MemGPT顛覆了傳統外部腳本強行截斷對話的做法,將記憶控制權完全交由模型自主裁決:
- 記憶體壓力警報 (70%閾值): 當上下文填充達到視窗容量的70%時,系統靜默注入一條系統中斷提示:
「警告:當前工作記憶體已達70%。請在歷史記錄被強制驅逐前,調用
working_context.replace()固化核心關鍵資訊。」 - 自動驅逐與遞迴摘要 (100%強制換出):
- 當上下文達到100%極限時,FIFO佇列管理器介入,剝離出最古老的50%對話記錄。
- 剝離時並非簡單丟棄,MemGPT觸發**遞迴摘要 (Recursive Summarization)**流程,將既有的全局摘要與被剝離的這批新訊息相融合,生成一份全新的濃縮摘要置於佇列頭部。原始訊息則完整歸檔至
Recall Storage。
- 心跳鏈式自主召回 (Heartbeat Recall):
- 當使用者詢問數月前的某個事件細節時,模型自主調用
recall_storage.search()並設置request_heartbeat=true。這使得模型能在無需人類干預的情況下連續執行多步推理,將外部磁碟資訊加載回RAM後,輸出最終答案。
- 當使用者詢問數月前的某個事件細節時,模型自主調用
基準評測結果: 深度記憶召回 (DMR)
在跨越數十個獨立對話週期的深度記憶召回(Deep Memory Recall)基準測試中:
- 採用靜態視窗的基準GPT-4準確率大幅跌落至 32.1%;
- MemGPT無論經歷多少輪長程對話,依然維持了 92.5% 的卓越準確率;
- 在多跳關聯檢索(Nested KV Retrieval)測試中,基準模型在經歷3跳之後準確率徹底歸零,而MemGPT保持了100%的關聯追溯能力。
3. 神經網絡表徵層: Cartridges (2025)
MemGPT雖精妙,但本質上仍屬於「在外部資料庫與上下文之間搬運離散文本Token」。如果智慧體需要頻繁查閱一份500頁的企業財報或龐大的底層SDK庫,反覆搬運成千上萬個文本Token必然導致高昂的算力和巨額延遲。
2025年發表的Cartridges Modular Agent Memory開闢了一條全新技術路徑:
「為什麼知識必須以冗長的自然語言Token形式攜帶?如果讓大模型在離線狀態下對500頁文檔進行自主研習(Self-Study),將其蒸餾為僅包含50至100個連續、可微分的鍵值(KV)快取向量,像即插即用的遊戲機卡帶一樣動態載入,豈不兼具輕量與高效?」
[500頁海量企業文檔 / 複雜代碼庫]
             │
             ▼ (Self-Study 離線研習流水線)
1. 全維度合成對話生成 (核心脈絡摘要、深層質詢、臨界邊界、實戰應用)
             │
             ▼
2. 基於KL散度的上下文知識蒸餾:
   教師模型 (輸入500頁完整文本全文 + 提問) ──► P_Teacher(y)
                                                 │ (D_KL 散度損失)
   學生模型 (僅掛載卡帶 Z [50個KV向量] + 提問) ─► P_Student(y)
             │
             ▼
[即插即用型 Cartridge Z (50~100個連續可微KV向量)]
(顯存消耗減少 38.6倍, 推理吞吐提升 26.4倍, 樂高積木式多卡帶組合)
為什麼單純的自回歸預測(NTP)會遭遇滑鐵盧?
研究團隊最初嘗試使用常規的下一詞預測(Next-Token Prediction, NTP)訓練連續KV向量,但遭遇了慘痛失敗。模型陷入了嚴重的**「死記硬背綜合徵」**:
- 它能夠逐字逐句背誦出原文段落;
- 但一旦向它提出需要推理、歸納或跨段落對比的綜合問題,回答準確率瞬間歸零。模型僅僅擬合了字面序列,未真正內化語義邏輯。
Self-Study 與上下文蒸餾的雙階方案
- 多模態合成對話構建: 大模型針對文檔自主生成上萬條高品質多輪Q&A語料,涵蓋宏觀架構、邊界異常、深層推演等5大類型。
- 上下文知識蒸餾:
- 教師模型 (Teacher): 上下文中載入500頁完整文本,輸出標準後驗機率分佈
P_Teacher(y | Doc, x); - 學生模型 (Student): 剝離全部原文,僅在各層注意力前方拼接極短的連續卡帶參數 $Z$;
- 透過最小化學生與教師輸出分佈的KL散度(Kullback-Leibler Divergence),僅反向傳播更新卡帶參數 $Z$ 的權重:
- 教師模型 (Teacher): 上下文中載入500頁完整文本,輸出標準後驗機率分佈
========================================================================================
Cartridge 上下文蒸餾損失函數定義:
========================================================================================
min_Z  Σ  D_KL( F( · | Document ⊕ x )  ||  F_Z( · | x ) )

其中:
  • F( · | Document ⊕ x ) : 擁有完整原文的教師模型輸出Logits
  • F_Z( · | x )          : 僅依賴輕量級卡帶Z的學生模型輸出Logits
  • Z                     : 插入模型內部各層的連續鍵值快取張量
========================================================================================
評測表現與積木式組裝能力
- 顯存消耗削減 38.6倍: 在LongHealth與QASPER長文檔基準測試中,Cartridge達到了全量上下文提示(ICL)同等的解答精度,顯存佔用暴降至原來的 $1/38.6$。
- 推理吞吐飆升 26.4倍: 由於徹底免除了冗長文本的Prefill預填充耗時,服務吞吐量提升了 26.4倍。
- 零樣本無縫複合 (Composability): 卡帶具備極強的獨立性。當研究人員同時為智慧體插入「AMD財報卡帶」與「百事公司財報卡带」時,模型無需任何聯合微調,便能即刻完成雙企業的跨表財務對比分析!
4. 系統基礎設施層: CacheBlend (EuroSys 2025)
進一步深入計算底層,我們直面RAG檢索系統與多智慧體交互中的核心硬體瓶頸。
當智慧體檢索出10個互不相關的文檔切片(Chunk)並拼入同一次推理時,現有的推理引擎陷入了兩難處境:
- 前綴快取 (Prefix Caching, vLLM): 僅能復用首個切片的KV快取。如果後續切片的拼接順序發生改變,下游快取全盤報廢,被迫從頭重新計算Prefill(耗時3到6秒)。
- 全量快取直接拼接 (PromptCache): 預先計算每個切片的KV快取並強行拼接,會導致切片之間的交叉注意力(Cross-Attention)完全丟失,推理邏輯準確率大幅下跌超過50%。
在EuroSys 2025上斬獲殊榮的CacheBlend KV Cache Merging技術,透過**選擇性KV重計算 (Selective KV Recompute)**完美化解了此項衝突:
[檢索到的切片 A, B, C 之預先計算KV快取]
                           │
                           ▼
┌─────────────────────────────────────────────────────────────────────────┐
│              CacheBlend 逐層選擇性重計算流水線                          │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. 甄別前15%跨切片注意力偏差劇烈的高變Token (HKVD)                      │
│ 2. 僅對該15%核心Token執行全新的注意力狀態重算                           │
│ 3. 其餘85%的Token直接從預存快取中復用拼接                               │
│ 4. 乘上RoPE旋轉矩陣,微秒級恢復全新的全局絕對位置座標                   │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [極速Prefill完成: TTFT縮短 3.3倍, F1精度損失 ΔF1 < 0.01]
注意力稀疏性(Sparsity)的數學發現
CacheBlend作者團隊深入探究了多切片拼接時的注意力權重分佈,發現了驚人的規律:
「當多個文檔切片拼接至同一Prompt時,受到鄰近切片影響導致KV值發生劇烈偏轉的Token比例不足15%。超過85%的Token即便身處新的拼接環境中,其語義表徵依然高度獨立與恆定!」
- 高偏差Token甄別 (HKVD): 在每個Transformer層中,CacheBlend動態捕獲注意力變化最大的前15%核心Token並單獨重算,其餘85%直接沿用預計算快取。
- I/O傳輸與計算流水線重疊 (Latency Hiding): 在GPU執行15% Token重計算的數毫秒間隙內,後台非同步I/O執行緒同步從NVMe SSD將下一層的KV快取張量預取至顯存。計算耗時被完美掩蓋在數據讀取時間之中。
- RoPE位置編碼閉式修正: 拼接改變了切片的全局位置偏移。CacheBlend利用2D Givens旋轉矩陣直接作用於Key張量,僅需幾微秒即可修正相對位置編碼,無須侵入模型權重。
實測收益
- 首字延遲 (TTFT) 縮短 3.3倍: 多切片長文RAG問答的首字吐出耗時由3,450ms驟降至1,050ms。
- 並發服務吞吐提升 5倍: 硬體叢集承載的智慧體並發量翻了5倍。
- 精確度零妥協: 與無快取全量從頭重算的基線模型相比,回答的F1分數差異小於 0.01。
5. 三大記憶範式全景架構對比矩陣
=============================================================================================================
維度                  MemGPT (UC Berkeley)          Cartridges (2025)             CacheBlend (EuroSys 2025)
-------------------------------------------------------------------------------------------------------------
所屬抽象層            軟體調度 / 作業系統分頁       神經網絡知識表徵              推理系統底層基礎設施
核心操作單元          文本Token與JSON函數調用       連續可微虛擬KV快取向量        預計算的KV快取張量切片
記憶容量邊界          外部資料庫支撐,近乎無限      單篇文檔約50~100個虛擬Token   動態多切片RAG上下文
記憶演進機制          自主函數調用與遞迴歷史摘要    離線Self-Study與KL散度蒸餾    選擇性在線重計算 (15% HKVD)
硬體優化重點          突破物理上下文溢出困局        顯存開銷銳減 38.6倍           首字延遲 (TTFT) 降低 3.3倍
模組組裝能力          關聯式資料庫聯合檢索          樂高積木式矩陣垂直拼接        RoPE座標幾何變換無縫拼接
=============================================================================================================
6. 技術深度問答 (Q&A)
Q1: 在MemGPT架構下,智慧體如何自發判斷「何時該去檢索外部記憶」,而無需人工指令干預?
MemGPT在主上下文最頂端常駐了一份系統指令(System Instructions),並透過嚴格的函數調用規範構築了認知契約:
「你是一個具備長時記憶的自主智慧體。當回答涉及歷史事件、過往對話細節或不在當前工作上下文中的事實時,你嚴禁猜測或道歉,必須優先調用
recall_storage.search()或archival_storage.search()。」
當模型感知到資訊缺失時,自注意力機制在系統指令的強約束下,將生成工具調用JSON判定為機率最高的路徑。系統攔截到返回的 request_heartbeat=true 標誌後,立即將檢索到的磁碟數據回傳至上下文,從而在零人工介入的前提下完成閉環召回。
Q2: 為什麼隨意拼接不同位置的獨立KV快取不會破壞RoPE旋轉位置編碼?
在傳統的絕對位置編碼中,只要Token位置從第0位挪動到第500位,整個嵌入向量就必須徹底重構。
然而,現代模型普遍採用的RoPE (Rotary Position Embedding),其Query與Key的內積數學上嚴格只取決於兩者的相對距離 $(m - n)$:
K_new = R_Theta(p_new - p_old) * K_cached
因此,CacheBlend在拼接切片時,只需將預存的Key張量乘以對應位置增量 (p_new - p_old) 的2D旋轉矩陣,便能在數微秒內完成座標系校正。這一純線性代數操作無需重算注意力,兼顧了數學上的絕對嚴謹與系統的超高效率。
總結與下期預告
智慧體的真正自主性離不開持久記憶的依託。透過MemGPT,我們見證了作業系統分頁原理賦予智慧體無限認知週期的壯舉;透過Cartridges,我們探索了將百科全書式知識蒸餾為模組化連續向量的優雅路徑;透過CacheBlend,我們驗證了藉助注意力稀疏性將首字延遲縮減3.3倍的系統級突破。
在接下來的第12講中,我們將迎來Part 3(智慧體工程)的大結局,直面檢驗智慧體真實智能與生產力價值的試金石:《Agent Evaluation & Long Tasks: 長程任務評測與真實經濟價值基準 (Measuring Long Tasks, GDPVal, DeepScholar-Bench)》。
核心要點梳理
- 分層解耦體系: 必須將高速的工作記憶體(RAM)與大容量長時外存(Disk)相分離,才能從根本上駕馭長程上下文。
- 連續表徵替代文本灌輸: 將海量文本蒸餾為連續卡帶(Cartridge),可在節約38.6倍顯存的同時實現即插即用的模組化知識組合。
- 稀疏重算消除首字延遲: RAG拼接場景中僅有15%的Token發生顯著偏轉,選擇性重算(CacheBlend)使系統獲得極致的Prefill加速。