Stanford CS329A (第12講): Agent Evaluation & Long Tasks — METR時間地平線, OpenAI GDPval與DeepScholar-Bench

當工程團隊構建出一套自主程式設計智慧體向企業管理層或投資人匯報時,單方面宣稱「該模型在MMLU選擇題中取得了92分」往往得不到實質性的商業共鳴。現實商業戰場拋出的質詢遠比選擇題冷酷而具體:
- 「這個自主智慧體在沒有人類介入糾錯的前提下,究竟能否獨立搞定需要耗時數小時的端到端複雜工程任務?」
- 「人類資深工程師需要花費8小時完成的底層微服務重構或深度財務估值模型,這個智慧體能否給出媲美人類的品質?其帶來的淨經濟價值究竟是多少美元?」
傳統的靜態客觀題基準(MMLU, GSM8K, HumanEval)早已普遍超過90分而步入飽和(Saturation),並因網際網路訓練數據污染(Contamination)淪為死記硬背的作秀。更本質的是,回答耗時5秒的單選題,與在數小時內連續執行數百步具備狀態依賴的決策——即長程智慧體任務 (Long-Horizon Agent Tasks)——存在著維度上的根本鴻溝。
作為Stanford CS329A: Self-Improving AI Agents的第三部分:智慧體工程(Part 3: Agent Engineering)的大結局,本講深入探討現代Agent Evaluation Benchmarks(智慧體評估基準)的核心前沿——不再以虛浮的百分比論英雄,而是以**人類時間 (Human Time)和經濟美元 ($)**作為衡量智慧的物理基準:
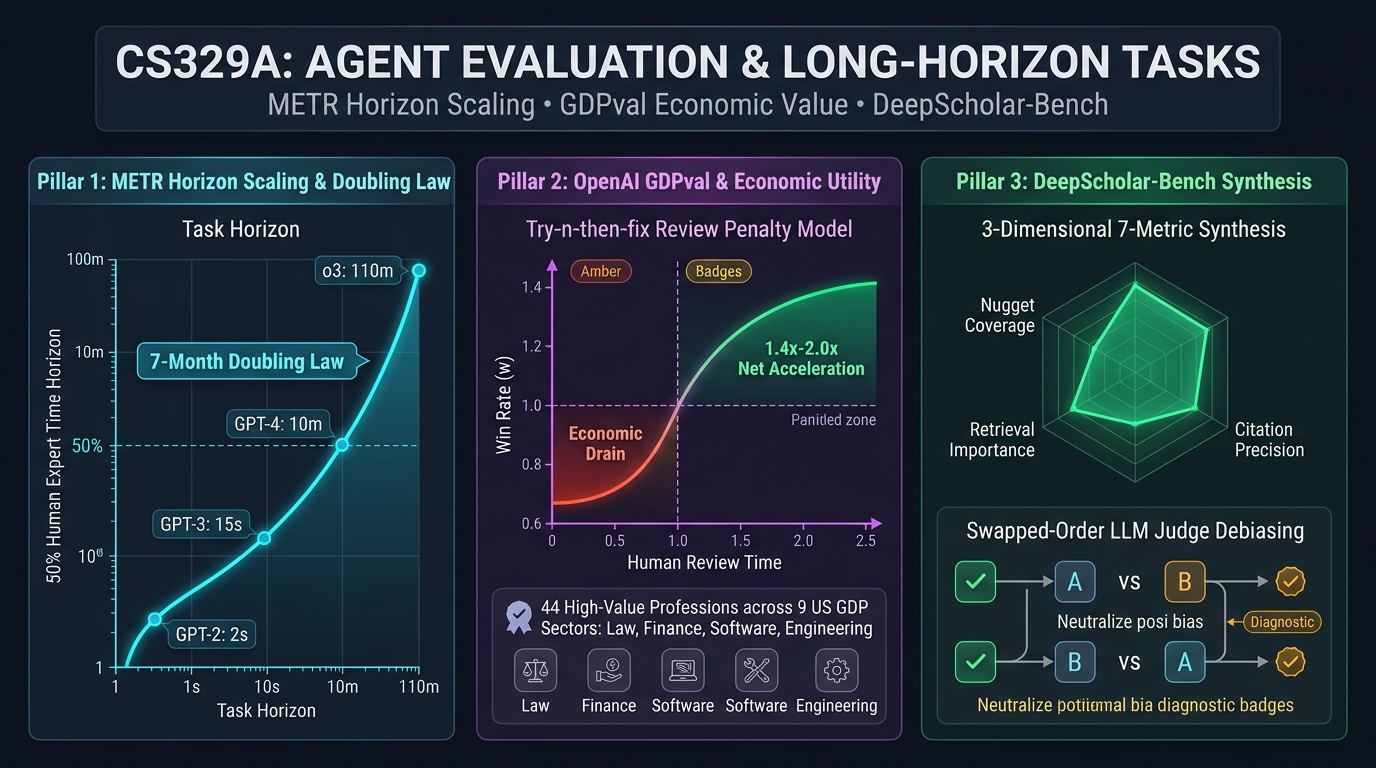
- 人類時間地平線標定 (METR, 2025): 50%成功率時間地平線 (h_agent) 與每7個月翻番定律。
- 真實經濟價值量化 (OpenAI GDPval, 2025): 覆蓋美國GDP 9大產業44個數位職位的雙盲評測與「試錯修復(Try-n-then-fix)」時間成本經濟學。
- 杜絕數據污染的即時學術研究評測 (DeepScholar-Bench, 2025): 3維度7指標體系與LLM裁判(Judge)的位置偏見消除演算法。
1. 評估的危機:客觀選擇題的破產與實戰任務的本質
過去五年間,AI學界高度依賴靜態的問答數據集。然而在將智慧體投入產業實戰的過程中,這種評測機制暴露出三大致命結構性缺陷:
- 飽和與污染: 前沿大模型在MMLU上紛紛突破90分,但背後充斥著在海量預訓練中無意識爬取並記誦測試題的虛假繁榮。
- 缺乏時間地平線: 單道選擇題只需2秒、1步推理即可得出。而真實的軟體工程研發要求模型在數小時內維持嚴密的內部狀態,連續執行上百次有狀態的工具調用。
- 缺乏「現實的泥濘度 (Task Messiness)」: 考試題目總被封裝得格式嚴謹、語義無歧義。然而真實工業環境充斥著動態波動的網路狀態、難以逆轉的破壞性指令風險以及語焉不詳的報錯日誌。
因此,全球前沿AI機構全面摒棄了選擇題模式,轉向以物理時間與真金白銀為軸線的連續型評測。
┌─────────────────────────────────────────────────────────────────────────┐
│               現代自主智慧體評測的三大核心支柱                          │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
       ┌─────────────────────────────┼─────────────────────────────┐
       ▼                             ▼                             ▼
┌──────────────────────────┐  ┌──────────────────────────┐  ┌──────────────────────────┐
│     METR 時間地平線      │  │    OpenAI GDPval ($)     │  │    DeepScholar-Bench     │
├──────────────────────────┤  ├──────────────────────────┤  ├──────────────────────────┤
│ • 衡量標尺: 人類時間 t   │  │ • 衡量標尺: 真實美元價值 │  │ • 衡量標尺: 3維7項指標   │
│ • 50% 成功地平線 h_agent │  │ • 44個高薪數位化職位     │  │ • 每週同步arXiv最新論文  │
│ • 每7個月翻一番倍增定律  │  │ • Try-n-then-fix 經濟學  │  │ • 杜絕數據污染 0%        │
│ • 任務泥濘度 (Messiness) │  │ • 14年資深專家雙盲裁判   │  │ • 核心資訊元覆蓋率 (39%) │
│ • 2秒 (GPT-2) -> 110分(o3)│ │ • 勝率40% 經濟盈虧臨界線 │  │ • 交換順序消除裁判偏見   │
└──────────────────────────┘  └──────────────────────────┘  └──────────────────────────┘
2. 以人類時間衡量智慧:METR (2025)
宣稱「某模型在測試集中得到88分」無法為工程落地提供任何時間尺度上的預期。前沿AI評估實驗室**METR (Model Evaluation and Threat Research)**給出了極具穿透力的解決方案:
「拋棄百分制。轉而測量當一項任務需要經驗豐富的人類專家花費時間 $t$ 才能完成時,AI智慧體能夠以多大幾率成功搞定。並將AI能夠以50%概率攻克的人類任務時長(
h_agent),直接定義為該模型的智慧水平標尺!」
    [170套複雜軟體/機器學習綜合任務 (耗時從數秒跨越至8小時)]
                               │
                ┌──────────────┴──────────────┐
                ▼                             ▼
       [人類專家基準耗時 t]           [AI智慧體實際通過率 p]
                │                             │
                └──────────────┬──────────────┘
                               ▼
        [基於項目反應理論 (IRT) 的邏輯回歸擬合曲線]
           p = σ( (log h_agent - log t_task) × β_agent )
                               │
                               ▼
    [各模型50%時間地平線 h_agent: GPT-2 (2秒) ──► OpenAI o3 (110分鐘)]
時間地平線邏輯回歸公式
METR借鑑心理計量學中的項目反應理論(IRT),將智慧體的成功概率 $p$ 建模為人類基準耗時 t_task 與模型時間地平線 h_agent 的邏輯函數:
========================================================================================
METR 時間地平線成功概率建模公式:
========================================================================================
p_success(agent, task) = σ( (ln(h_agent) - ln(t_task)) * β_agent )

其中:
  • t_task  : 經驗豐富的人類專家完成該任務所需的平均耗時
  • h_agent : 該智慧體的50%成功時間地平線 (當 t_task = h_agent 時,p = 0.5)
  • β_agent : 斜率參數,反映隨著任務耗時延長成功率衰減的陡峭程度
  • σ(z)    : 標準Logistic Sigmoid函數 1 / (1 + exp(-z))
========================================================================================
每7個月翻番定律 (The 7-Month Doubling Law)
在對2019年至2025年間發布的16款前沿大模型進行系統評測後,浮現出一條驚人嚴格的指數級定律:
- 2019年 (GPT-2): 時間地平線僅為 2秒(簡單的詞句自動續寫)。
- 2021年 (GPT-3): 時間地平線為 15秒。
- 2023年 (GPT-4): 時間地平線為 10分鐘。
- 2025年 (OpenAI o3): 時間地平線達 110分鐘(近2小時)。
- 統計回歸結論: 前沿AI的50%成功時間地平線精確地以每7個月(207天)翻一番的速度暴增!
- 宏觀推演: 保持該歷史增長斜率,在2028年至2030年間,前沿AI智慧體將以50%的概率,單槍匹馬完成需要人類專家耗費整整一個月(160工作小時)的特大型軟體研發工程。
3. 衡量真實經濟價值:OpenAI GDPval (2025)
如果說METR校準了時間,那麼OpenAI在2025年秋季發布的GDPval則直接錨定了真金白銀的商業資本。
OpenAI鎖定了對美國國內生產總值(GDP)貢獻最大的9大核心支柱產業(金融、法律、軟體、製造、醫療行政等),遴選出44個高薪數位專業工種。他們聘請了平均擁有14年行業資深實戰經驗的專家,構建了220套源自真實業務場景的黃金任務(如構建現金流折現估值模型、撰寫專利侵權抗辯書、開發Python數據清洗流水線等):
- 任務平均人類耗時:9.5小時(中位數5.0小時)。
- 任務平均市場外包價值:398美元(約合新台幣12,800元)。
資深專家雙盲勝率 (Win Rate) 的真相
由14年資深行業專家對模型提交的成果與人類同行提交的成果進行嚴格雙盲評審:
- GPT-4o: 雙盲勝率僅為 12.5%(遠未達到工業交付門檻)。
- OpenAI o3: 雙盲勝率躍升至 35.2%。
- Claude Opus 4.1: 雙盲勝率達到 47.6% (勝出或打平)!
- 頂尖推理模型生成的成果,在專業評審眼中已有近半數達到或超越了人類專家的專業交付水準。
「速度快300倍」的行銷謊言與試錯修復經濟學
許多宣傳常聲稱:「人類做9小時的任務AI只需2分鐘,提速270倍!」 GDPval透過建立**試錯修復(Try-n-then-fix)**經濟學公式,無情揭穿了這一表面假象:
========================================================================================
現實業務綜合耗時期望公式 (Try-n-then-fix Model):
========================================================================================
E[T_real] = (M_T + R_T) * [ (1 - (1 - w)^n) / w ] + (1 - w)^n * H_T

其中:
  • M_T : 模型生成成果耗時 (通常為數分鐘)
  • R_T : 人類專家仔細審查並審計模型成果所需的時間
  • H_T : 當成果徹底不可用時,人類專家放棄並從零重做所需的基準時間
  • w   : 模型的雙盲勝率 (即成果合格可用的概率)
  • n   : 人類專家在放棄並親自接管前,允許模型重新嘗試的最大輪數
========================================================================================
經濟盈虧平衡點:從累贅到淨生產力
- 當模型勝率較低時(如GPT-4o, $w=12.5%$):人類專家不得不花費大量時間審查模型微妙的幻覺,最終因不滿品質只能親自推倒重做。結果是,引入GPT-4o後的實際工作效率比人類單獨工作還慢了13%(0.87倍,呈現經濟負收益)!
- 只有當模型的勝率突破 $w \ge 40%$ 的生死臨界線時(由o3與Opus 4.1實現),人類的審查成本才被模型交付的成功率所抵消,真正帶來1.3倍至1.4倍的淨生產力加速。
4. 杜絕數據污染的即時學術研究評測:DeepScholar-Bench (2025)
面對沒有唯一標準答案的開放式學術調研或深度研究智慧體(Deep Research Agents),行業該如何進行客觀評估?
2025年8月發布的DeepScholar-Bench透過搭建持續抓取每週arXiv最新提交論文的即時數據流水線(Live Pipeline),從源頭上徹底切斷了模型提前背誦題目的數據污染可能。
       [每週即時同步arXiv最新前沿論文 (0% 數據污染保證)]
                               │
                               ▼
┌─────────────────────────────────────────────────────────────────────────┐
│               DeepScholar-Bench 3大維度7項評估指標體系                  │
├─────────────────────────────────────────────────────────────────────────┤
│ 1. 知識綜合力 (Knowledge Synthesis)                                     │
│    • 邏輯架構與行文連貫性 (篇章組織、清晰度、學術排版規範)              │
│    • 核心資訊元覆蓋率 (Nugget Coverage: 必備原子的事實捕獲率)           │
│ 2. 檢索品質 (Retrieval Quality)                                         │
│    • 文獻相關性比例 (引用文獻與研討核心主題的契合程度)                  │
│    • 文獻重要性 (甄別並引用該領域奠基性權威文獻的能力)                  │
│ 3. 可驗證性 (Verifiability)                                             │
│    • 引用精度 (正文提煉的論據在引論文獻原文中真實存在的精確比例)        │
└────────────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        [順序互換LLM裁判: 代數化對消位置偏見 (Position Bias)]
30.9% 綜合得分展現的客觀現實
即便強如OpenAI DeepResearch這樣的頂尖研究型智慧體,在7大指標下的幾何平均得分也僅有30.9%:
- 行文華麗與事實單薄的脫節: 智慧體在文本組織結構方面得分頗高(Organization: 85.7%),但在捕獲必備事實的覆蓋率(Nugget Coverage: 39.2%)以及檢索核心經典文獻(Document Importance: 12.4%)上表現十分薄弱。
- 預置完美檢索結果的「先知實驗」: 當研究人員直接向智慧體餵入標準論文列表時,綜合得分也僅僅爬升至 49%。這無可辯駁地證明:當前深度研究智慧體的最大阻礙並非「搜尋」,而急需**「讀完多篇長文後提煉深刻見解的跨文檔綜合能力 (Synthesis)」**。
5. 現代前沿智慧體評估體系全景對比矩陣
=============================================================================================================
評測維度              METR (2025)                   OpenAI GDPval (2025)          DeepScholar-Bench (2025)
-------------------------------------------------------------------------------------------------------------
核心衡量單位          人類專家耗時 (小時/分/秒)     實際經濟價值 ($ 美元)         7大維度綜合品質向量
涵蓋任務類型          複雜軟體開發與機器學習工程    44個高價值白領數位化專業      開放式前沿科學綜述與調研
真值判定準則          確定性單元測試通過與否        14年資深專家雙盲對決勝率      原子化資訊元 (Nuggets) 命中
抗數據污染設計        專屬氣隙隔離離線任務庫        企業專屬非公開業務PRD場景     每週動態掛鉤最新arXiv文獻
人工審核成本考量      未建模 (全自動判分)           Try-n-then-fix 修正代價公式   順序互換LLM裁判消除位置偏見
當前最高基準記錄      o3: 110分鐘時間地平線 (50%)   Opus 4.1: 47.6% 雙盲勝率      DeepResearch: 30.9% 幾何均分
=============================================================================================================
6. 技術深度問答 (Q&A)
Q1: METR所定義的「任務泥濘度 (Task Messiness)」究竟包含哪些維度,如何影響智慧體表現?
METR框架下的**任務泥濘度 (Task Messiness)**量化了真實世界區別於純粹演算法題目的16項現實摩擦力:
- 動態狀態突變: 智慧體執行期間外界環境發生變動(例如網路波動、微服務鎖競爭)。
- 不可逆破壞風險: 缺乏平庸的撤銷機制(例如誤刪核心生產表或破壞性程式碼提交)。
- 主動資訊蒐集要求: 任務未預先投餵清晰入參,模型必須自主調用命令查找日誌並推斷上下文。
回歸分析表明:在METR泥濘度評分量表上每上升1分,智慧體的完成成功率平均線性暴跌8.1%。智慧體的實戰優劣,取決於抵禦這些泥濘環境噪音的韌性。
Q2: LLM裁判的位置偏見 (Position Bias) 是如何透過「順序互換 (Swapped-Order)」消除的?
當讓LLM裁判對比兩份候選方案 $(A)$ 與 $(B)$ 時,模型普遍表現出顯著的位置偏見 (Position Bias),在內容品質相仿時有60%~70%的基準傾向性青睞被排在前面的 $(A)$。
為消除這一系統性干擾,DeepScholar-Bench實施順序互換雙向取均值 (Swapped-Order Averaging):
- 輪次1:以
[A, B]順序輸入,記錄評分向量 $S_1 = [s(A), s(B)]$; - 輪次2:將順序反轉為
[B, A]輸入,記錄評分向量 $S_2 = [s(B), s(A)]$; - 計算算術平均值:
S_final(A) = ( S1(A) + S2(A) ) / 2
S_final(B) = ( S1(B) + S2(B) ) / 2
在保持取樣溫度一致的前提下,排列順序導致的傾向性在代數運算中相互抵消,從而提煉出客觀公正的判定信號。
總結:Part 3(智慧體工程)圓滿完結
至此,我們完整攻克了Stanford CS329A的第三個核心篇章——Part 3 · Agent Engineering (L10~L12):
- 第10講: 攻堅工業級程式碼倉庫修復的 SWE-Agents 與硬體探針閉環優化的 KernelBench
- 第11講: 賦予智慧體永恆認知週期的 MemGPT、Cartridges 與 CacheBlend
- 第12講: 以物理時間 (METR) 與商業資本 (GDPval) 為尺度的終極評估體系
我們不僅掌握了自進化智慧體的設計與訓練,還為其武裝了分層記憶中樞,並構建了嚴謹扎實的工程驗證防線。
邁向 Part 4 · Frontiers(終極最前沿)
在接下來的課程終章——**Part 4 · Frontiers (第13講至第17講)**中,我們將跨越系統工程的範疇,邁入機器智慧的最深邃奧秘:推理的本質。
下一講第13講的主題為:《LLM Reasoning: 大模型推理的本質與思維鏈 (Chain-of-Thought, Self-Consistency, Emergent Cognitive Scaling)》。我們將以Google DeepMind傑出科學家Denny Zhou博士的開創性研究為基石,深層剖析大型語言模型內部「邏輯推理之火」被點燃的核心機制。
本講核心精要
- 以時間為尺度: 真正的智慧體能力應以50%成功率時間地平線(
h_agent)衡量,它遵循著每7個月翻倍的規律,從GPT-2的2秒增長至o3的110分鐘。 - 覆核成本決定經濟效益: 智慧體的雙盲勝率若低於40%,人工審查與返工將導致整體業務陷入效率倒退。
- 跨文檔綜合是終極瓶頸: 在開放式學術研究中,搜尋已不是卡點,從多源文獻中提煉高密度關鍵見解的綜合力才是真正的分水嶺。