Stanford CS329A (Ep 14): AlphaProof & Mathematical Reasoning — 形式化驗證、Lean 4、AlphaGeometry 與 Gemini Deep Think

在上一講關於大語言模型推理的課程中,我們探討了思維鏈(Chain-of-Thought, CoT)提示工程與自我一致性(Self-Consistency)解碼如何在神經網路內部點燃多步驟因果推論的火花。然而,在加密協議驗證、航太軌道控制軟體以及人類最高殿堂的數學定理證明等關鍵任務領域,純自然語言文本依然存在致命隱患:
"無論大語言模型生成的自然語言思維鏈看起來多麼流暢優美,它在本質上依然是一個機率性標記序列。一個微小的正負號錯誤、循環論證或基於幻覺的引理,都會導致整個系統崩潰。在嚴謹的數學殿堂中,99% 正確的證明等價於 0% 正確。"
歡迎來到 Stanford CS329A: Self-Improving AI Agents 的 Part 4: 前沿探索(Frontiers in Reasoning & Autonomy) 第二講:Lecture 14。依托 Google DeepMind 研究總監兼 AlphaProof 核心締造者 Thang Luong 博士 的開創性研究,我們將深入剖析人工智慧如何跨越機率性預測,進化為 100% 具備確定性機械驗證能力的超人類數學智能,並最終在國際數學奧林匹克(IMO)中斬獲歷史性獎牌:
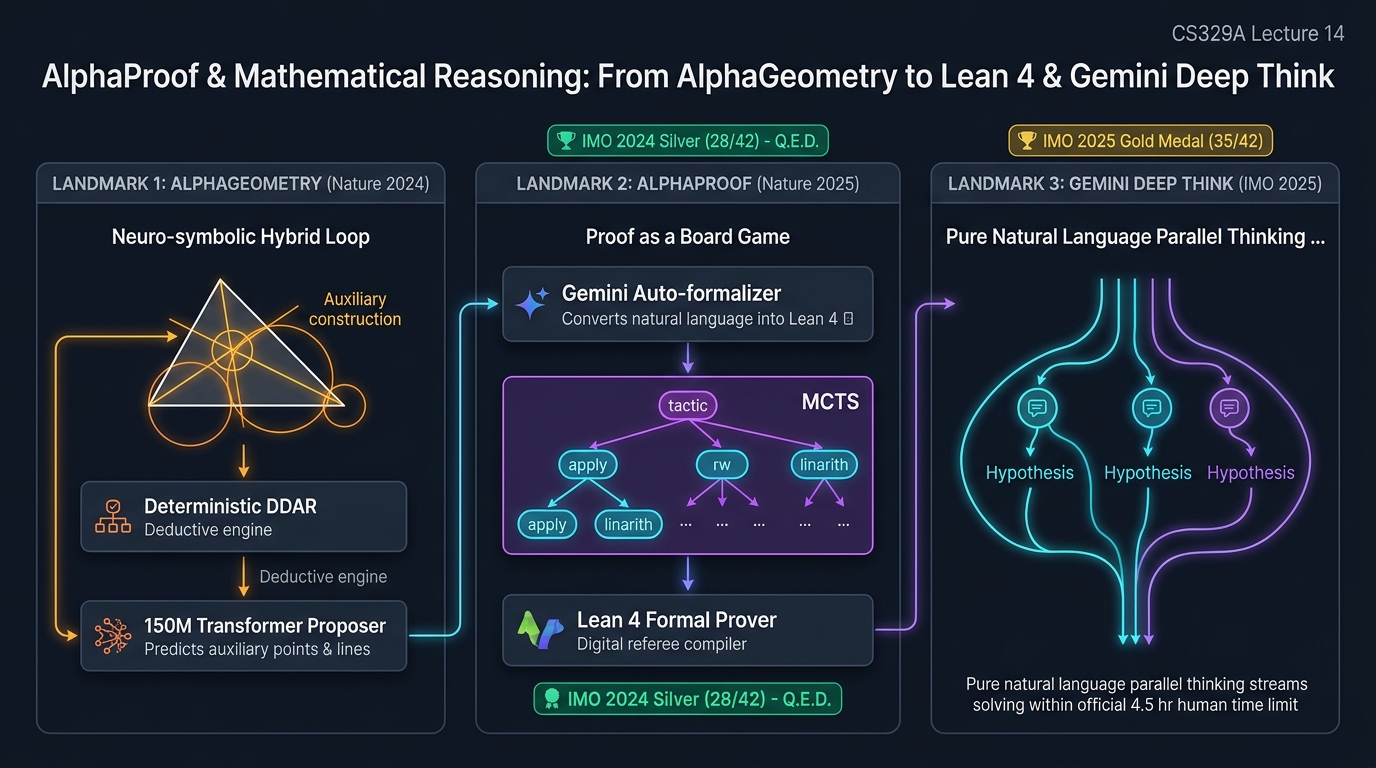
- AlphaGeometry (Nature 2024): 將確定性符號演繹引擎與生成式 Transformer 輔助幾何構造相結合的神經符號(Neuro-Symbolic)架構。
- AlphaProof (DeepMind, Nature 2025): 借助互動式定理證明器 Lean 4、自動形式化(Auto-formalization)與測試時強化學習(TTRL),將數學定理證明重塑為 AlphaZero 式棋盤博弈。
- Gemini Deep Think (IMO 2025): 純自然語言推理與平行思考(Parallel Thinking)的巔峰之作,在人類 4.5 小時考試時限內奪得全球首枚官方 IMO 個人金牌(35/42)。
- LLM 形式化驗證與數學推理: 機器編譯器檢查的形式化核心與自由自然語言強化學習的深層對比。
1. 數學:檢驗人工智慧智能水準的終極試金石
為什麼數學被公認為檢驗自律型 AI 代理人能力的「終極試金石(Litmus Test)」?程式碼基準測試(如 SWE-bench)和對話任務通常允許啟發式替代方案或局部模糊性,但形式化數學施加了三項不可妥協的硬性約束:
┌──────────────────────────────────────────────────────────────────────────┐
│              數學作為人工智慧終極試金石的 3 大核心支柱                   │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│  客觀機械可驗證性       │  │   極致的獎勵稀疏性      │  │   浩瀚的組合搜尋空間    │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • 形式化邏輯系統        │  │ • 數百步複雜推演中,    │  │ • 引理空間的有效分支因子│
│   (Lean 4, Coq, Isabelle)│   在終點前獎勵恆為 0      │    趨近於無窮 (b -> inf)  │
│ • 確定性型別檢查編譯器  │  │ • 僅在最終達成目標      │  │ • 幾何輔助線/輔助點發明 │
│ • 幻覺機率嚴格為 0%     │    (Goal Solved) 時給獎勵│    需要真正的創造力突破   │
│ • 真偽判定絕對二元化    │  │ • 信用分配極度困難      │  │ • 盲目暴力搜尋徹底失效 │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
- 客觀機械可驗證性(Objective Mechanical Verifiability): 與主觀評判的文學或法律不同,形式化數學由確定性型別檢查程式(如 Lean 4 編譯器)進行 100% 嚴謹驗證,不容任何僥倖。
- 極致的獎勵稀疏性(Extreme Reward Sparsity): 在長達數十甚至數百步的推演中,代理人在閉合最終證明目標(
Goal Solved)前得不到任何正向獎勵。即使 99% 的推導完全正確,若最後一步出錯,整體獎勵依然為 0。 - 浩瀚的組合搜尋空間(Massive Combinatorial Search Space): 西洋棋平均分支因子約為 35,圍棋約為 250,而形式化數學中的引理與戰術選擇空間在理論上是無界的($b \to \infty$)。
2. 神經符號融合:AlphaGeometry (Trinh et al., Nature 2024)
國際數學奧林匹克中的歐幾里得幾何問題素以刁鑽著稱。選手即便通曉全部公理,若無法在腦海中構思出一條巧妙的輔助線(Auxiliary Construction)——例如穿過三個隱含點的輔助圓或一條輔助垂線——便會在 4 小時內寸步難行。
歷史上,人工智慧在此分為兩大對立流派:
- 符號邏輯引擎(DDAR): 由演繹資料庫與代數推理器組成,推演 100% 精確且絕無計算失誤,但毫無直覺創造力,一旦現有公理耗盡便徹底停滯。
- 深度神經網路(Transformers): 擅長模式識別與直覺想像,但容易出現微小數值偏差和角度幻覺,導致全盤推導崩潰。
AlphaGeometry 將兩者構築為非對稱的共生架構:
               +-------------------------------------------+
               |            歐幾里得幾何問題輸入           |
               +---------------------+---------------------+
                                     |
                                     v
                        +----------------------------+
                        |    符號邏輯引擎 (DDAR)     | <---------+
                        |    - 演繹資料庫 (DD)       |           │
                        |    - 代數推理器 (AR)       |           │
                        +--------------+-------------+           │
                                       |                         │
                         [證明目標是否已達成?]                  │
                           /                   \                 │
                        (成功)                 (未達成 / 卡死)   │
                         /                       \               │
                        v                         v              │
             +--------------------+    +-----------------------+ │
             | 輸出完整證明       |    | 150M 參數 Transformer | │
             | (人類可讀文本)     |    | 輔助幾何元素生成器    | │
             +--------------------+    +-----------+-----------+ │
                                                   |             │
                                       [預測極具潛力的         | │
                                        輔助點與輔助線]        | │
                                                   +-------------+
1 億筆合成資料生成引擎(Synthetic Data Generation)
AlphaGeometry 面臨的最大壁壘是訓練資料匱乏:人類百年奧數歷史上,形式化幾何題庫不足千道。DeepMind 另闢蹊徑構建了龐大的合成管線:
- 隨機幾何拓撲生成: 電腦隨機生成 10 億種點、線段和圓的無序組合。
- 前向演繹挖掘: 符號引擎(DDAR)在這些隨機圖形中,自動挖掘出 1 億筆偶然成立的有效幾何定理與證明路徑。
- 輔助線強依賴過濾: 從中精準篩選出 900 萬筆「唯有引入特定輔助線才能證畢」的關鍵定理。
- 監督微調蒸餾: 訓練 150M 參數的 Transformer,使其在符號引擎卡死時能夠精準預判這 900 萬類必備輔助構造。
基準測試結果
在歷年 30 道 IMO 幾何題目基準測試中:
- 先前最強符號主義方法(吳方法)僅解出 10 道題。
- AlphaGeometry 在官方考試時間內成功證明 25 道題,比肩人類 IMO 金牌選手水準。
- 在 2004 年 IMO 第 1 題中,AlphaGeometry 甚至發現了出題組未曾察覺的冗餘前提,將該定理推廣至更廣泛的數學形態。
3. 將定理證明化為棋盤博弈:AlphaProof (Nature 2025)
幾何學僅是數學大廈的一角。要攻克數論、抽象代數和組合數學,代理人必須在嚴密的形式化語言環境中執行多步驟邏輯推演。
2024 年 7 月,Thang Luong 博士團隊揭開了 AlphaProof 的面紗,其核心設計理念是將定理證明轉化為與嚴密編譯器對弈的二人零和棋盤博弈。
┌──────────────────────────────────────────────────────────────────────────┐
│                   AlphaProof 核心系統架構                                │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ Gemini 自動形式化器      │                   │ AlphaZero 證明搜尋網路    │
├──────────────────────────┤                   ├───────────────────────────┤
│ • 自然語言數學題輸入     │                   │ • 3B 參數 Transformer     │
│ • 1 億道原始數學題庫     │                   │ • Lean 4 戰術(Tactic)策略:│
│ • 雙向回譯語意驗證       │                   │   apply, rw, linarith     │
│ • Lean 4 形式化程式碼規範│                   │ • 價值網路: 預估距離      │
│ • 8000 萬道有效形式化定理│                   │   終點 Q.E.D. 的推導步數  │
└────────────┬─────────────┘                   └─────────────┬─────────────┘
             │                                               │
             └───────────────────────┬───────────────────────┘
                                     ▼
                      ┌─────────────────────────────┐
                      │    Lean 4 形式化核心環境    │
                      ├─────────────────────────────┤
                      │ • 嚴格型別檢查編譯器        │
                      │ • 環境即時反饋循環          │
                      │ • 二元化機械判定 (0 或 1):  │
                      │   - 戰術指令成功編譯        │
                      │   - 型別居留達成 (Q.E.D.)   │
                      └─────────────────────────────┘
Lean 4 環境:數學的無限數位棋盤
Lean 4 是一門基於歸納構造演算(CIC)的純函數式程式語言。根據柯里-霍華德同構(Curry-Howard Correspondence):
- 數學命題(Proposition)對應於型別(Type)。
- 數學證明(Proof)對應於居留該型別的程式項(Term)。
- Lean 編譯器充當終極裁判:只要程式碼成功通過編譯,該命題便在數學上獲得 100% 的絕對證明。
代理人在每一步推導中觀察當前的目標(Goal)狀態,並依次落子執行諸如 induction、ring、rw [mul_comm] 或 linarith 等形式化戰術(Tactics)。
自動形式化:跨越資料鴻溝的 8000 萬定理庫
全球精通 Lean 4 語言的數學家不足千人。DeepMind 借助 Gemini 大模型將海量教材與競賽題翻譯為 Lean 4 規範程式碼,並輔以嚴格的形式化回譯檢驗,構建起包含 8000 萬道題目的形式化數學語料庫。
測試時強化學習(TTRL, Test-Time Reinforcement Learning)
在面對 IMO 2024 最為惡名昭彰的第 6 題(全球 609 名精英僅 5 人解出的極高難度組合題)時,常規模型推演陷入僵局。DeepMind 果斷啟動了 TTRL:
[輸入: IMO 2024 第 6 題]
         │
         ▼
[Gemini 自動化數學題目合成器]
         │
         ├──> 針對該題拓撲特徵,現場自動生成 400,000 道變體題目
         │    (簡化參數規模、邊界特例、中間輔助引理)
         ▼
[調集數千張 TPU v5e 超級算力叢集]
         │
         ├──> 在這 40 萬道變體題目上持續運行 AlphaZero 自我對弈
         ├──> 在推論測試階段直接對模型權重進行為期 3 天的即時強化更新
         ▼
[針對該特定難題產生客製化超智能專家模型]
         │
         ▼
[生成第 6 題並通過 Lean 4 編譯器 100% 嚴密機器驗證!]
最終,AlphaProof 攻克全部 6 題中的 4 道題,斬獲 28 分/42 分——榮獲官方 IMO 銀牌(距離金牌線僅差 1 分)。
4. 純自然語言推理征服金牌:Gemini Deep Think (IMO 2025)
儘管 AlphaProof 取得了歷史性勝利,但仍面臨兩大工程瓶頸:
- 將自然語言題目轉化為 Lean 4 程式碼高度依賴繁雜的前處理管線。
- TTRL 推理計算耗時長達 3 天,遠超人類選手的 每天 4.5 小時考試時限。
2025 年 7 月,DeepMind 推出了無需形式化翻譯、以純自然語言攻克奧數之巔的 Gemini Deep Think:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Gemini Deep Think: 平行思考運行機制                    │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
        ┌────────────────────────────┼────────────────────────────┐
        ▼                            ▼                            ▼
┌─────────────────────────┐  ┌─────────────────────────┐  ┌─────────────────────────┐
│ 假說路徑 A (代數變形)   │  │ 假說路徑 B (幾何反演)   │  │ 假說路徑 C (組合不等式) │
├─────────────────────────┤  ├─────────────────────────┤  ├─────────────────────────┤
│ • 正推進至第 4 步       │  │ • 卡在引理 3 證明階段   │  │ • 成功推導出漸近上界   │
│ • 自我審查發現矛盾點    │  │ • 果斷執行分支剪枝操作  │  │ • 提取為假說 A 的前置項 │
└─────────────────────────┘  └─────────────────────────┘  └─────────────────────────┘
Gemini Deep Think 摒棄了單鏈順序生成的模式,採用了平行思考(Parallel Thinking):
- 同時在腦海中展開數十條截然不同的代數、幾何與解析假說。
- 當某條推演路徑卡死時,系統迅速提取其部分不變量,並跨路徑融入其他有效活躍分支。
- 在與人類選手完全一致的 4.5 小時時限內交卷,成功解決 6 道題中的 5 道,以 35 分/42 分贏得人工智慧歷史上首枚官方 IMO 個人金牌。
5. 架構深層對比:形式化驗證 vs 自然語言強化學習
+-----------------------+----------------------------------+----------------------------------+
| 核心對比維度          | 形式化驗證路線 (AlphaProof)      | 純自然語言 RL 路線 (Deep Think)  |
+-----------------------+----------------------------------+----------------------------------+
| 驗證引擎              | Lean 4 嚴格型別檢查器            | 多代理人 LLM 協作與自我評判      |
| 幻覺發生率            | 絕對為 0% (程式碼編譯通過即保真) | > 0% (仍存在極其微小的邏輯跳躍)  |
| 搜尋耗時              | 數小時至 3 天 (MCTS + TTRL)      | 4.5 小時以內 (即時動態推理)      |
| 適用領域              | 嚴苛加密系統、智慧合約、數學定理 | 開放域科學研究、跨學科策略規劃   |
| 基礎設施依賴          | Lean 4 生態系統與 Mathlib 庫     | 超大規模分散式強化學習基礎設施   |
+-----------------------+----------------------------------+----------------------------------+
6. 核心工程總結與啟示
- 合成資料是前沿推理的破局關鍵: AlphaGeometry 證明,當高品質現實資料枯竭時,符號邏輯引擎能夠自舉合成數以億計的嚴密證明路徑,以低成本預熱神經網路直覺。
- 形式化驗證徹底根除幻覺: 在容錯率為零的關鍵領域,必須將語言模型與 Lean 4 等確定性編譯核心相綁定。
- 測試時強化學習(TTRL)潛力無限: AlphaProof 證明,在推理階段動態合成變體並針對性更新權重的策略,能讓模型跨越原本靜態能力的邊界。
- 自然語言平行思考可匹敵人類敏捷度: Gemini Deep Think 證明,透過多分支平行思考,純自然語言模型在嚴格時間約束下同樣能夠綻放人類頂級數學家的光芒。
在下一講 Lecture 15: Autonomous Systems & Reliability 中,我們將走出確定性的數學象牙塔,直面現實軟體世界的複雜混沌,深入剖析自律型代理人如何構建自我修復(Self-Healing)、沙盒防護與安全邊界。敬請期待!