Stanford CS329A (Ep 16): Multimodal & Embodied Agents — 操控物理世界的機器人基底模型 (VLA, RT-2, OpenVLA 與 π₀)

在上一講關於自主系統與可靠性的課程中,我們探討了軟體代理人如何在虛擬沙盒內依托多重邊界防禦線束與 AI Control 協議維持系統的穩健性。然而,人工智慧學界面臨著一個更為本質的拷問:
"一個僅局限於電腦螢幕之內、生成文本並執行程式碼的系統,能真正被稱為通用人工智慧(AGI)嗎?我們所身處的真實物理世界並非由虛擬指令構建,而是充滿了重力、摩擦力、三維空間幾何以及剛體與柔性物體的複雜物理互動。"
如果我們為基礎大模型裝上一雙高解析度的「眼睛」(RGB 攝影機)與一條由七個自由度鋼製關節構成的機械手臂,世界將會發生怎樣的蛻變?
- 穩穩抓起一顆生雞蛋並輕柔放入平底鍋,蛋殼絲毫無損;
- 在雜亂無章的客廳地面上,將兒童玩具精準按顏色分揀收納進對應儲物盒;
- 在自動化工業裝配線上,以 0.1 毫米級的極致精度精準對準並插入微型電子接插件!
歡迎來到 Stanford CS329A: Self-Improving AI Agents 的 Part 4: 前沿探索(Frontiers in Reasoning & Autonomy) 第四講:Lecture 16。依托 Google DeepMind 機器人團隊核心成員、Physical Intelligence 聯合創始研究員 Danny Driess 博士 的開創性成果,我們將全面剖析視覺-語言-動作模型(VLA, Vision-Language-Action)這一將多模態大模型直接植入機器人運動神經的革命性體系:
- 動作即語言(RT-2, DeepMind 2023): 將 7 自由度連續機械手臂運動量離散化為 256 個詞元,併入 55B 巨型 VLM 詞彙庫的跨界創新。
- 開源與輕量化的勝利(OpenVLA, 2024): 依托 SigLIP 與 DINOv2 雙視覺編碼融合、分位數分箱(Quantile Binning)與 LoRA 適配,在單張消費級顯示卡上實現反超 55B 專有模型的 7B 架構奇蹟。
- 連續控制與物理世界回饋($\pi_0$): 克服離散分箱微顫、征服折衣服與折紙箱等柔性物體複雜操控的流匹配(Flow Matching)擴散策略。
- 具身智能雙重安全機制: 軟體級閥值動作截斷與硬體級力矩感測器物理反射迴路。
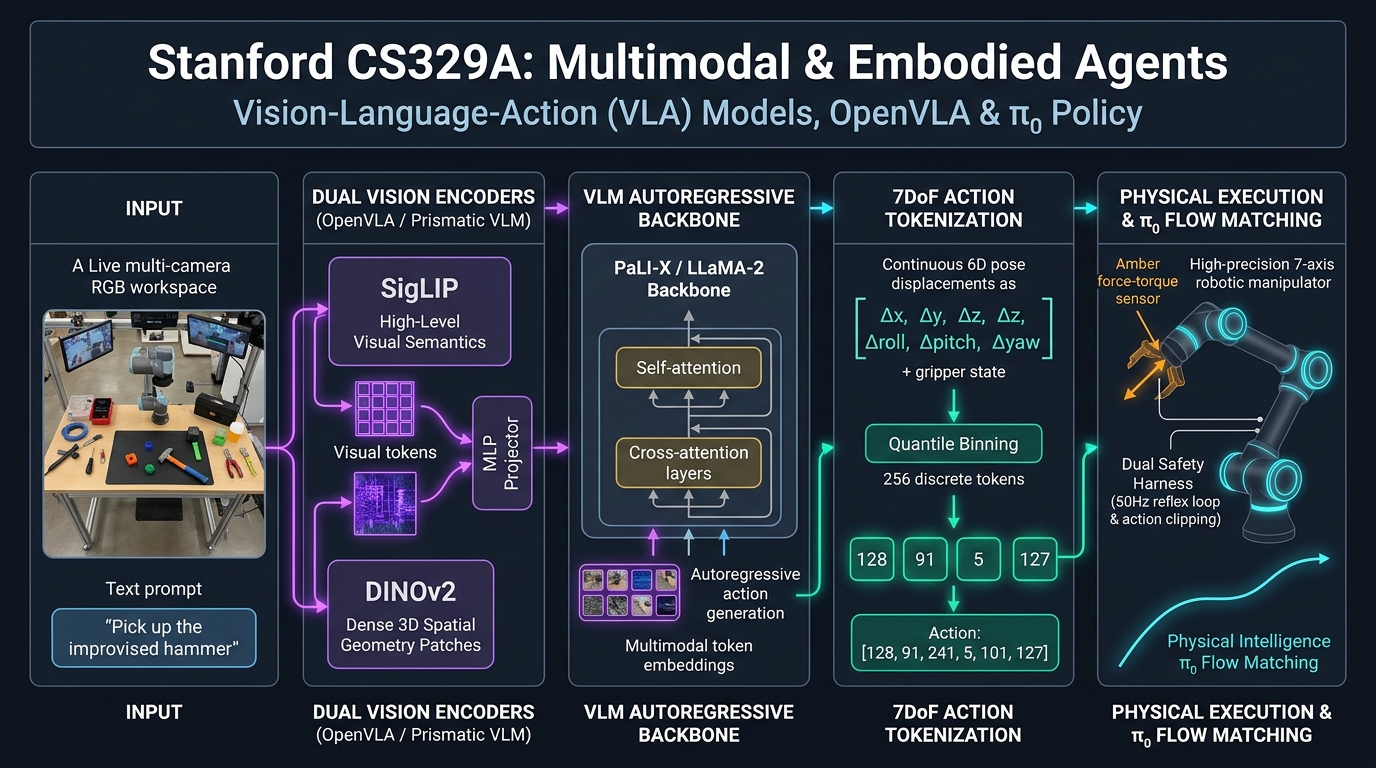
1. 物理世界的前沿:突破機器人領域的「資料極度飢渴」
數十年來,機器人控制技術始終深陷於極其嚴峻的資料貧瘠之中。純文本語言模型能夠吞吐全網數以兆計的標記蓬勃發展,但真實機械手臂運動軌跡的採集成本卻極其高昂:
- 必須依賴專業人員在物理實驗室中操作實體硬體進行遙控操作。
- Google 實驗室動用 13 台機械手臂持續全負荷運轉 17 個月,僅勉強積攢出區區 13 萬條有效操作軌跡。
- 因而,局限於狹小實驗室內訓練的傳統機器人泛化能力極差:環境光線稍微發生 10% 的偏移,或者桌面物體位置挪動 5 公分,機械手臂便會在虛空中胡亂抓取並導致任務失敗。
Danny Driess 博士與 DeepMind 團隊提出了顛覆機器人學認知範式的核心構想:
"不要再從零開始用貧瘠的機器人資料去苦苦訓練專用控制策略。直接引入網際網路海量圖文預訓練完成的超巨型視覺語言模型(VLM),並將機械手臂關節馬達的運動增量視為『一門全新的外語單字』塞進詞彙庫!"
┌──────────────────────────────────────────────────────────────────────────┐
│              視覺-語言-動作(VLA)模型的範式演進                         │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────────────┐   ┌──────────────────────────────────┐
│ 傳統專用機器人控制策略           │   │ 視覺-語言-動作 (VLA) 模型        │
├──────────────────────────────────┤   ├──────────────────────────────────┤
│ • 基於幾千條封閉實驗室資料訓練的 │   │ • 7B 至 55B 參數的超強多模態底座 │
│   小微卷積神經網路 (CNN/ResNet)  │   │ • 具備網際網路級全域圖文預訓練知識│
│ • 語意泛化能力絕對為 0%          │   │ • 內建強大的物理常識推理能力:    │
│ • 物體移動 5 公分即導致全盤失效  │     「石頭可以作為臨時錘子敲釘子」   │
│ • 每項新任務必須從頭編寫程式碼   │   │ • 零樣本適應未曾見過的全新物體   │
│ • 嚴重孤立的任務煙囪             │     與雜亂開放的現實物理環境         │
└──────────────────────────────────┘   └──────────────────────────────────┘
2. 動作即詞元:RT-2 (Brohan et al., DeepMind 2023)
2023 年 7 月,Google DeepMind 正式推出了 Robotic Transformer 2 (RT-2),將 55B 參數的 PaLI-X 與 12B 的 PaLM-E 等巨型多模態底座成功重塑為端到端機械手臂物理控制器。
[輸入: RGB 攝影機畫面] + [任務指令: "把足球移動到梅西 (Lionel Messi) 的照片旁邊"]
                                     │
                                     ▼
     ┌───────────────────────────────────────────────────────────────┐
     │             巨型 VLA 底座模型 (PaLI-X 55B)                    │
     │  • 網際網路常識推理: 視覺識別照片上阿根廷球星梅西的面容       │
     │  • 三維幾何空間認知: 計算足球與目標照片的相對空間座標         │
     └───────────────────────────────┬───────────────────────────────┘
                                     │
                                     ▼ (自回歸輸出下一個詞元序列)
                   "Action: 1 128 91 241 5 101 127"
                     │       │  │   │   │  │   │   └─ 機械爪夾持力度 (127)
                     │       │  │   │   └──┴───┴───── 三維姿態角增量 (Δroll, Δpitch, Δyaw)
                     │       └──┴───┴──────────────── 三維空間位置增量 (Δx, Δy, Δz)
                     └─────────────────────────────── 動作持續標誌位
7 自由度 (7DoF) 動作空間與 256 區間均勻離散化
通用工業級機械手臂通常在 7 自由度連續空間中規劃位姿控制:
- 三維平移位移量 ($\Delta x, \Delta y, \Delta z$): 機械手臂末端執行器的空間位置增量。
- 三維旋轉歐拉角增量 ($\Delta roll, \Delta pitch, \Delta yaw$): 機械腕部姿態方向調整。
- 夾爪開合狀態 ($gripper$): 抓取或釋放物體的開合控制度。
為將這組連續浮點數向量轉換為 Transformer 能夠直接自回歸生成的離散 Token,RT-2 設計了**均勻動作詞元化(Uniform Action Discretization)**機制:
- 將機械手臂沿每個自由度的可動物理範圍
[a_min, a_max](例如[-30cm, +30cm])等距切分為 256 個區間(Bins):
\text{bin\_index} = \left\lfloor 256 \times \frac{a - a_{\min}}{a_{\max} - a_{\min}} \right\rfloor, \quad \text{截斷至 } [0, 255]
- 從大模型原有詞彙庫中抽取 256 個極低頻詞元,與這些動作區間索引建立一對一符號重映射(Symbol Tuning)。
- 在解碼階段施加輸出約束遮罩(Output Constraint Mask),強制模型在運動控制模式下僅取樣這 256 個合法動作詞元。
網際網路語意知識的物理級遷移
保留了全網預訓練記憶的 RT-2 展現出了驚人的「通靈」能力:
- 儘管其機械手臂微調軌跡中從未出現過「拿錘子」的字眼,但在擺放了石頭與圖釘的桌面上聽到 "抓起可以當臨時錘子的工具" 時,機器人毫無遲疑地直接抓起了石頭。
- "指出看起來最疲憊的動物玩偶", "把喝完的易開罐扔進垃圾桶" 等需要人類文化知識與複雜推理的任務均被高精度完成,較以往頂級專用機器人架構(RT-1)實現了逾 3 倍的泛化勝率。
協同微調 (Co-Fine-Tuning):抵禦災難性遺忘
若直接使用純機械手臂控制資料微調 55B 的模型,其內部網路會遭遇災難性遺忘(Catastrophic Forgetting),丟失在海量圖文中習得的常識推演力。RT-2 採用協同微調,在每輪訓練批次中按比例強制混入原生網際網路圖文對,使語意邏輯神經元始終保持活躍。
3. 開源與輕量化平民化:OpenVLA (2024)
RT-2 雖性能斐然,但其 55B 的龐大體量完全依賴 Google TPU 雲端叢集驅動,程式碼權重均未開源,學術界長期難以涉足。
2024 年夏,史丹佛大學與 UC 柏克萊團隊聯合開源了基於 Open X-Embodiment(匯聚 70 多個實驗室、97 萬條實戰軌跡)打造的首個 7B 級通用開源基座模型——OpenVLA。
               +-------------------------------------------+
               |             RGB 攝影機原始輸入            |
               +---------------------+---------------------+
                                     |
                       +-------------+-------------+
                       |                           |
                       v                           v
             +--------------------+     +--------------------+
             |   SigLIP 編碼器    |     |   DINOv2 編碼器    |
             | (高層語意概念提取) |     | (高頻三維空間幾何  |
             |                    |     |  與局部特徵提取)   |
             +---------+----------+     +----------+---------+
                       |                           |
                       +-------------+-------------+
                                     | (通道維度拼接 / Concatenation)
                                     v
                        +----------------------------+
                        |      2 層 MLP 投影層       |
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        |   Llama-2 7B 語言大模型底座|
                        +--------------+-------------+
                                       |
                                       v
                        +----------------------------+
                        | 256 個分位數動作 Token     |
                        +----------------------------+
1. 雙視覺編碼融合:SigLIP + DINOv2 (Prismatic VLM)
機械手臂精準操控與常規圖片問答存在本質差異,它不僅需要語意理解,更對杯子把手距離右側究竟突出了幾毫米等毫米級空間深度幾何資訊有極度苛刻的要求:
- SigLIP(語意編碼器): 擅長語言與畫面的高維語意對齊。
- DINOv2(空間幾何編碼器): 具備出類拔萃的邊緣輪廓定位與深度感知力。
- 雙編碼器特徵在通道維度拼接後,機器人抓取成功率較單用 SigLIP 直升 20% 以上。
2. 分位數分箱(Quantile Binning)
RT-2 的均勻分箱隱藏著巨大缺陷:物理操控中 90% 的動作集中在 1 毫米級的微調階段,而快速揮臂的大動作不足 1%。均勻切分會導致最關鍵的微小移動區間解析度嚴重不足。
- OpenVLA 統計了 97 萬條動作資料的累積分布,基於分位數(Quantile)自適應劃分區間:
\text{分箱斷點: } q_k = \text{Quantile}\left(\mathcal{D}_{\text{actions}}, \frac{k}{256}\right), \quad k \in [0, 256]
- 將 Token 解析度高度集中於細膩對齊區域,大幅消除了機械手臂末端的失誤抓空。
3. LoRA 1.4% 微調與單張消費級顯示卡驅動
- 凍結視覺底座,僅對 Llama-2 的 1.4% 關鍵權重執行 LoRA 低秩微調,15 小時內便可適配一台全新構型的實體機械手臂。
- 採用 4-bit 量化(NF4)將顯存壓縮至 7GB,僅憑單張普通遊戲顯示卡(NVIDIA RTX 4090)即可實現 6Hz 即時閉環操控。
- 在 29 項實體機器人真實評測中,OpenVLA 比 55B 的 RT-2-X 整體絕對勝率高出 16.5%,完成了一場以小勝大的技術突襲。
4. 邁向連續控制新境界:Physical Intelligence $\pi_0$ (2024)
儘管 RT-2 與 OpenVLA 成效卓著,但離散化方案面臨物理規律的天然桎梏:
- 256 個分箱帶來的量化截斷誤差,在 50Hz 以上的高頻即時控制中會誘發機械手臂的微小抖動(Jittering)。
- 折疊衣物、整理軟線、拼裝瓦楞紙箱等涉及非剛性柔性形變物體的作業,必須借助極其平滑的連續動作軌跡。
Danny Driess 博士現所在的 Physical Intelligence 團隊在其最新基座模型 $\pi_0$ (pi-zero) 中創新引入了流匹配(Flow Matching)連續擴散策略:
┌──────────────────────────────────────────────────────────────────────────┐
│                   Physical Intelligence π₀ 核心技術架構                  │
└────────────────────────────────────┬─────────────────────────────────────┘
                                     │
     ┌───────────────────────────────┴───────────────────────────────┐
     ▼                                                               ▼
┌──────────────────────────┐                   ┌───────────────────────────┐
│ 高層語意 VLM 規劃器      │                   │ 連續擴散流匹配控制策略    │
├──────────────────────────┤                   ├───────────────────────────┤
│ • 場景語意理解           │                   │ • 50Hz 極速即時推理       │
│ • 長期任務步驟規劃       │ ── 潛空間目標向量 ─► • 連續向量場去噪生成        │
│ • 多步驟子目標追蹤       │                   │ • 0% 離散抖動誤差         │
└──────────────────────────┘                   └─────────────┬─────────────┘
                                                             │
                                                             ▼
                                               [平滑連續多自由度機械手臂軌跡]
                                               (成功征服折疊衣服與紙箱拼裝)
$\pi_0$ 由高層 VLM 提供語意目標,底層控制器則如同擴散圖像生成演算法一般,在連續時間維度內即時去噪輸出多自由度平滑軌跡,成為全球首個能夠同時勝任折疊衣物、收拾碗碟等極高難度柔性家務的統一通用機器人大模型。
5. 機器人基座模型橫向架構對比
+-----------------------+----------------------------------+----------------------------------+
| 評估維度              | RT-2 (Google DeepMind)           | OpenVLA (Stanford / Berkeley)    |
+-----------------------+----------------------------------+----------------------------------+
| 模型參數規模          | 55B (PaLI-X) / 12B (PaLM-E)      | 7B (Llama-2 底座)                |
| 視覺編碼器架構        | 單一視覺 Transformer (ViT)       | 語意與幾何雙融合 (SigLIP+DINOv2) |
| 動作離散化方案        | 256 區間線性均勻分箱             | 256 區間自適應分位數分箱         |
| 硬體部署門檻          | 需多節點 TPU 雲端叢集            | 單張 24GB 消費級顯示卡 (RTX 4090)|
| 參數微調效率          | 全量權重微調                     | 1.4% LoRA 低秩微調 + 4-bit 量化  |
| 開源可獲取性          | 閉源商業專有資產                 | 100% 權重與程式碼庫全量開源      |
+-----------------------+----------------------------------+----------------------------------+
6. 具身智能的安全基石:雙層硬體級反射網路
物理機器人具有強大的機械力矩,操作失誤極易摧毀精密設備甚至致傷操作人員。工業界必須為其加裝軟硬體雙重防護網路:
[VLA 模型動作增量輸出: 7DoF 指令]
                 │
                 ▼
[第一層: 軟體級運動速度與工作空間硬性截斷]
  ├── 嚴格限制最大平移速率: ||Δpos|| <= 5cm/步
  └── 強制約束在三維虛擬電子圍欄 (Bounding Box) 內部
                 │
                 ▼
[第二層: 硬體級力矩感測器極速物理反射迴路 (1000 Hz)]
  ├── 當檢測到異常外部碰撞力 F_contact > 20 牛頓:
  └── 硬體級直接切斷馬達供電 / 瞬間切換至被動柔順緩衝模式
- 軟體級動作截斷: 下層馬達驅動器會對大模型輸出的位移步長進行硬性鉗位(如單步位移嚴控在 5 公分以內),並將其活動範圍鎖死在預設的安全電子圍欄之中。
- 硬體級力矩反射迴路: 運行於關節底層的 1000Hz 感測器若在抓取中檢測到異常反向阻力(如意外磕碰到了人的手臂),將立刻無條件覆蓋上層 VLA 指令並切斷動力,依靠硬體反射神經切斷安全威脅。
7. 核心工程總結
- 物理動作是語言的全新模態: 將機械手臂運動空間離散化為詞元,實現了將全網網際網路級語意智能向物理實體的無損遷移。
- 雙視覺編碼融合至關重要: 融合 SigLIP 語意理解與 DINOv2 空間三維幾何,是機械手臂實現亞毫米級精準抓取的決定性前提。
- 分位數分箱大幅消除操控盲區: 依據真實位移分布集中分配詞元解析度,根治了機械手臂在微小操作時的失誤抓空。
- 連續擴散策略引領下一代機器人學: 如 $\pi_0$ 等流匹配架構消除了離散微顫,為柔性形變物體的靈巧操作指明了終極方向。
在下一講 Lecture 17 (GRAND FINALE) 中,我們將迎來 Stanford CS329A 的大結局,重磅呈現 《Future Research Directions: 自進化代理人的未來方向與未解之謎》,全面盤點通往真正通用人工智慧(AGI)的終極技術全景。終章再會!