📌 核心重點 (TL;DR)
- 問題 (Problem):微控制器 (Arduino Uno ATmega328P) 僅有 2KB SRAM 的極端算力瓶頸、車輪打滑 (Wheel Slip) 與超音波感測雜訊,以及 Webots 模擬物理與真實硬體之間典型的虛實鴻溝 (Reality Gap)。
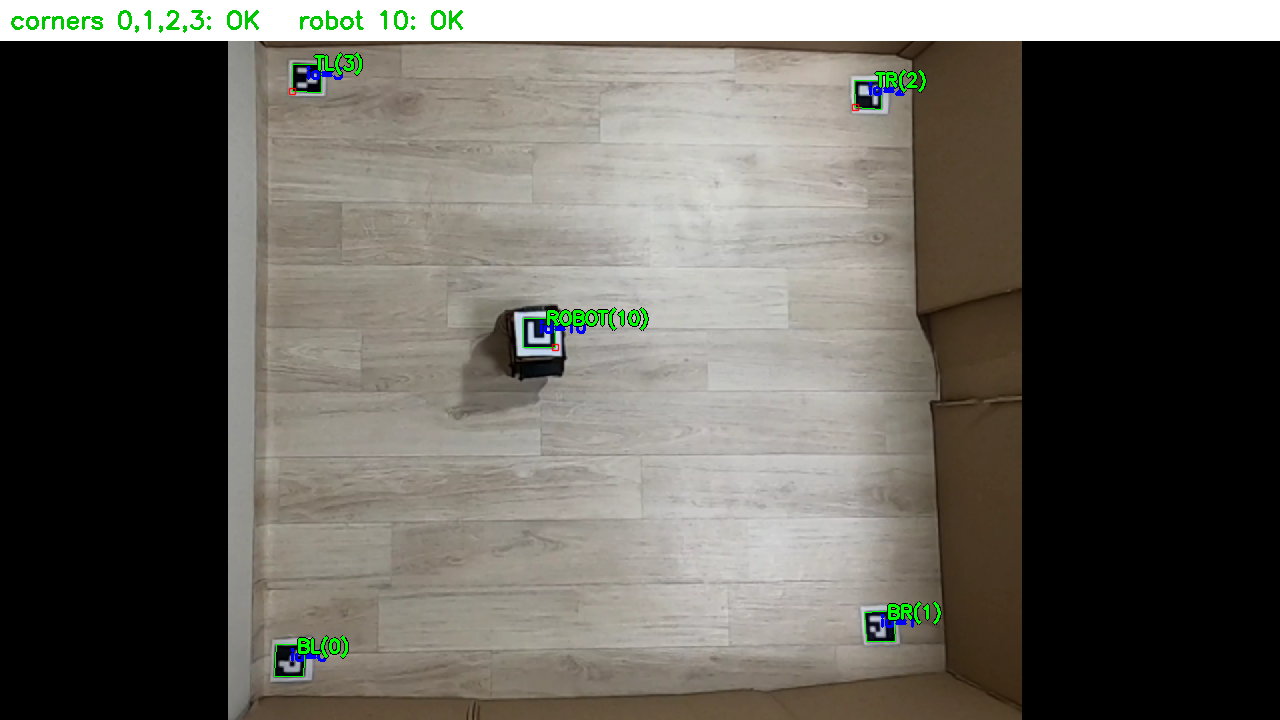
- 解決方案 (Solution):採用分散式 I/O 架構 (HC-06 藍牙, 115,200 baud),上位機 PC 負責 OpenCV 視覺處理與 Q-Table 決策,Arduino 專注馬達底層 PWM 驅動;搭配俯視攝影機棋盤格去畸變與 ArUco 標記單應性矩陣 (
vision.py),實現次公分級 (x, y, θ) 即時姿態追蹤。
- 實驗結果 (Result):模擬訓練的 648 狀態 Q 表格零樣本遷移至物理 1.2m × 1.2m 障礙場地中,在無需真實微調的情況下達成了 86.7% 的目標抵達成功率 (26/30 次試驗),成功跨越虛實鴻溝。
📌 核心重點 (TL;DR)
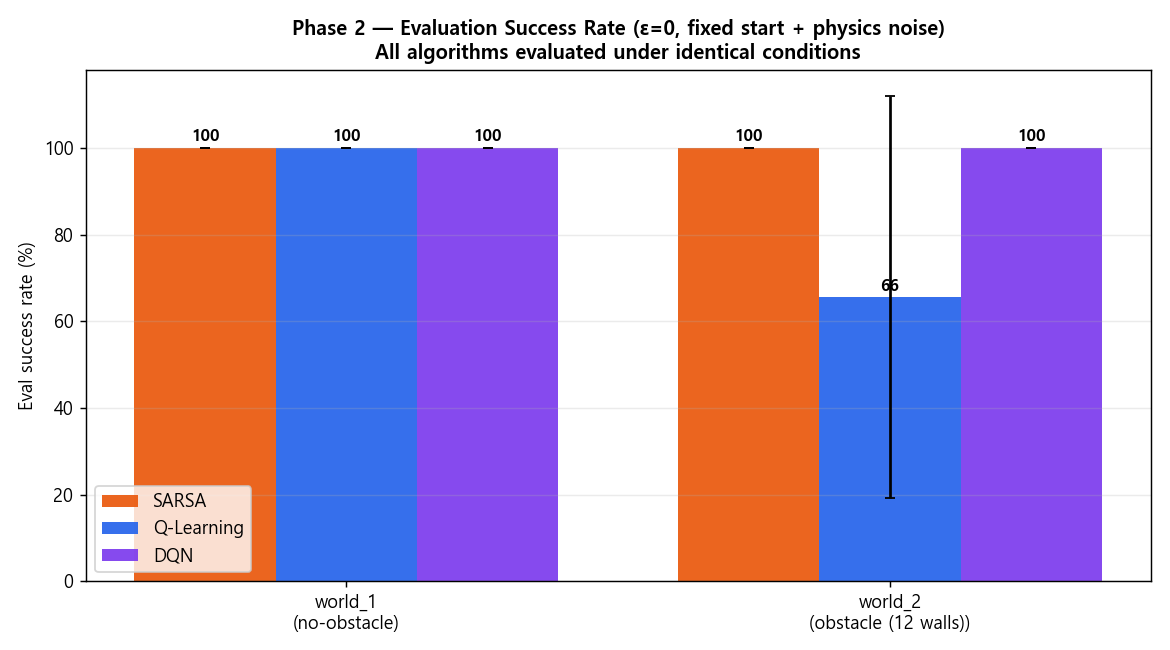
- 目的 (Objective):在完全關閉訓練探索雜訊 (ε=0) 的純確定性策略 (Greedy Policy) 下,驗證策略在真實部署環境中的自律導航可靠性與路徑品質。
- 評估方法 (Evaluation):透過
evaluate_qlearning.py 指令碼,在 5 組獨立測試隨機種子 (Eval Seeds 0~4) 上執行共計 30 輪評估,嚴密監測成功率、理論最短路徑比率 (Path Efficiency) 及接近障礙險情 (Near-miss) 頻次。
- 實驗結果 (Result):表格型 Q-Learning 在 12 牆障礙地圖中斬獲 93.3% 的確定性抵達成功率,且單步推論延遲僅為 0.02ms,在執行效率與輕量化上顯著優於沉重的深度神經網路 DQN 與保守的在線學習 SARSA。
📌 核心重點 (TL;DR)
- 問題 (Problem):在僅於目標抵達 (+1.0) 與牆面碰撞 (-1.0) 時給予反饋的稀疏獎勵 (Sparse Reward) 環境下,代理人往往需要經歷數千個回合的原地打轉或盲目徘徊,才能偶然遭遇目標,探索嚴重延遲。
- 解決方案 (Solution):設計了結合基於位能的歐氏距離增量獎勵 (+0.1 × Δdist) 與單步 (-0.01)、轉向 (-0.01)、倒車 (-0.05) 懲罰的多目標稠密獎勵塑造 (Dense Reward Shaping) 機制,並搭配指數衰減的 ε-貪婪 (Epsilon-Greedy, 1.0 → 0.05) 探索策略。
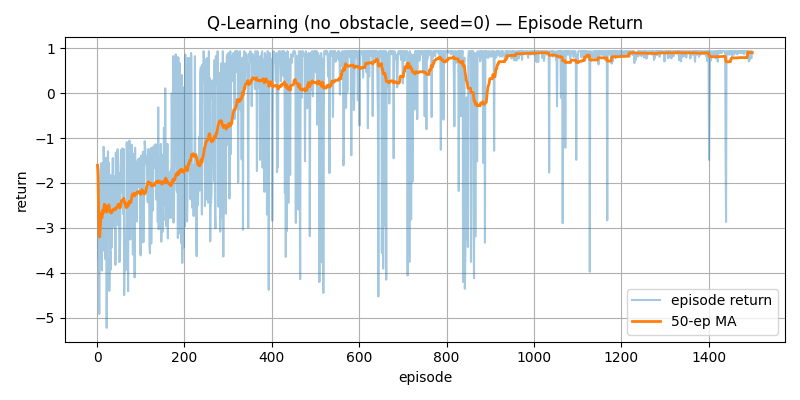
- 實驗結果 (Result):在無障礙 (
no_obstacle) 情境下,移動平均獎勵在 500 個回合以內穩健轉正並進入高位區間 (0.7+),最終導航成功率達到 98% 以上。
