[Webots 機器人] 表格型 Q-Learning 實作與獎勵函數(Reward Shaping)調優 (#2)
· 閱讀時間約 6 分鐘

📌 核心重點 (TL;DR)
- 問題 (Problem):在僅於目標抵達 (+1.0) 與牆面碰撞 (-1.0) 時給予反饋的稀疏獎勵 (Sparse Reward) 環境下,代理人往往需要經歷數千個回合的原地打轉或盲目徘徊,才能偶然遭遇目標,探索嚴重延遲。
- 解決方案 (Solution):設計了結合基於位能的歐氏距離增量獎勵 (+0.1 × Δdist) 與單步 (-0.01)、轉向 (-0.01)、倒車 (-0.05) 懲罰的多目標稠密獎勵塑造 (Dense Reward Shaping) 機制,並搭配指數衰減的 ε-貪婪 (Epsilon-Greedy, 1.0 → 0.05) 探索策略。
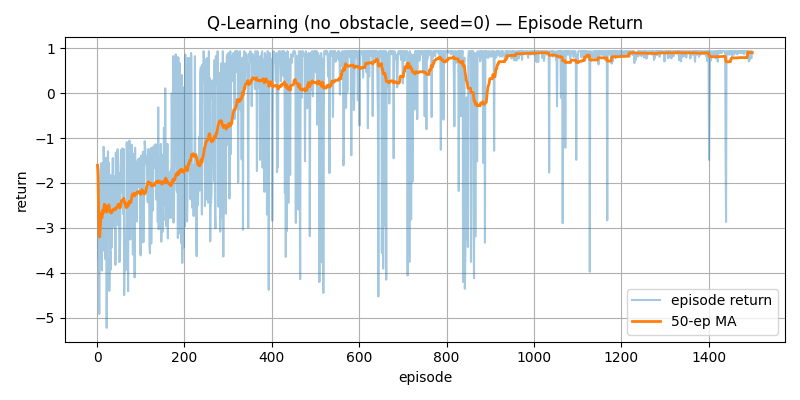
- 實驗結果 (Result):在無障礙 (
no_obstacle) 情境下,移動平均獎勵在 500 個回合以內穩健轉正並進入高位區間 (0.7+),最終導航成功率達到 98% 以上。