[Maeumjigi 心語伴侶畢業專題開發日誌 #15] 5 大模型微調成果全景視覺化與本地評測環境建置
· 閱讀時間約 2 分鐘

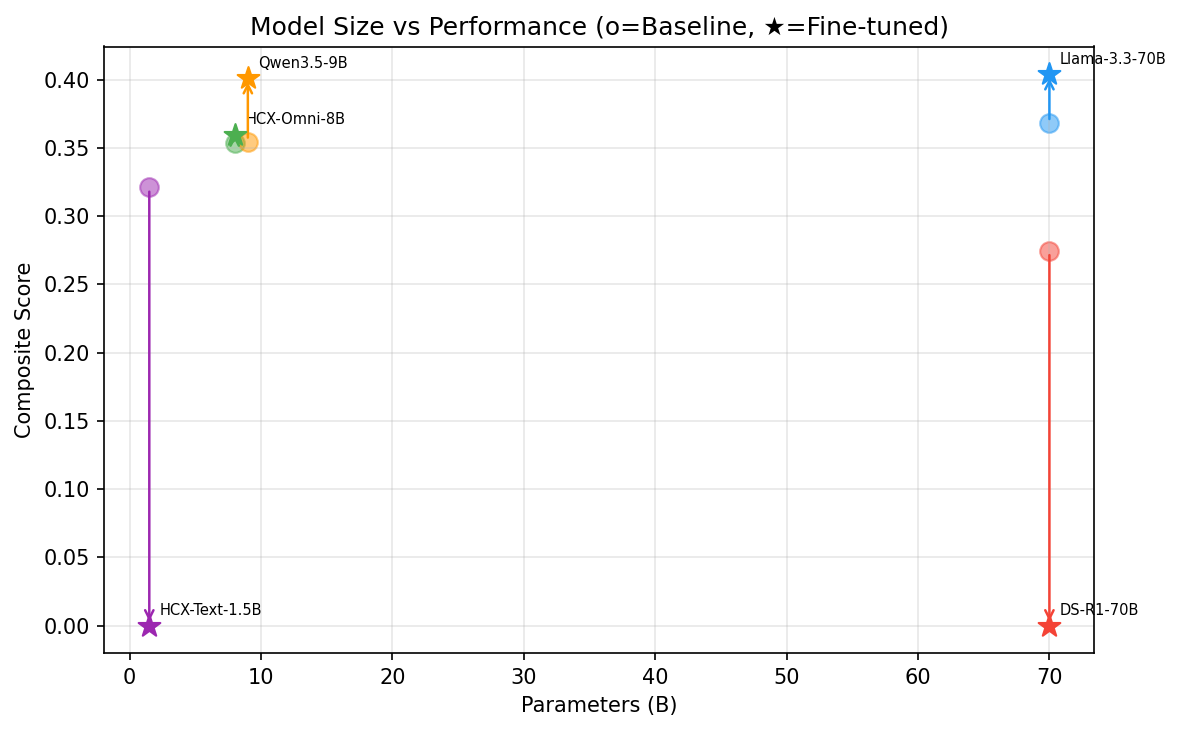
5 月 7 日,我們對傾注心血完成微調的 5 大代表性大模型(Llama 3.3-70B、DSR1-70B、HCX-Omni-8B、Qwen35-9B、HCX-Text-1.5B)的實驗資料進行了全景彙總, 並全面展開了深度視覺化與輕量化本地評測環境的建置。
5 月 7 日,我們對傾注心血完成微調的 5 大代表性大模型(Llama 3.3-70B、DSR1-70B、HCX-Omni-8B、Qwen35-9B、HCX-Text-1.5B)的實驗資料進行了全景彙總, 並全面展開了深度視覺化與輕量化本地評測環境的建置。
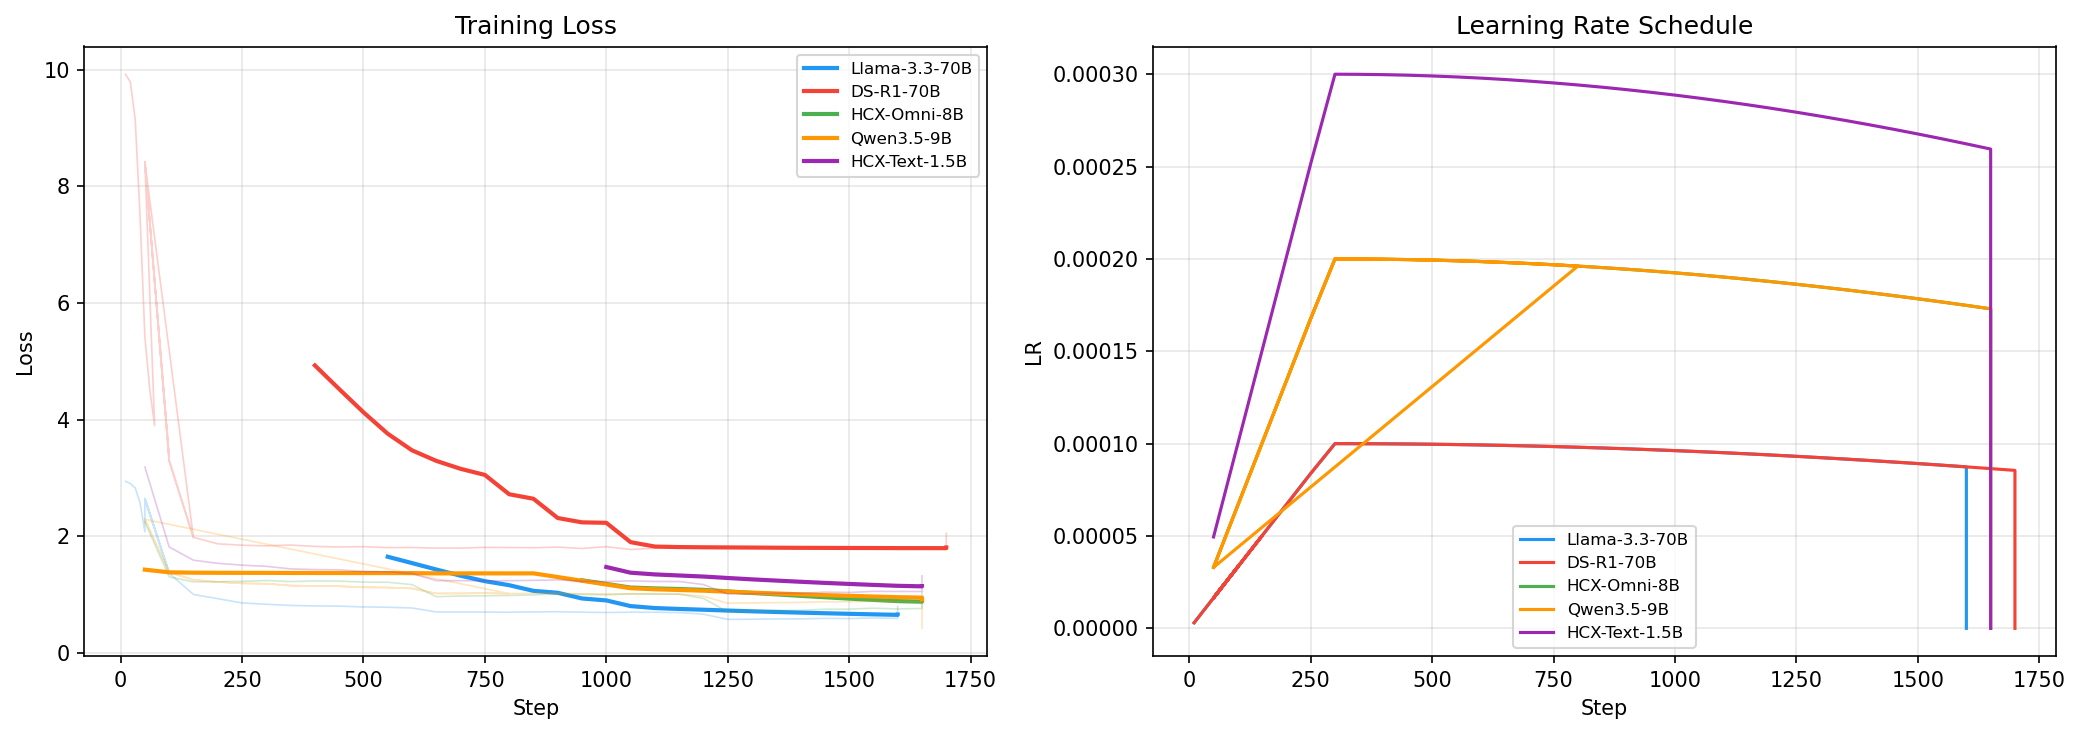
在領教了 70B 龐大參數量在微調過程中的顯示記憶體地獄後,5 月 4 日,我們果斷決定實施戰略轉向。
儘管我們曾透過將 Batch Size 壓榨至極限,勉強將 70B 模型(Llama 3.3, DeepSeek-R1)推到了 checkpoint-1200 與 1300,但極其漫長遲緩的訓練週期使得整體科研迭代效率極度低下。