[Stanford CS329A #1] 課程總覽:從大型語言模型到自我演化AI代理
· 閱讀時間約 13 分鐘

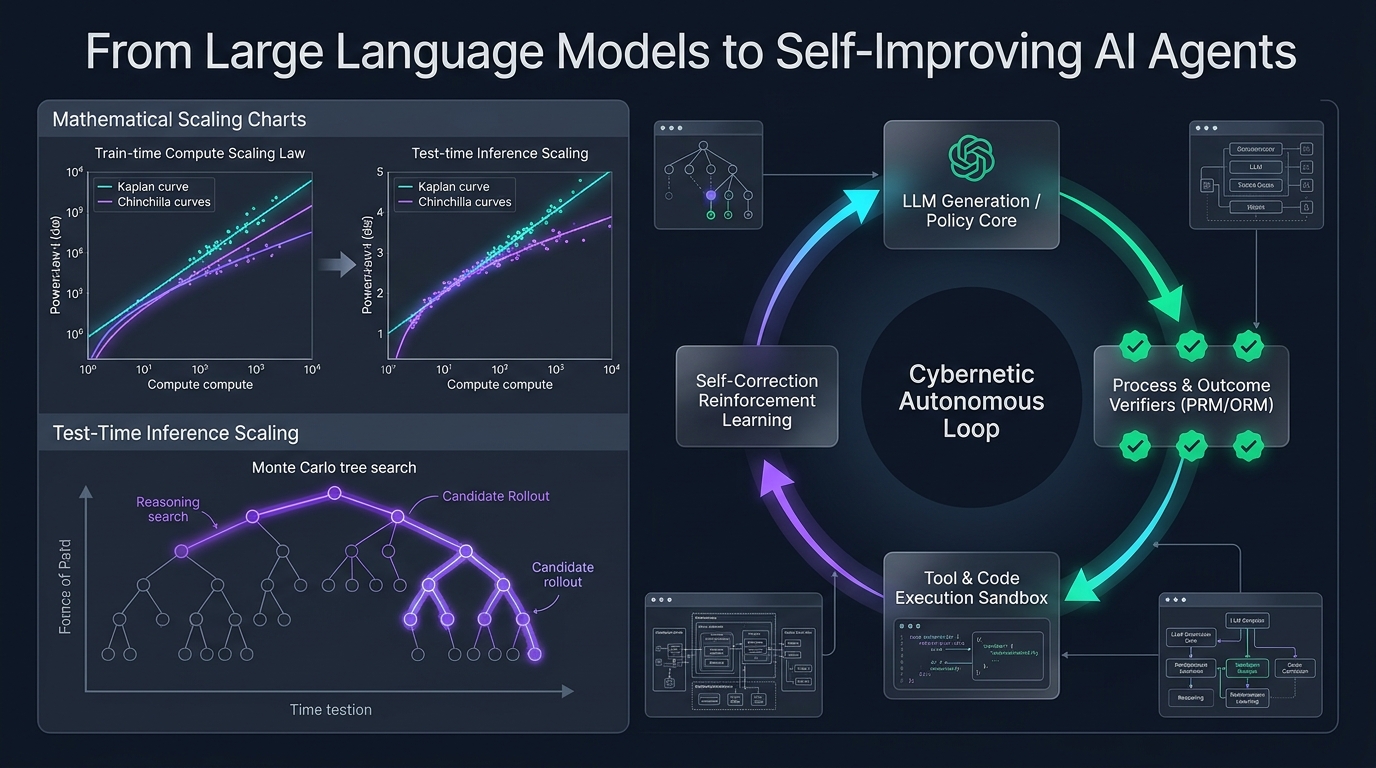
歡迎閱讀**史丹佛大學(Stanford University)CS329A:Self-Improving AI Agents(自我改進AI代理,2025秋季學期)**的核心技術解析。
在過去的四年中,人工智慧領域一直被一條強大而單一的教條所主導:在海量文本語料庫上預訓練更大規模的模型,能夠以可預測的規律持續提升認知能力。儘管這一典範催生了現代生成式AI革命,孕育出GPT-4、Claude 3.5與Gemini等突破性模型,但機器學習的研究前沿已經迎來了決定性的轉折點。
靜態基底模型(Static Foundation Model)無論參數規模多麼龐大,都存在著根本性的結構侷限:它們是在預訓練完成、權重凍結(Frozen)之後,在開環(Open-loop)體系下運行的被動、自迴歸(Autoregressive)下一標記預測器。面對棘手難題時,它們無法動態分配更多的算力,無法自主驗證自身推導的真實正確性,也無法藉助環境反饋自發糾錯。
flowchart LR
    subgraph 靜態典範 ["傳統靜態模型典範 (2020-2024)"]
        direction TB
        A1[海量網際網路語料] --> B1[超大預訓練叢集]
        B1 --> C1[指令微調 SFT]
        C1 --> D1[凍結的靜態權重模型]
        D1 -->|單次前向傳播| E1[單向文本回應]
    end

    subgraph 自主進化典範 ["史丹佛CS329A前沿:自我改進代理"]
        direction TB
        A2[複雜任務目標] ==> B2[推理與規劃引擎]
        B2 -->|草擬動作 / 程式碼| C2[沙盒環境與外部工具]
        C2 -->|執行軌跡與狀態| D2[過程獎勵驗證器 PRM]
        D2 -->|獎勵與錯誤反饋| B2
        D2 ==>|測試期與訓練期更新| E2[持續自我演化]
    end
史丹佛CS329A致力於解答未來十年AI的核心命題:「我們該如何建構不僅能生成文本,更能在動態環境中持續自我檢查、自我驗證、自我規劃並完善自身推理與程式碼的軟體代理?」
在本次開篇總覽課中,我們將解構從基底模型邁向代理系統的演進軌跡,形式化拆解擴展定律與推理期算力分配的數學機制,分析四大標準代理工作流程架構,並剖析制約自主智能演進的核心瓶頸——生成器-驗證器差距(Generator-Verifier Gap)。