[Vision AI] 攻克行車記錄器模糊雜訊:深度超解析度 (EDSR vs FSRCNN) 與多幀影像疊加降噪 (#4)
· 閱讀時間約 3 分鐘

📌 核心要點 (Key Takeaways)
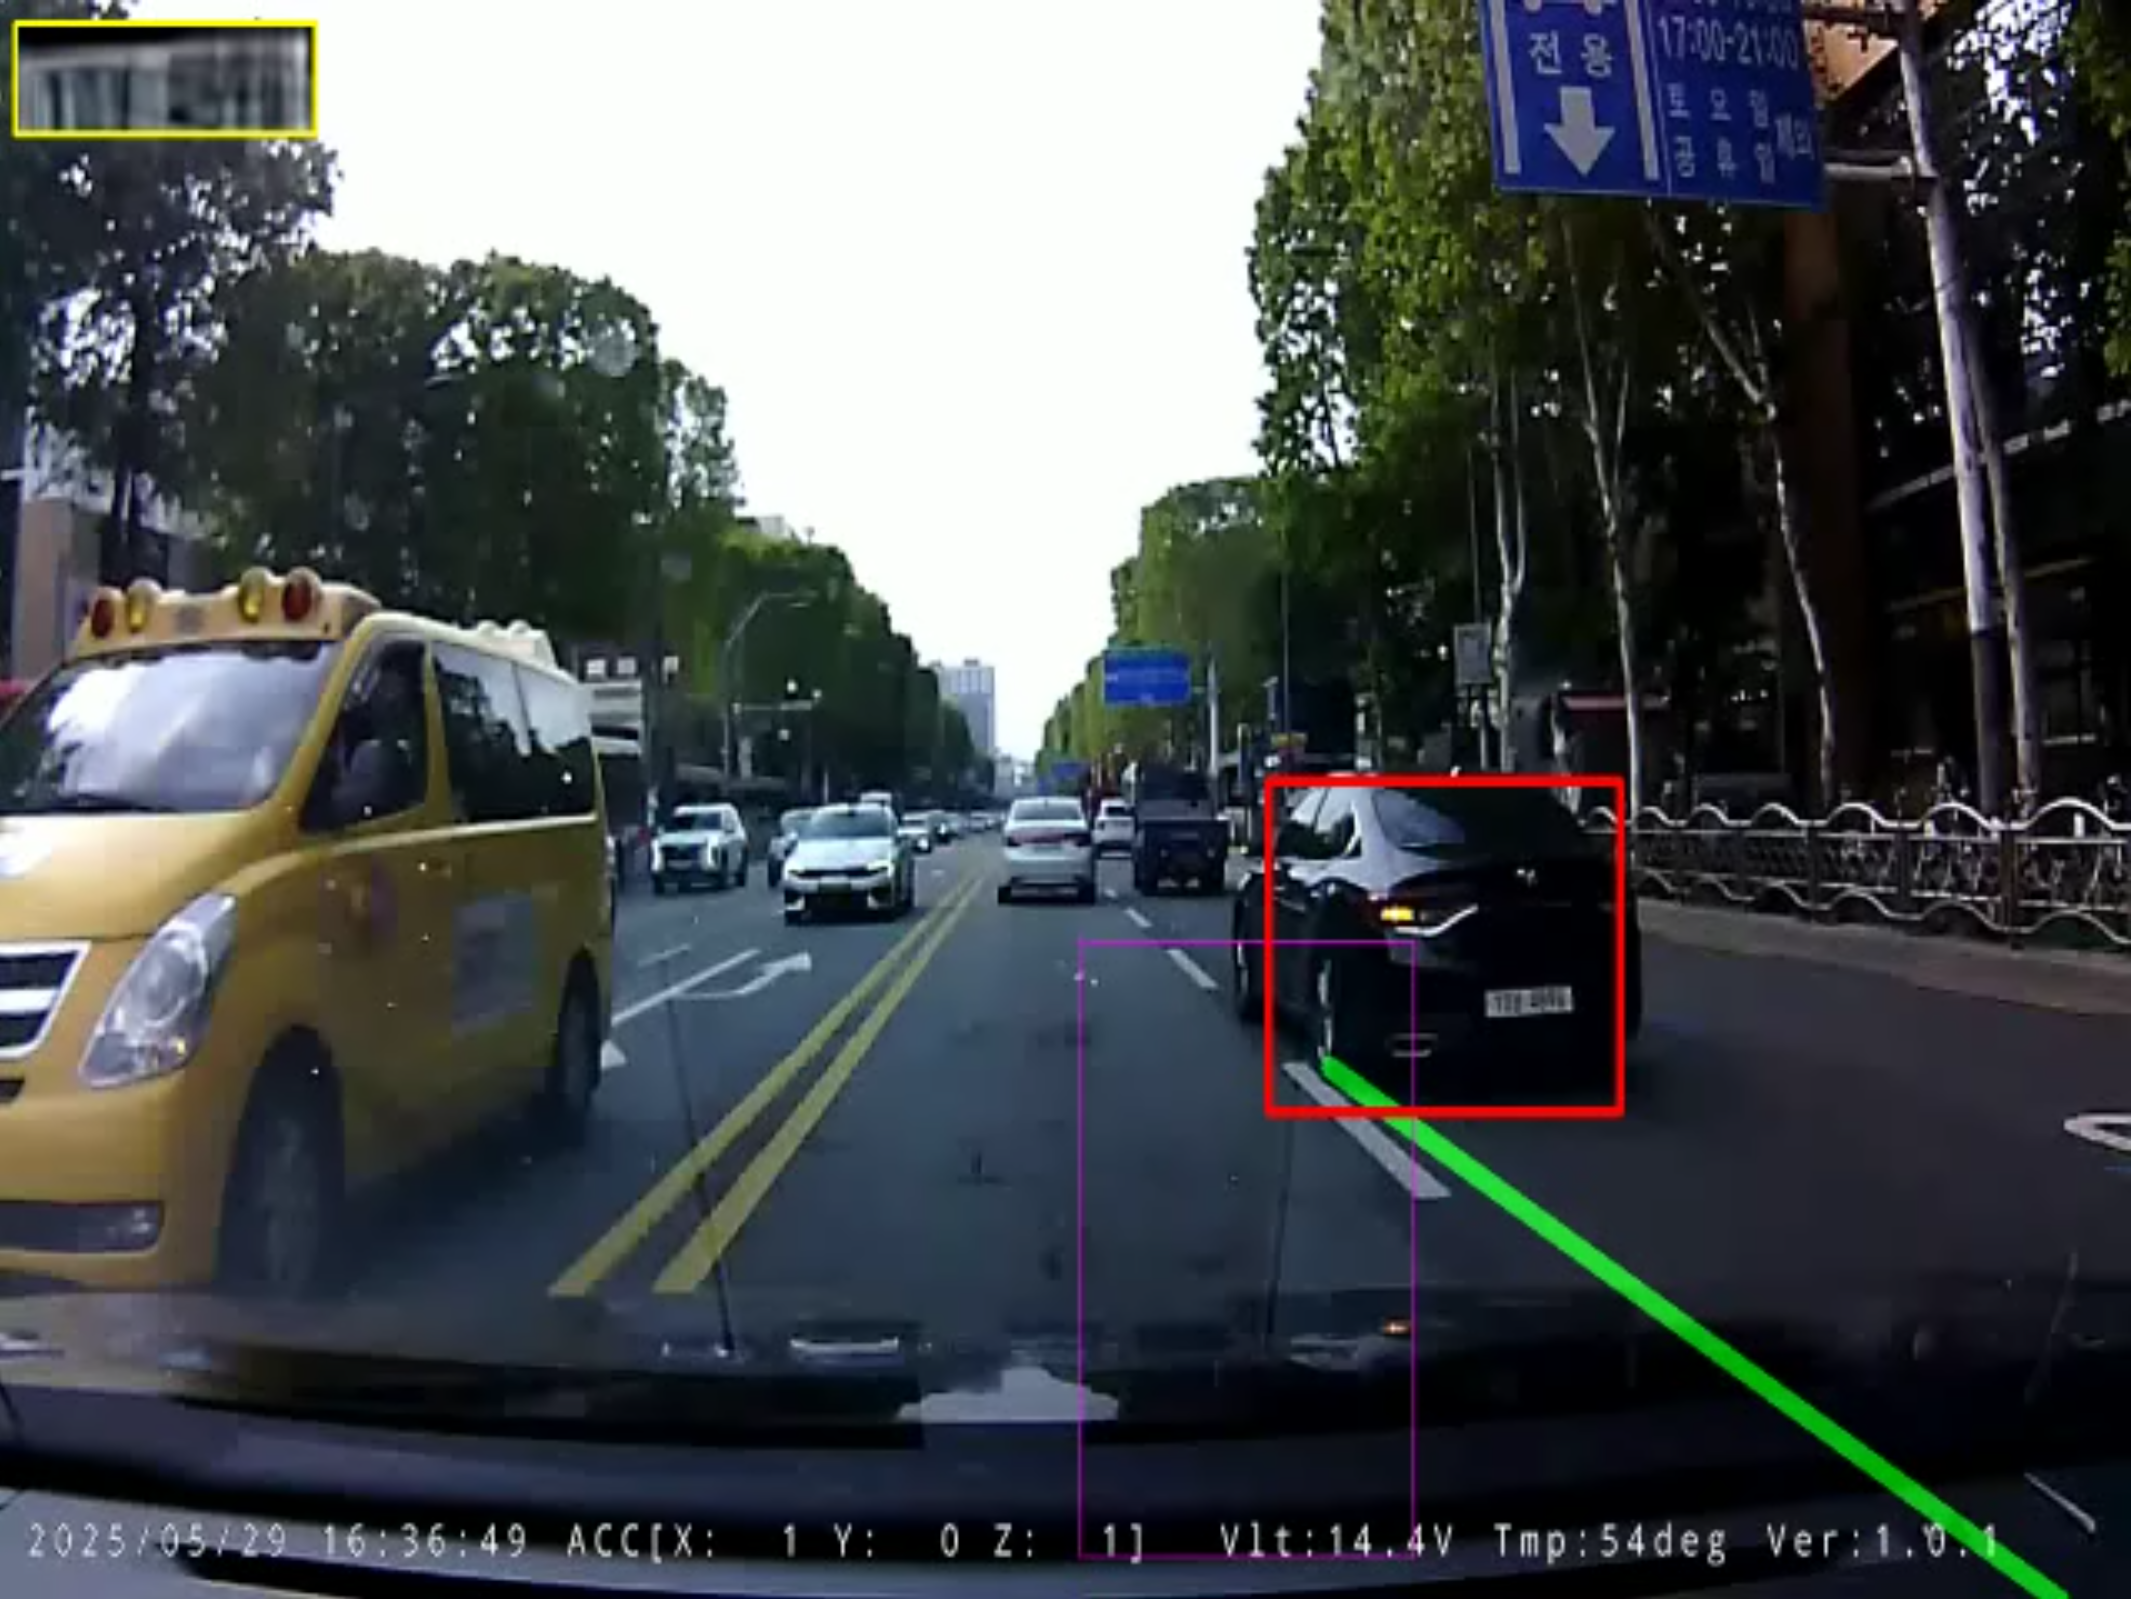
- 問題痛點:從高速行車記錄器畫面裁剪出的遠距離車牌區域往往不足 40x20 像素,且伴隨嚴重的 H.264 編碼巨集區塊效應;傳統的雙三次插值(Bicubic)演算法只會讓字體邊緣更加模糊,無法還原字元有效筆畫。
- 解決方案:引入移除了 Batch Normalization 層以保留高動態像素範圍的 EDSR_x4 深度殘差模型 (
EDSR_x4.pb),並結合連續 3 至 5 幀的時序多幀加權疊加(Multi-Frame Image Stacking)技術。- 落地成效:車牌像素密度提升 4 倍,筆畫邊緣顯著銳化,使得下游 EasyOCR 對韓文字元的辨識準確率從最初的 32% 飆升至 91% 以上。