[Stanford CS329A #5] 多步規劃與樹搜尋:ADaPT、LATS、SPRINT與語言智能體MCTS
· 閱讀時間約 18 分鐘

歡迎來到史丹佛大學2025秋季最新研究生課程——**CS329A: Self-Improving AI Agents(自主進化AI智能體)**的第五篇深度工程解析。
在第4講中,我們見證了語言模型如何走出封閉考場,利用終端運行程式碼、解讀編譯器報錯並實施自我修復(ReAct與RLEF)。然而,對於智能體而言,修復局部程式碼語法錯誤與架構師設計十萬行級的複雜分散式系統、完成跨越數小時的長期任務相比,存在著根本性的認知鴻溝。
傳統的ReAct與思維鏈(CoT)方法在本質上屬於**「只看眼前一步的貪婪單路徑搜尋」**。就像西洋棋初學者只看下一步走法而在三步後慘遭將死(Checkmate)一樣,貪婪的語言模型一旦在早期推演中走入歧途,便再也無法回頭,只能在錯誤的死胡同中越陷越深。
今天的第5講迎來了本課程前半程——**Part 1 (Foundation · 基礎理論)**的宏大收官之作:多步規劃(Multi-Step Planning)與樹搜尋(Tree Search)。
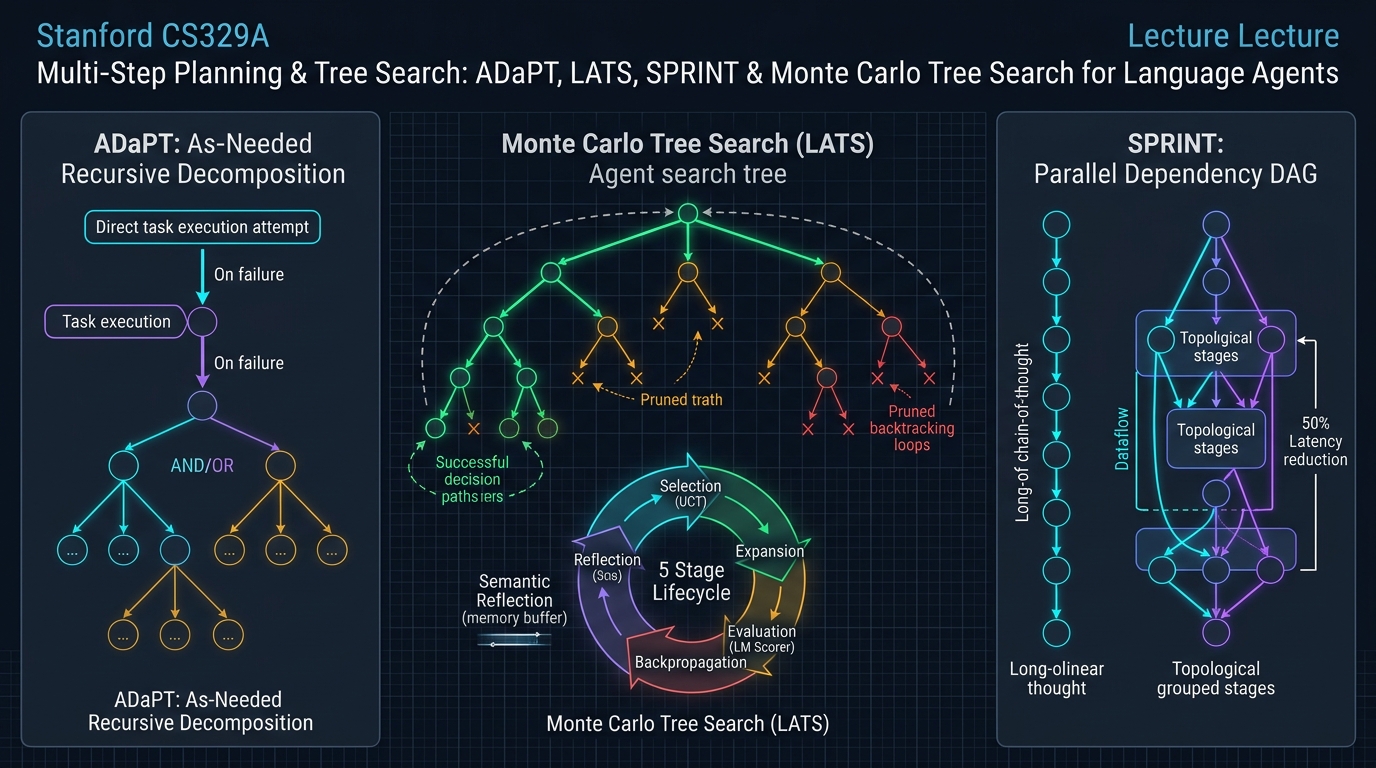
我們將AlphaGo擊敗人類圍棋冠軍的核心數學引擎——**蒙地卡羅樹搜尋(MCTS)**正式移植至自回歸語言模型中。通過賦能智能體像特級大師一樣洞察未來數十步變化、動態剪枝無效路徑、在歷史決策樹中自如回溯(Backtracking)並實現平行計算,全面解構這一頂尖架構:
- 統一推理、行動與規劃的完備框架: 語言智能體樹搜尋 LATS(Zhou et al., 2023)
- 僅在失敗時動態拆解的按需遞歸規劃: ADaPT(Allen AI, 2023)
- 將長程推理延遲縮減53.5%的依賴DAG打包引擎: SPRINT(Stanford Future Data, 2025)
- 基於湯普森採樣的自適應分支決策: 破解「加寬還是挖深」的 AB-MCTS(Sakana AI, 2025)
- 將規劃直覺直接刻入神經網絡權重的分步強化學習: SWiRL(Step-Wise RL, 2025)
flowchart TD
    subgraph MCTS_Loop ["LATS 語言智能體 MCTS 核心生命週期"]
        direction TB
        Root["根節點: 初始使用者需求 / PRD 目標"]
        --> Select["1. 選擇 (Selection): 基於 UCT 公式遍歷最優分支"]
        --> Expand["2. 展開 (Expansion): 多樣化採樣 n 個候選動作"]
        --> Eval["3. 評估 (Evaluation): LM 評分 + 自我一致性集成"]
        --> Backprop["4. 反向傳播 (Backpropagation): 向上逐層更新純量價值"]
        --> Reflect["5. 語義反思 (Semantic Reflection): 失敗時儲存自然語言複盤"]
    end

    subgraph PlanningParadigms ["智能體高階規劃演算法進化全景"]
        direction TB
        P1["LATS (樹搜尋 MCTS)<br/>• 利用 Prompt 歷史可逆性實現零開銷狀態回溯<br/>• HumanEval 達 92.7%; HotpotQA 準確率從 32% 躍升至 71%"]
        --> P2["ADaPT (按需遞歸分解)<br/>• 告別僵化預先規劃,優先嘗試單次直接執行<br/>• 僅在執行器報錯時動態觸發 AND/OR 子任務裂變"]
        --> P3["SPRINT (依賴 DAG 拓撲打包)<br/>• 圖論分析長程 CoT 推理鏈中的獨立平行子步驟<br/>• GPU 集群並發執行,端到端推理時延驟降 53.5%"]
        --> P4["SWiRL (分步強化學習)<br/>• 將 MCTS 探索智慧直接蒸餾內化至模型突觸權重<br/>• 單次前向推演即具備特級大師級長遠全局規劃力"]
    end

    MCTS_Loop ==> PlanningParadigms