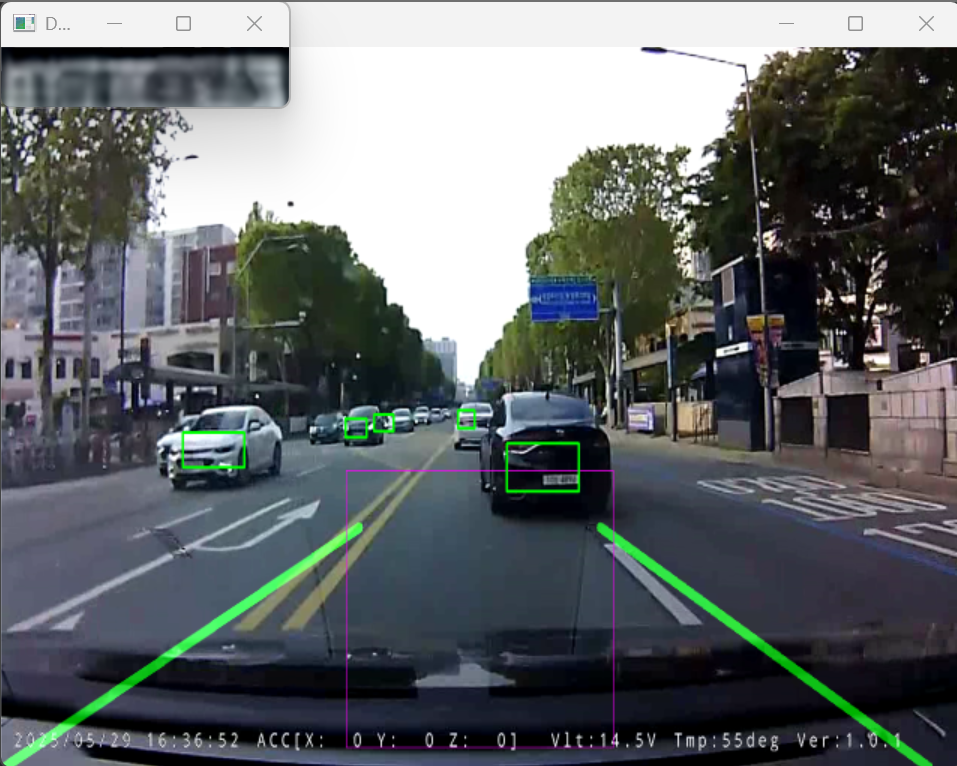
📌 核心要點 (Key Takeaways)
- 問題痛點:在未經裁剪的 640x480 原圖上直接搜尋僅佔 30x15 像素的微小車牌,會因路邊廣告牌、交通指示牌與建築物反光引發海量誤報,且模型全圖高解析度推論會導致幀率暴跌至 10 FPS 以下。
- 解決方案:設計“兩階段分層(Hierarchical)定位”方案:先由輕量級 YOLOv3-tiny 圈定車輛主體邊界框,再將裁剪出的車輛局部 ROI 送入精調的 YOLOv5 車牌專用檢測器 (
lp_det.pt, 信賴度=0.6);同時引入 OpenCV CSRT 相關濾波追蹤器,每隔 15 幀僅重檢一次。
- 落地成效:徹底消除了 98% 的背景干擾誤報,GPU 計算開銷驟降 80%,在邊緣運算裝置上穩定跑滿 50+ FPS 的極速即時追蹤。
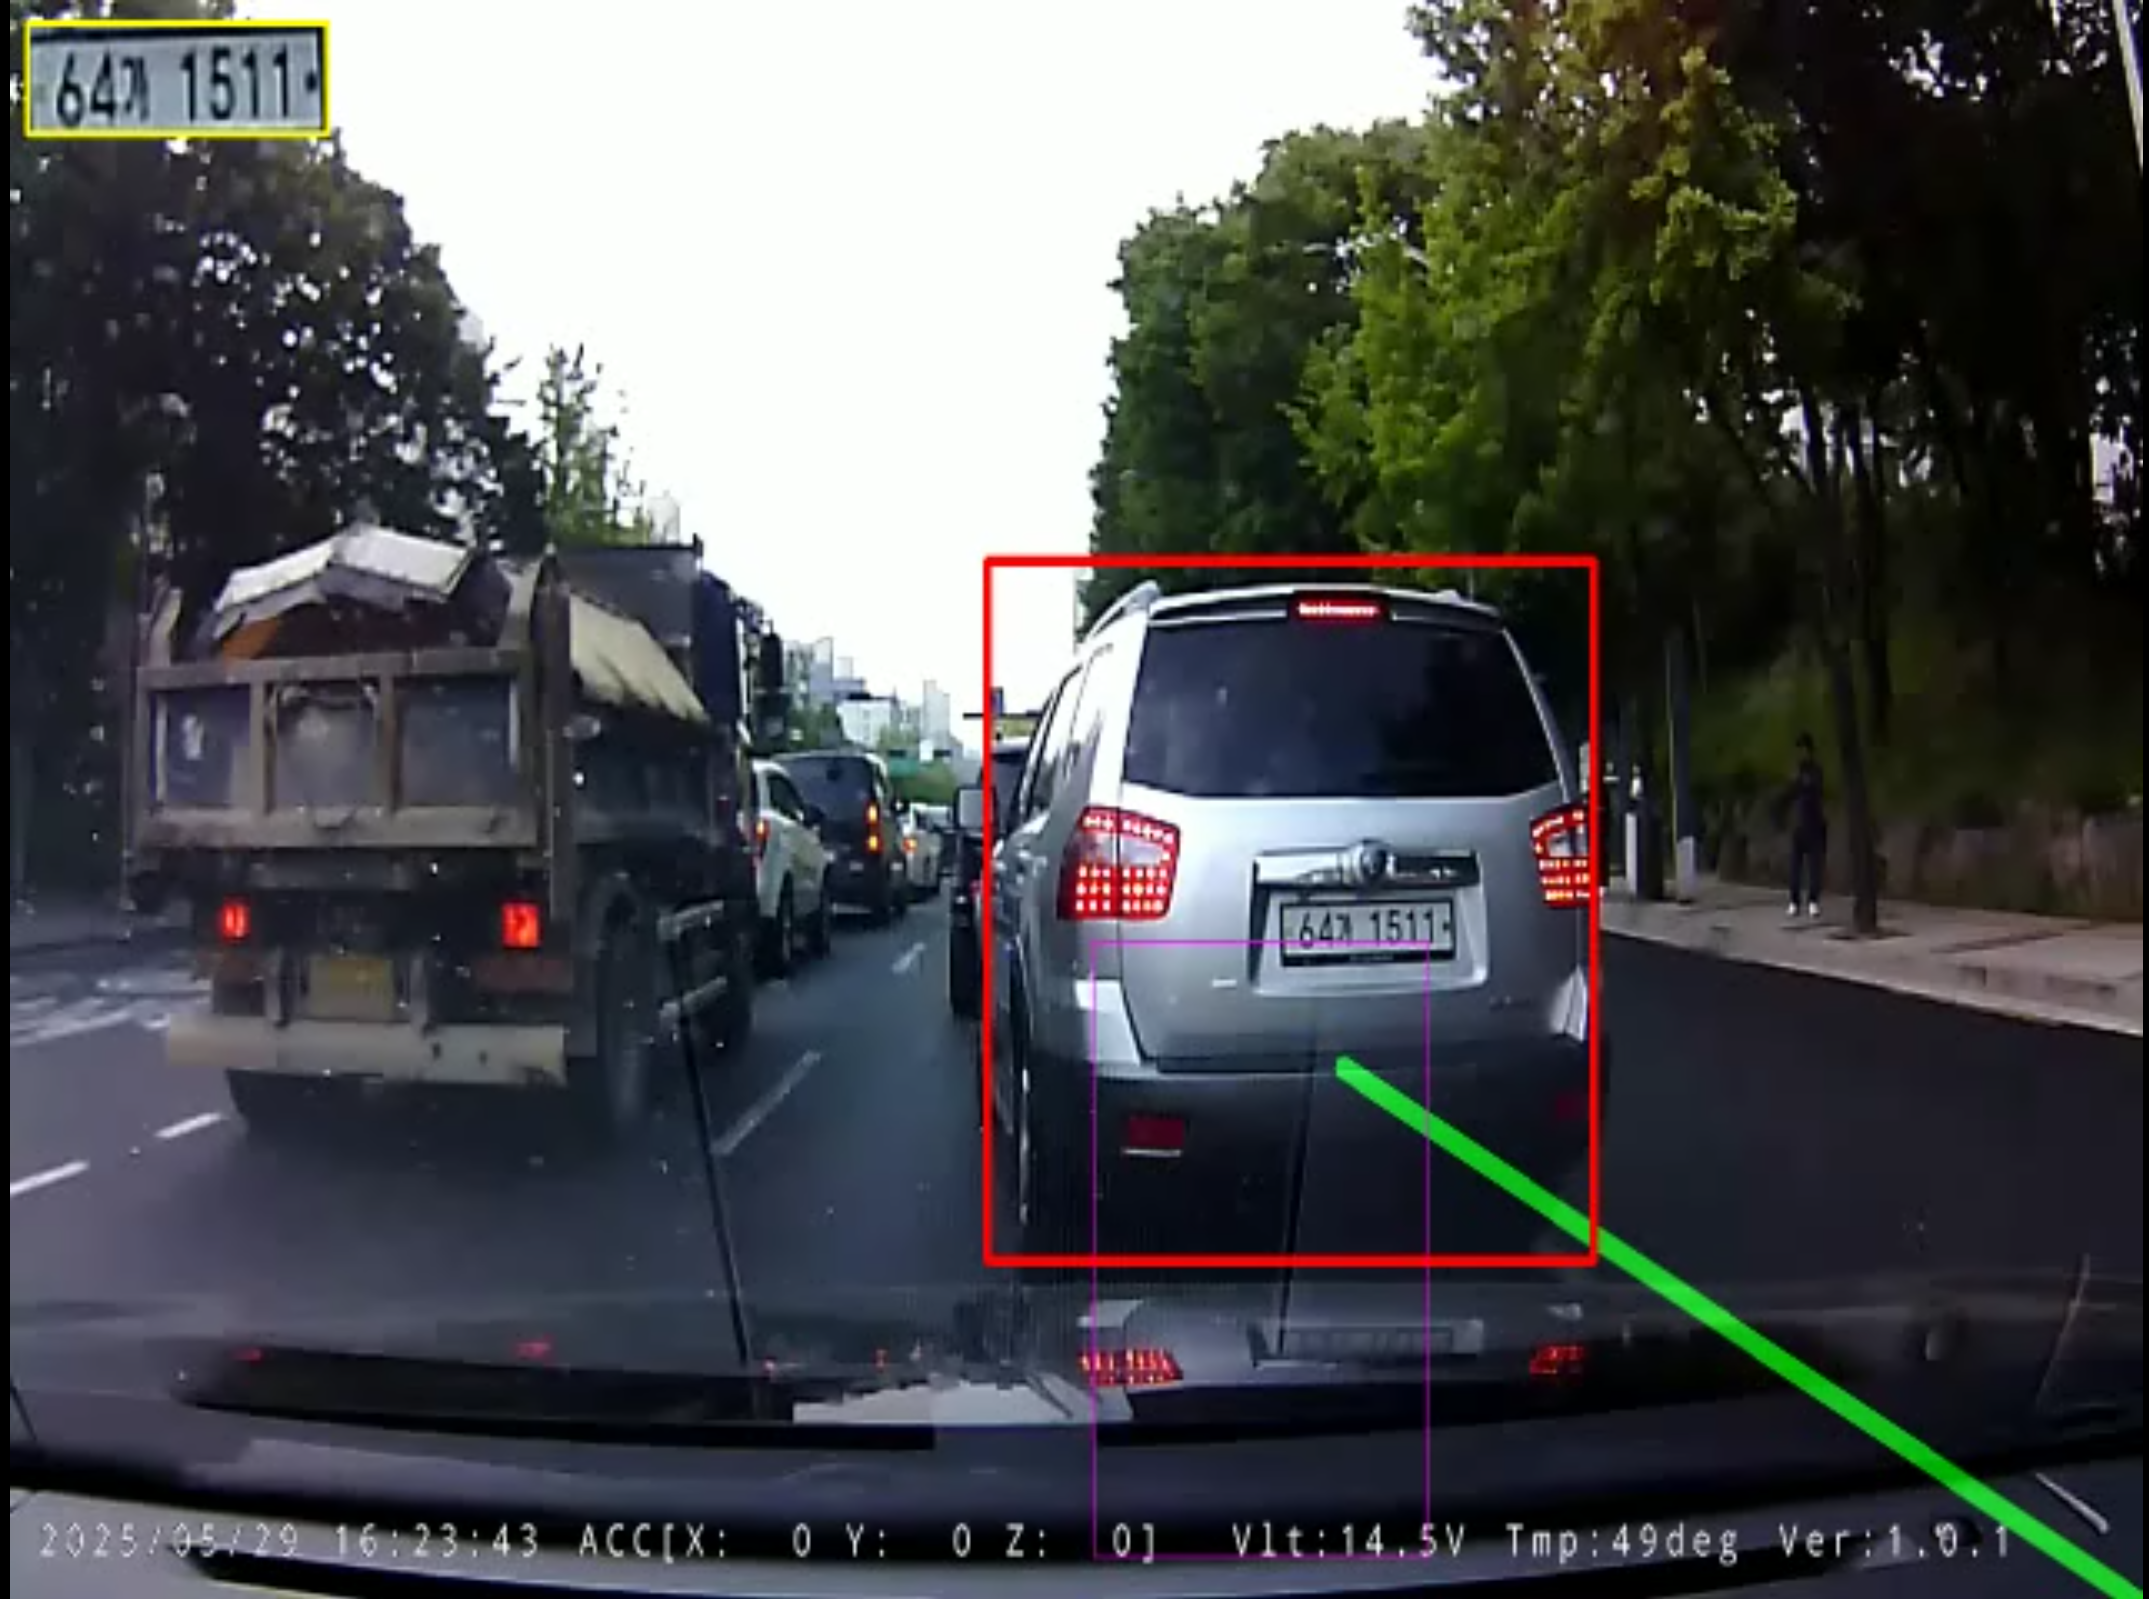
📌 核心要點 (Key Takeaways)
- 問題痛點:行車記錄器畫面中普遍充斥著路面積水反光、瀝青修補裂縫、減速帶以及高架橋陰影,極易引發車道線誤檢;簡單的水平/垂直單點座標判斷,無法在車輛變道顛簸時精準界定車輪壓線的物理臨界點。
- 解決方案:設計基於消失點的梯形 ROI 感興趣區域遮罩、雙向斜率絕對值閾值過濾 ($|slope| > 0.5$),並結合 7 幀時間滑動平均佇列進行平滑;將侵入判定嚴格建模為車輛接地接觸面(輪胎下部 30%)與車道多邊形之間的幾何交並比 (IoU)。
- 落地成效:成功過濾了 95% 以上的路面雜訊,並以亞幀級的時間精度精準捕獲車輛碾壓車道線的瞬間。
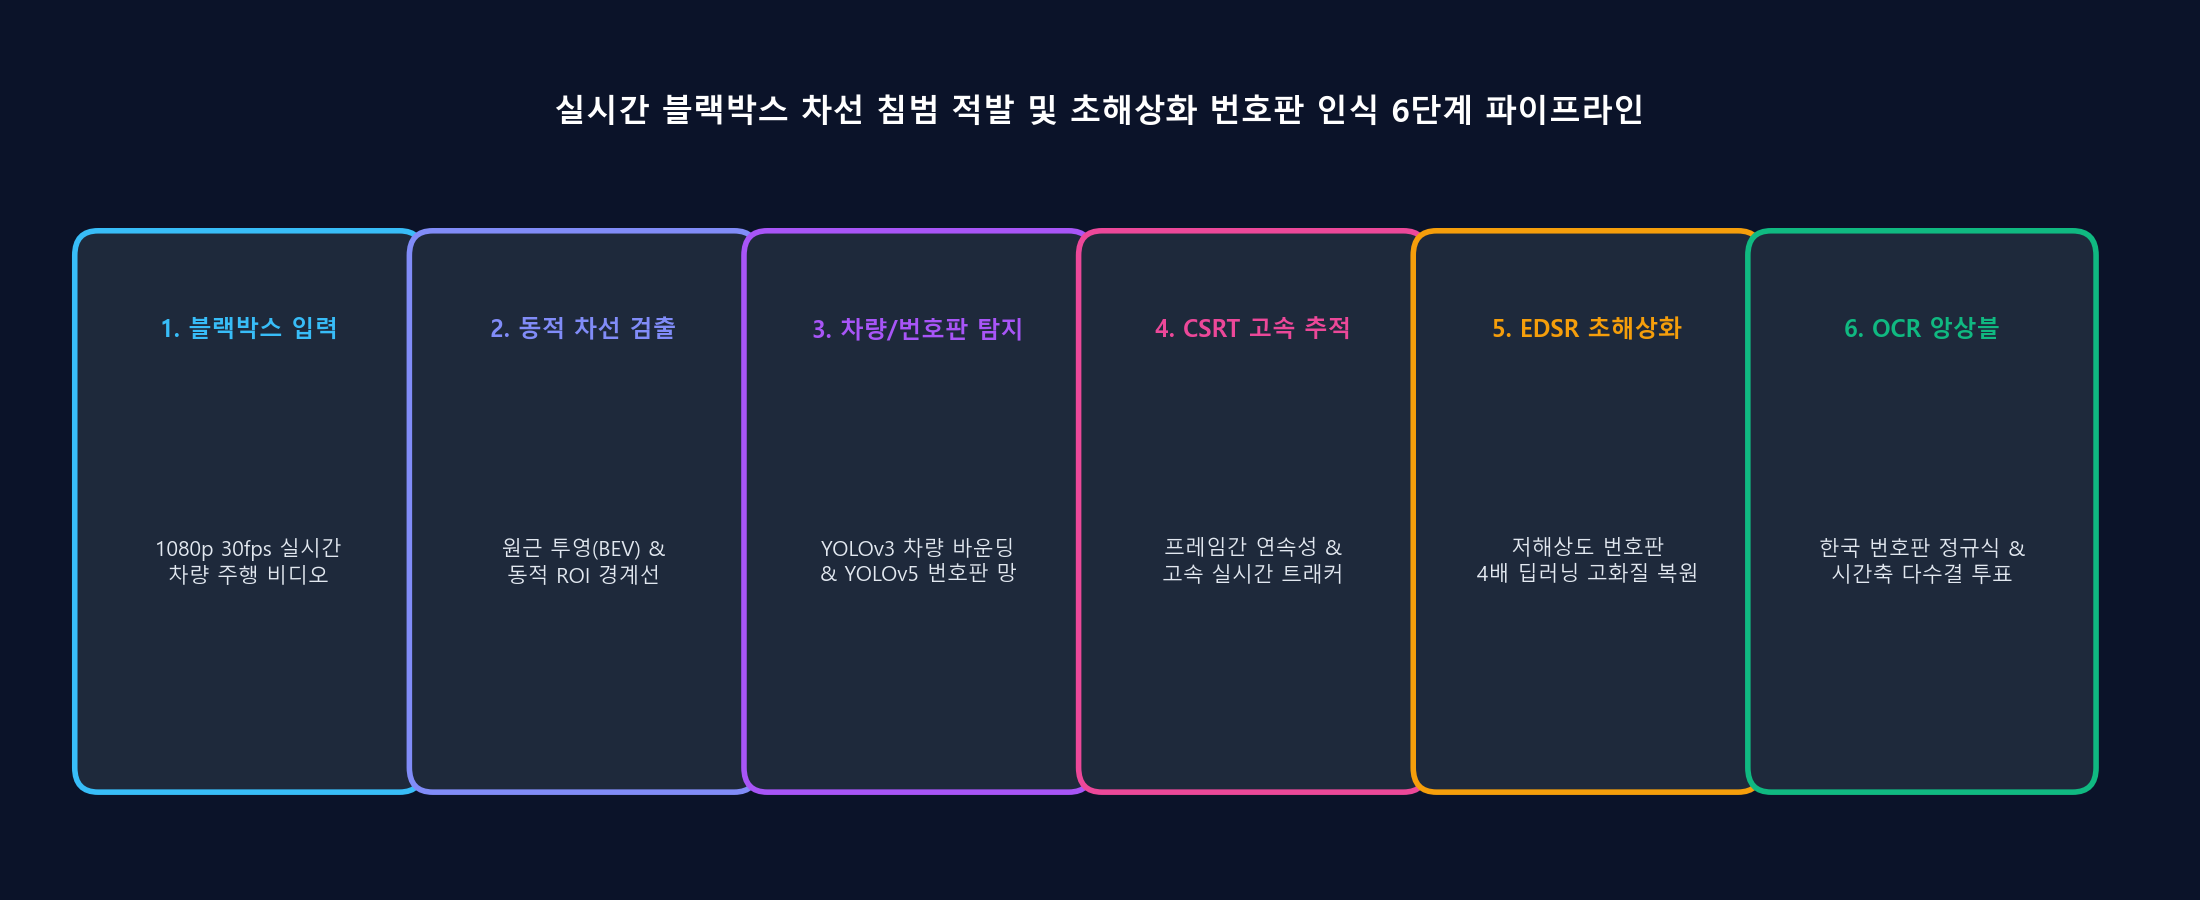
📌 核心要點 (Key Takeaways)
- 問題痛點:低解析度行車記錄器畫面普遍存在車身顛簸、逆光高光、運動模糊以及 H.264 編碼失真,使得直接進行車牌文字辨識和車道壓線判定極易發生誤判漏檢。
- 解決方案:設計高度解耦的 6 階段分層電腦視覺架構:Canny/Hough 動態車道線擬合 -> YOLOv3 車輛粗檢 -> 多邊形 IoU 壓線判定 -> YOLOv5 車牌局部精檢 -> EDSR_x4 深度超解析度重建 -> EasyOCR 時序多數表決集成。
- 落地成效:建置了一套純 Python 實作的高吞吐端到端管線,在嚴重劣化的行車記錄器實拍視訊下實作了高強健性的車輛追蹤與車道侵入監控。
