[Stanford CS329A #3] 穩健答案驗證:過程獎勵模型(PRM)、集成與可擴展監督
· 閱讀時間約 15 分鐘

歡迎閱讀史丹佛大學2025年秋季前沿研究所課程**CS329A: Self-Improving AI Agents(自我演進AI代理人)**的第三篇專業工程深度解析。
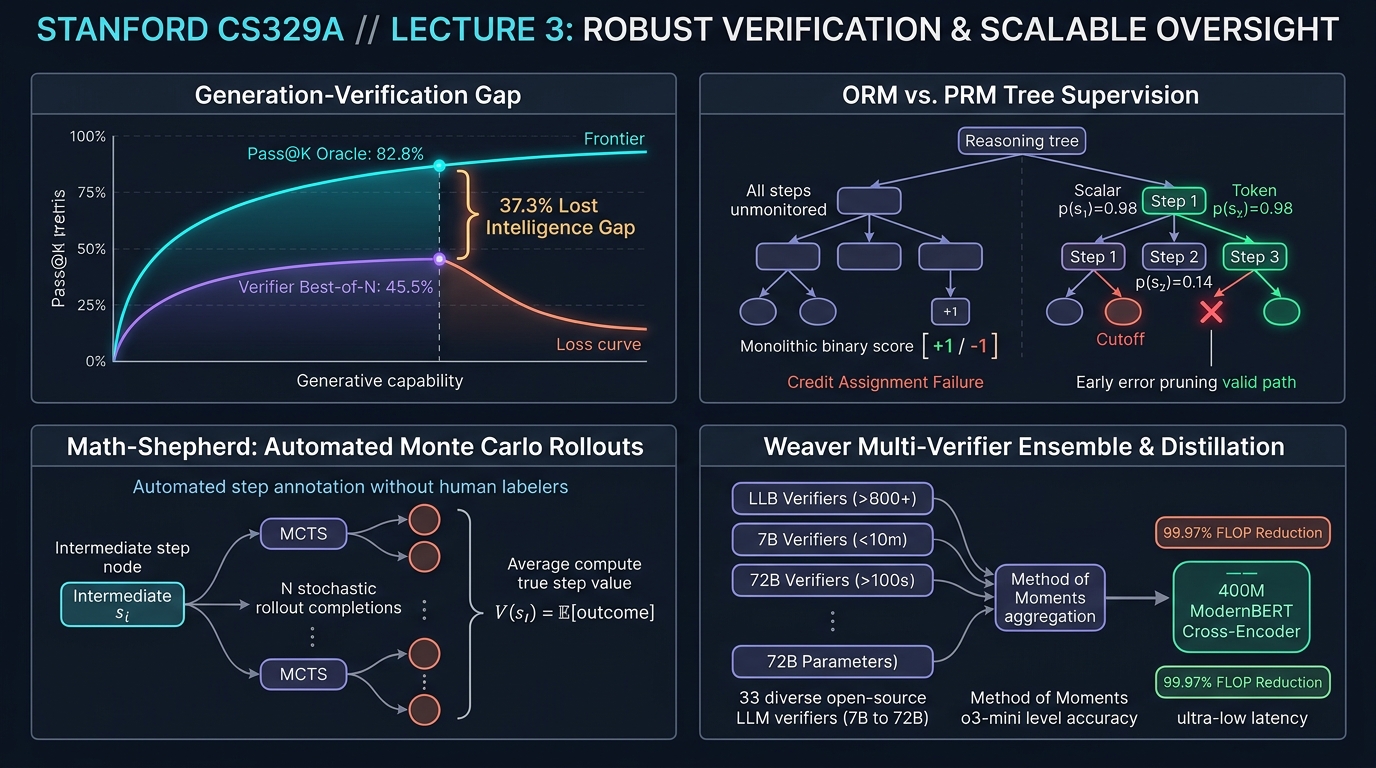
在上一講(第二講)中,我們系統剖析了推理時間計算縮放(Test-time Compute Scaling),並得出了一個深刻的結論:單純讓模型產生數千個候選答案($pass@k$)能夠將理論上的覆蓋率推向99%以上,但**「如果沒有高精度的驗證器(Verifier)從浩瀚的錯誤草堆中挑出唯一正確的繡花針,無論是多數投票還是盲目重抽樣,模型效能都會迅速撞牆停滯」**。
今天第三講所探討的,正是解決這一致命瓶頸的核心系統級工程:穩健答案驗證(Robust Verification)。
人類數學家或軟體工程師在解決複雜課題時,絕不會憑空一筆劃出完美推導;他們寫下一行演算,複核代數合理性,捕捉正負號的筆誤,並在誤入歧途前及時回溯(Backtracking)。相反,標準的自迴歸語言模型只能向未來單向輸出標記。一旦初始推理發生輕微偏差,模型為了自我圓謊,便會在此基礎上炮製出越來越荒謬的幻覺(Hallucination)。
那麼,「我們能否訓練獨立的驗證模型,對生成模型每一步的中間推理進行逐行嚴格質檢,提前修剪死胡同?」
從OpenAI的奠基之作Cobbe GSM8K驗證器,到Lightman的分步過程監督(PRM800K),再到無需人類標註、基於蒙地卡羅自動擴展打分的Math-Shepherd,以及最新透過統計物理矩估計法集成33個弱驗證器達到o3-mini水準的Weaver(NeurIPS 2025),我們將系統拆解並掌握驗證器工程(Verifier Engineering)的最前沿技術。
flowchart TD
    subgraph Gap ["核心痛點:生成-驗證差距 (Generation-Verification Gap)"]
        direction TB
        G1["Pass@100 理論上限: 82.8% (生成端上限)"]
        G2["多數投票法實際提取率: 45.5% (實際提取效果)"]
        G1 -.->|"選別失敗導致損失 37.3%p 潛在智慧"| G2
    end

    subgraph Solutions ["答案驗證系統的四代演進路徑"]
        direction TB
        S1["結果獎勵模型 (ORM)<br/>• 僅針對最終答案給出二元打分 (+1 / -1)<br/>• 信用分配失效 (Credit Assignment Failure)"]
        --> S2["過程獎勵模型 (PRM800K)<br/>• 標記級分步監督打分 p(step_i)<br/>• 早期錯誤感知即刻剪枝與機率乘積評估"]
        --> S3["Math-Shepherd (無監督MCTS擴展)<br/>• 無需人類標註的自動蒙地卡羅分步標註<br/>• 評測表現全面超越人類標註的PRM800K"]
        --> S4["Weaver 弱驗證器集成<br/>• 矩估計法 (Method of Moments) 無監督集成 (33個弱驗證器)<br/>• 400M ModernBERT 交叉編碼器蒸餾 (計算量削減 99.97%)"]
    end

    Gap ==> Solutions