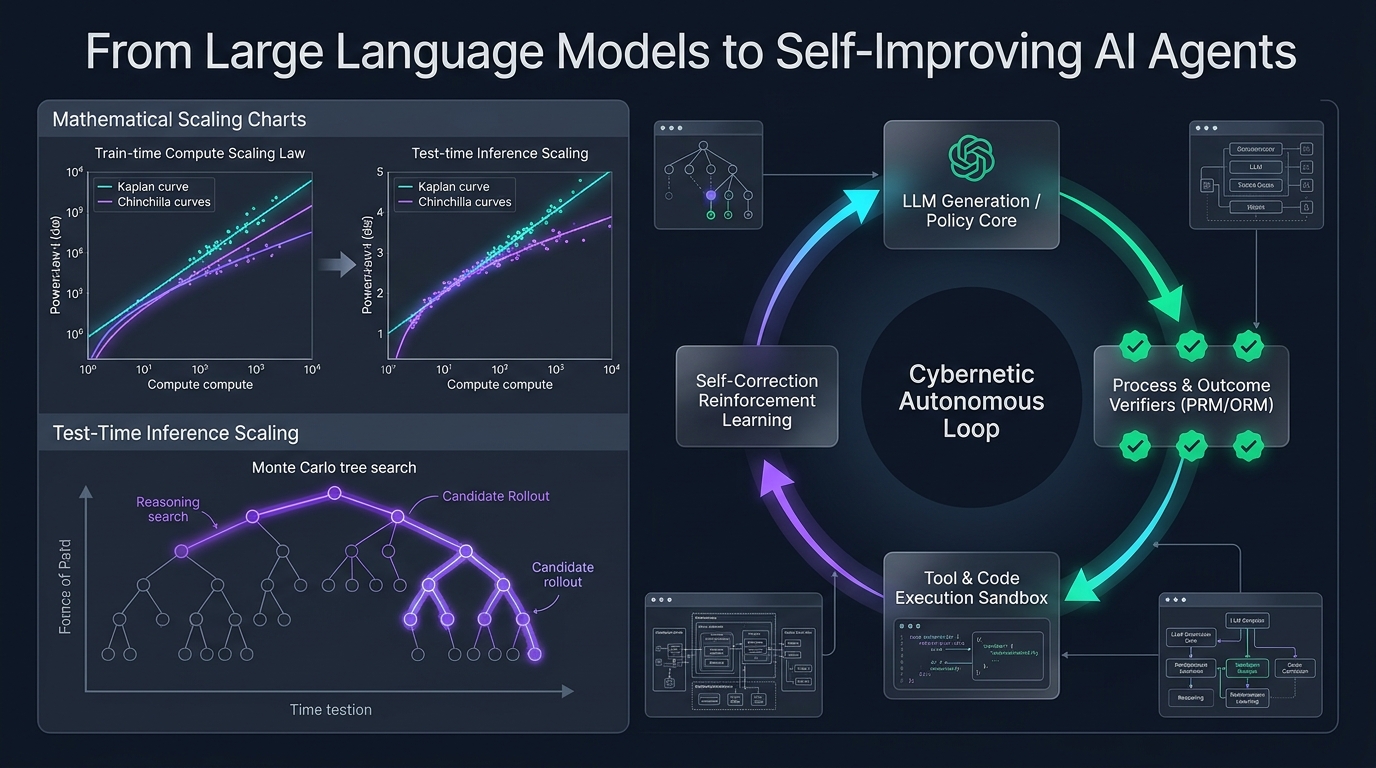
[Stanford CS329A #2] 推理時間計算縮放:超越預訓練縮放定律邁向計算最佳推理
· 閱讀時間約 14 分鐘

歡迎閱讀史丹佛大學2025年秋季最新頂尖研究所課程**CS329A: Self-Improving AI Agents(自我演進AI代理人)**的第二篇專業工程解析。
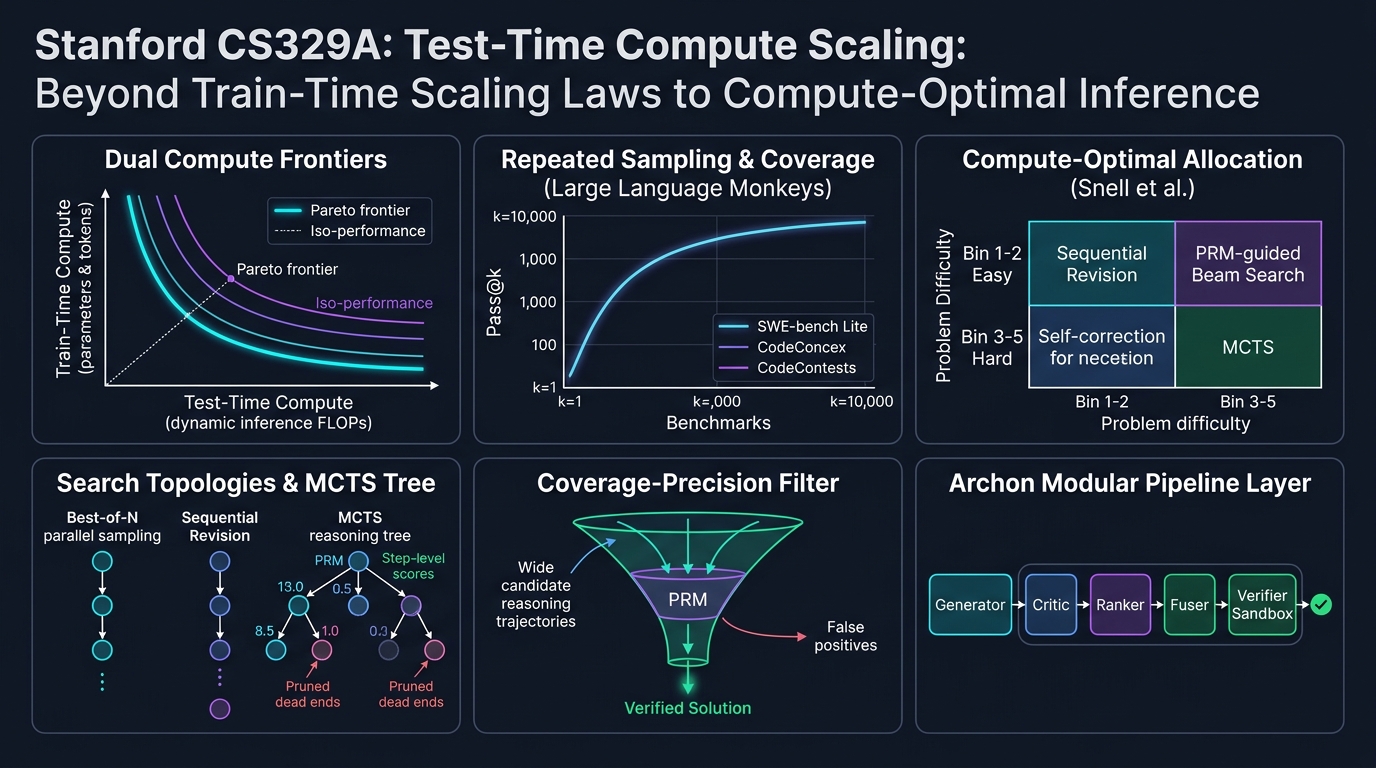
在第一講中,我們綜述了從靜態自迴歸次詞預測器邁向具備環境反饋閉環的自主代理人之宏觀範式躍遷。今天第二講所探討的,正是支撐此自主演進能力的最核心計算支柱:推理時間計算縮放(Test-Time Compute Scaling / Inference-Time Scaling)。
過去五年間,整個AI產業界信奉的唯一教條是預訓練階段的縮放定律(Kaplan等人,Chinchilla定律):建造超大規模GPU叢集,將模型參數規模N推升至數千億級,並灌注數十兆標記(Tokens)的網路資料。然而,在模型權重θ預訓練完成後,如果我們拒絕讓模型在50毫秒內草率給出貪婪預測(Greedy decoding),而是讓代理人投入10秒、1分鐘甚至10分鐘深入推敲、檢驗中間步驟、並自主反覆修正假設,會發生什麼顛覆性的轉變?
依託Large Language Monkeys(Brown等人,2024)、史丹佛-柏克萊Charlie Snell研究團隊的Compute-Optimal Scaling(Snell等人,2024)以及Archon模組化架構搜尋框架,我們將從數學理論與系統工程雙重視角,徹底解析**「如何透過投入推理算力(FLOPs)打破參數規模壟斷,實現智慧躍遷」**。
flowchart TD
    subgraph PreTrain ["經典前沿:預訓練時間計算縮放 (Train-Time Scaling)"]
        direction TB
        P1["數十兆公開網路資料標記 (D)"] --> P2["超大規模GPU訓練叢集 (C_train)"]
        P2 --> P3["事後權重凍結的稠密模型 (θ)"]
        P3 --> P4["單次前向傳播推理 (O(1) 固定推理算力)"]
    end

    subgraph TestTime ["CS329A前沿:推理時間計算縮放 (Test-Time Compute Scaling)"]
        direction TB
        T1["凍結的基礎權重 (θ)"] --> T2["動態分配推理計算量 (FLOPs)"]
        T2 --> T3{"問題難度自適應策略選擇"}
        T3 -- "低難度 (Bin 1-2)" --> T4["循序修正 (Sequential Revision: 自我除錯)"]
        T3 -- "高難度 (Bin 3-5)" --> T5["PRM引導的樹搜尋 (MCTS / 束搜尋)"]
        T4 --> T6["過程獎勵模型 (PRM) 驗證器"]
        T5 --> T6
        T6 --> T7["數學與機制上雙重驗證的最佳解"]
    end

    PreTrain -.->|"拐點:參數擴展飽和"| TestTime