[Stanford CS329A #4] 工具調用與程式碼執行反饋:ReAct、RLEF與憲法級自我修正
· 閱讀時間約 17 分鐘

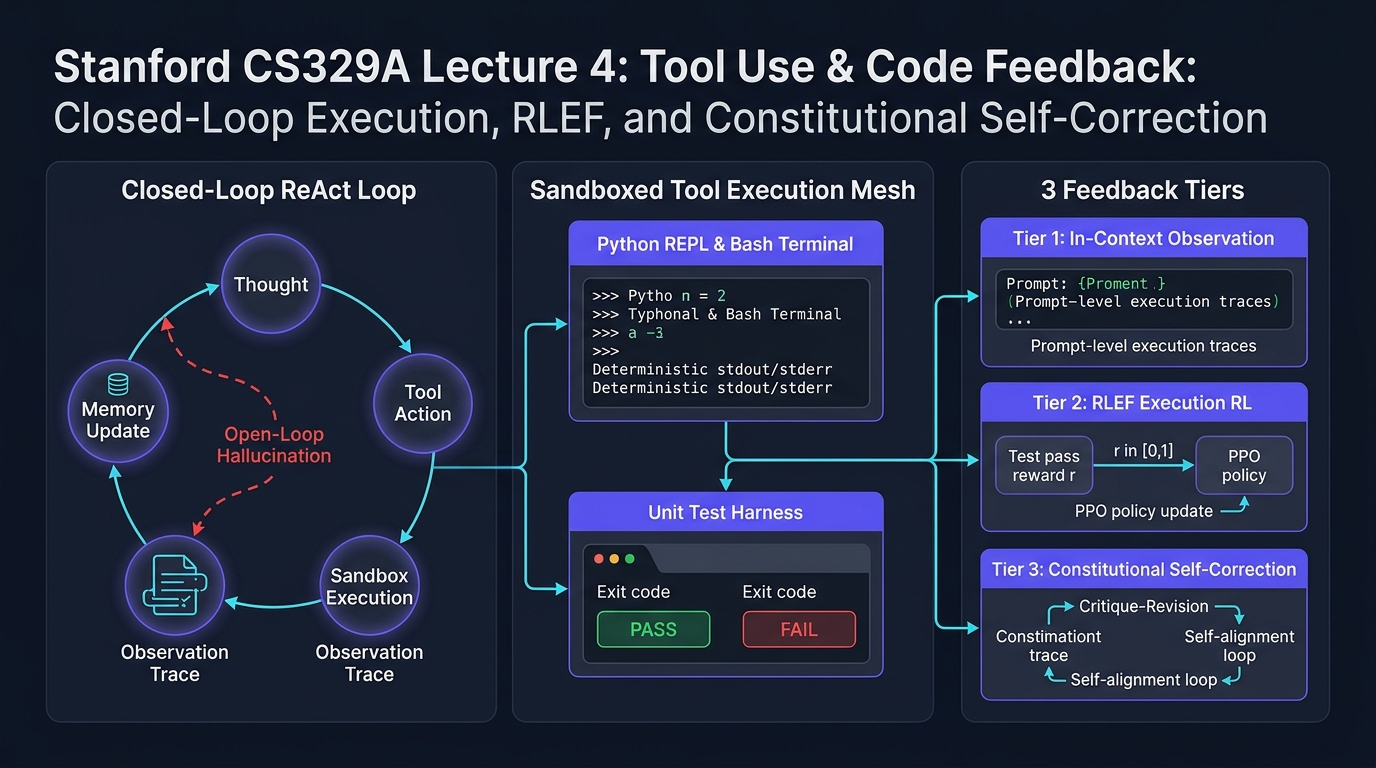
歡迎來到史丹佛大學2025秋季最新研究生課程——**CS329A: Self-Improving AI Agents(自主進化AI智能體)**的第四篇深度工程解析。
在第2講與第3講中,我們系統剖析了測試時計算擴展(Test-time Compute Scaling)與過程獎勵模型(PRM),掌握了語言模型如何展開推理搜尋樹並驗證中間數學推導的內在邏輯。然而,無論思維鏈(CoT)推理多麼精妙,僅僅局限於純文字生成的模型本質上依然是**「被關在封閉考場內答卷的考生」**。它們只能依賴預訓練階段寫入神經網絡的靜態、凍結參數記憶(Parametric Memory)。面對即時演變的世界現實、動態Web API或語法要求嚴苛的程式碼執行環境,與外部物理隔離的模型不可避免地會陷入以假亂真的「幻覺(Hallucination)」。
今天的第4講正是帶領智能體走出封閉考場的決定性轉折點:工具調用(Tool Use)與程式碼執行反饋循環(Feedback Loops)。
現代自主智能體不再將程式碼或API調用僅僅視作最終的文字輸出,而是將其轉化為與外部環境進行互動的感知器(Sensor)與執行器(Actuator)。本講中,我們將深入拆解將靜態語言模型升級為自主閉環智能體的三大核心反饋層級:
- 提示詞層面的環境互動反饋: 思維與行動協同並進的 ReAct(Yao et al., 2022)
- 策略網絡層面的執行診斷反饋: 將編譯器與測試集報錯直接刻入模型權重的 RLEF(Reinforcement Learning from Execution Feedback, 2024)
- 自主監督層面的價值對齊修正: 以自然語言憲法原則替代高昂人工標註的 Constitutional AI(Anthropic, 2022)
flowchart TD
    subgraph ClosedLoop ["閉環智能體核心架構 (Closed-Loop)"]
        direction TB
        Agent["自主智能體核心 (LLM Policy)"]
        Thought["內部語言推導 (Thought Space L)"]
        Action["可執行工具調用 (Action Space A)"]
        Sandbox["隔離程式碼沙箱 (Python REPL / Shell / Search)"]
        Obs["確定性環境觀測反饋 (Stdout / Stderr)"]

        Agent --> Thought
        Thought --> Action
        Action --> Sandbox
        Sandbox --> Obs
        Obs -->|"更新上下文記憶 (c_{t+1})"| Agent
    end

    subgraph FeedbackTiers ["智能體反饋的三大進化層級"]
        direction TB
        T1["層級 1: 上下文環境互動反饋 (ReAct)<br/>• 思考與行動交錯循環: Thought + Action + Observation<br/>• 多跳知識檢索任務中事實捏造幻覺率降至 0%"]
        --> T2["層級 2: 策略權重級執行反饋 (RLEF)<br/>• 馬可夫決策過程(MDP)建模: State, Action, Sandbox Reward<br/>• 公開/私有雙重測試集結合 PPO 演算法優化<br/>• Llama-3.1-70B 在 CodeContests 1@3 準確率從 27.5% 躍升至 40.1%"]
        --> T3["層級 3: 價值對齊自主修正 (Constitutional AI)<br/>• 基於自然語言原則的批評-修正 SFT 數據飛輪<br/>• 基於 AI 反饋的強化學習(RLAIF)訓練偏好模型<br/>• 徹底打破傳統人工標註的算力與規模瓶頸"]
    end

    ClosedLoop ==> FeedbackTiers