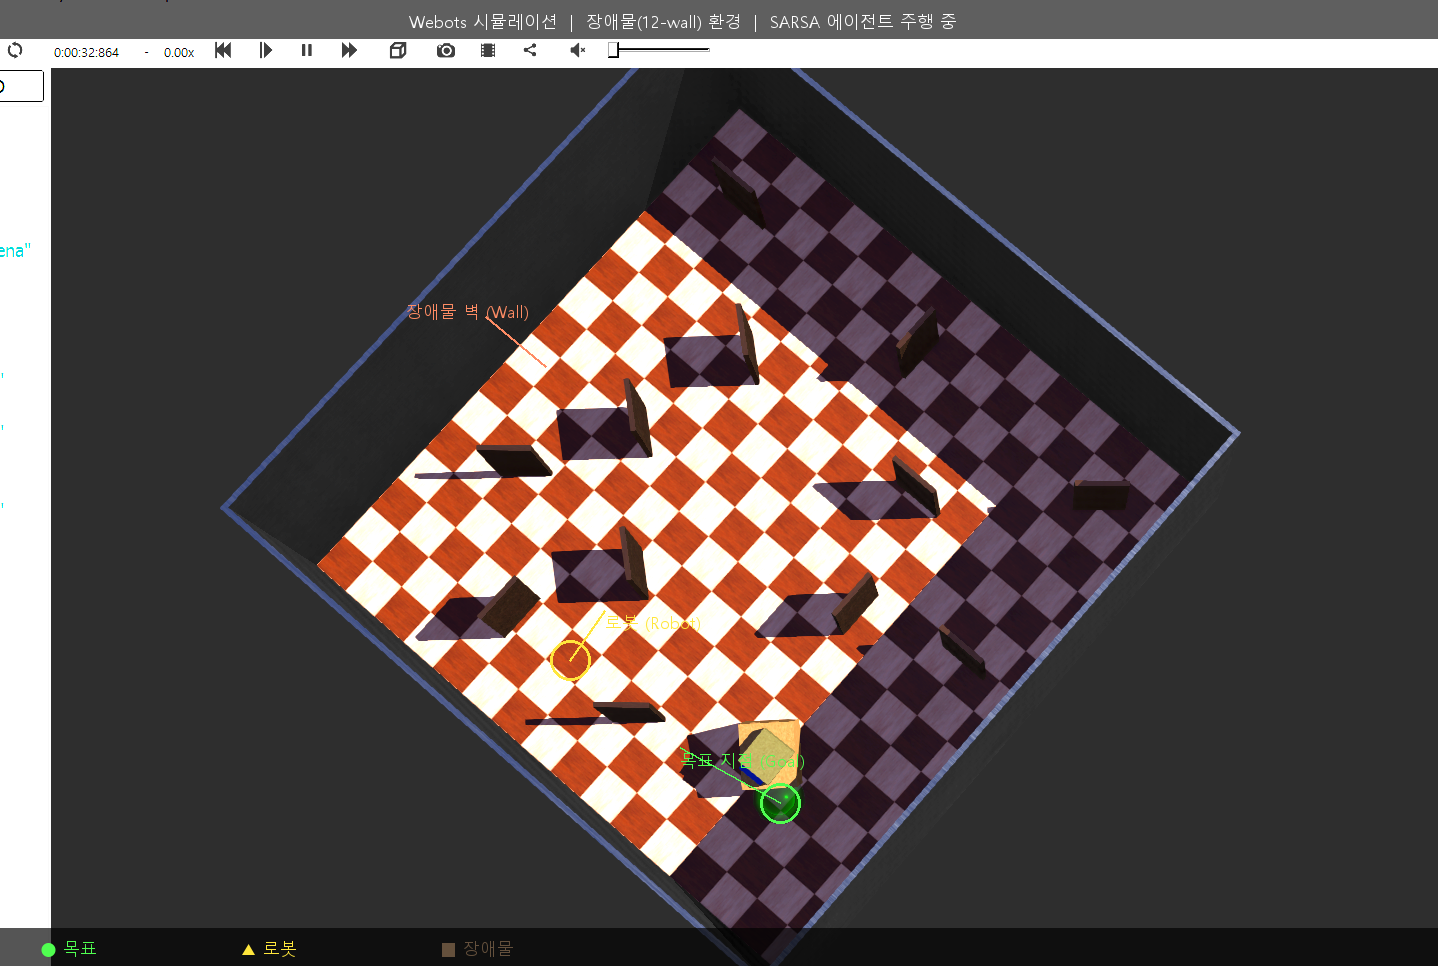
📌 核心重點 (TL;DR)
- 問題 (Problem):當目標位於牆體正後方時,由於距離增量獎勵 (+0.1 × Δdist) 固有的貪婪特性,機器人無法主動繞開障礙,而是反覆正面撞牆,深陷嚴重的局部最佳解 (Local Minima) 死結。
- 解決方案 (Solution):將 3 方向超音波搖頭掃描(前/左/右)狀態感知與長遠視野貝爾曼最佳價值反向傳播 (γ = 0.99) 相結合,並建構基於 PowerShell 的 Webots Headless 無渲染加速管線 (
headless_run.ps1),對種子 0、1、2 進行自動化重複實驗。
- 實驗結果 (Result):在 12 面牆體障礙環境下,代理人成功習得穩健的側向繞行策略 (Detour Policy),訓練 600 個回合後目標抵達成功率穩定維持在 90% 以上。
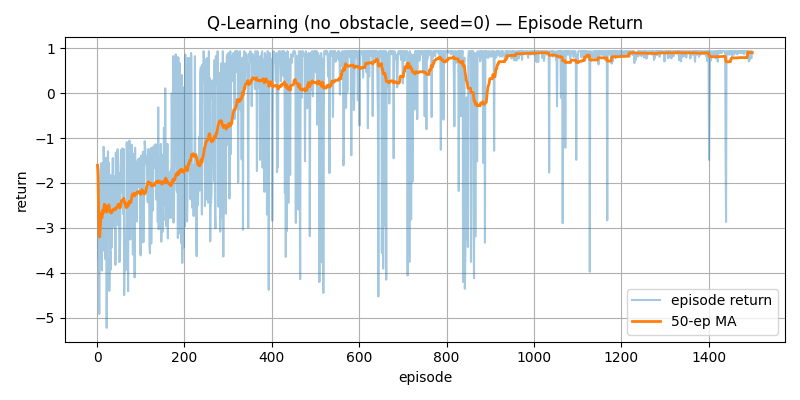
📌 核心重點 (TL;DR)
- 問題 (Problem):在僅於目標抵達 (+1.0) 與牆面碰撞 (-1.0) 時給予反饋的稀疏獎勵 (Sparse Reward) 環境下,代理人往往需要經歷數千個回合的原地打轉或盲目徘徊,才能偶然遭遇目標,探索嚴重延遲。
- 解決方案 (Solution):設計了結合基於位能的歐氏距離增量獎勵 (+0.1 × Δdist) 與單步 (-0.01)、轉向 (-0.01)、倒車 (-0.05) 懲罰的多目標稠密獎勵塑造 (Dense Reward Shaping) 機制,並搭配指數衰減的 ε-貪婪 (Epsilon-Greedy, 1.0 → 0.05) 探索策略。
- 實驗結果 (Result):在無障礙 (
no_obstacle) 情境下,移動平均獎勵在 500 個回合以內穩健轉正並進入高位區間 (0.7+),最終導航成功率達到 98% 以上。
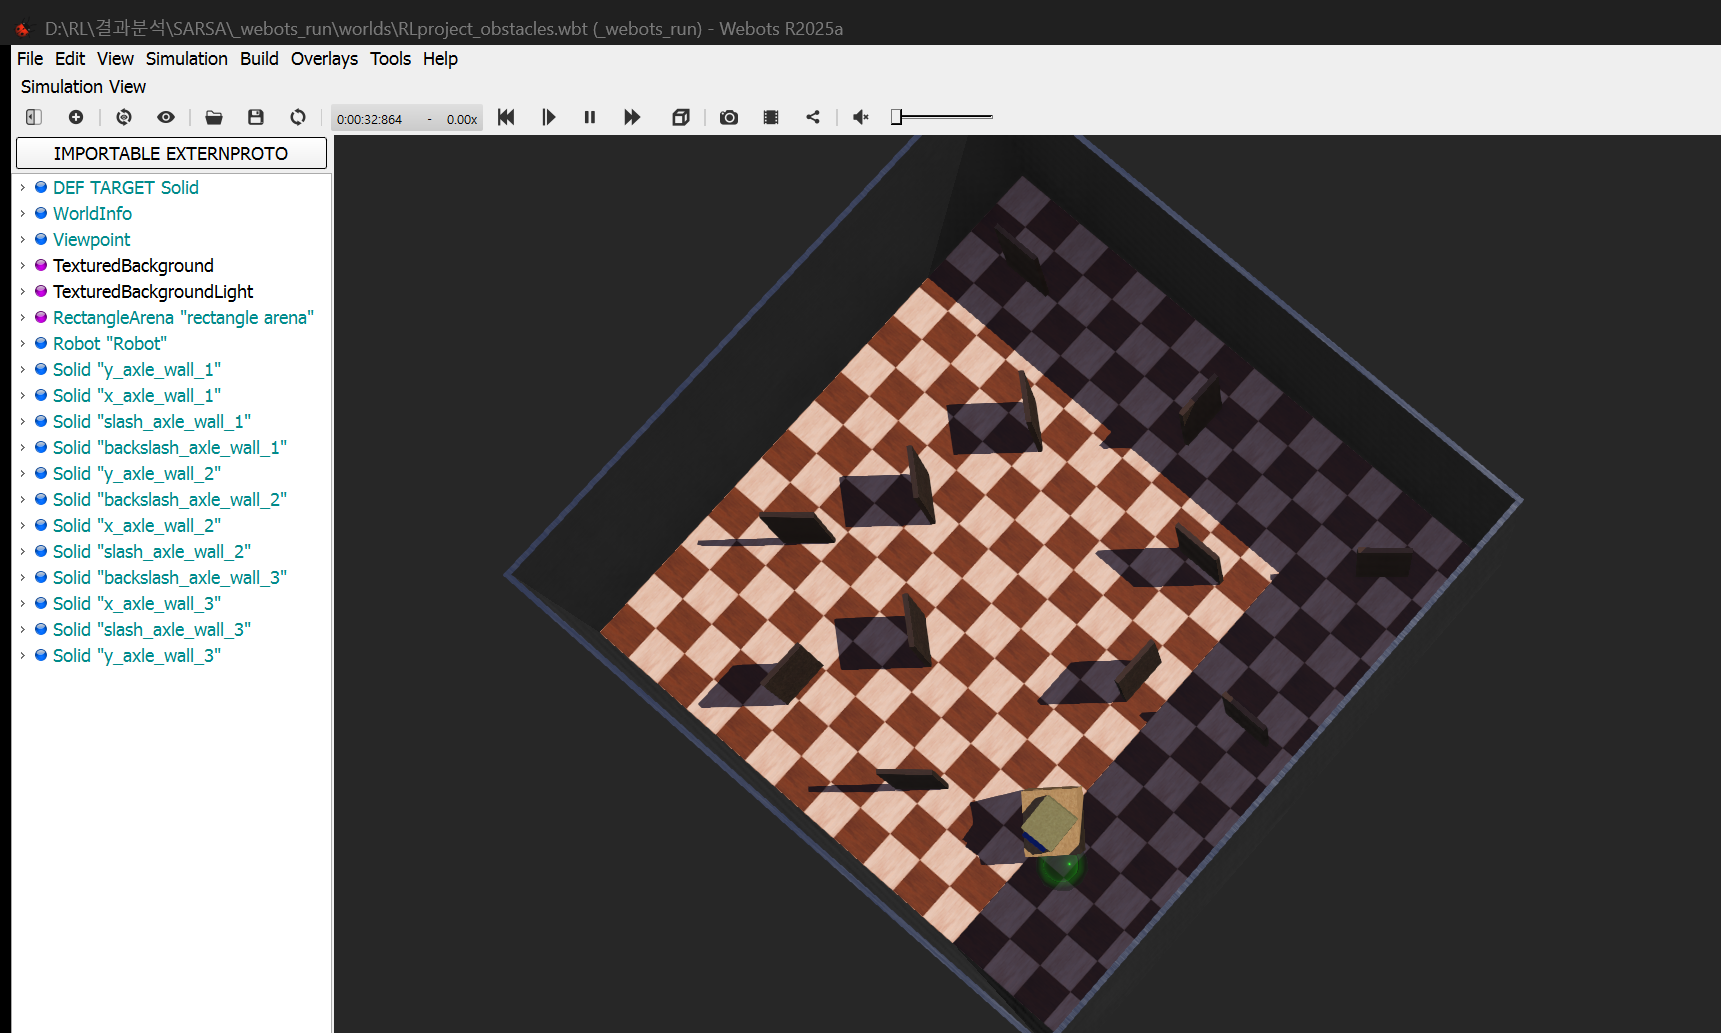
📌 核心要點 (Key Takeaways)
- 問題痛點:連續感測器讀數(距離、朝向角)會導致表格型強化學習遭遇維度災難(State-Space Explosion),同時 Python 強化學習代理與 Webots 模擬核心之間需要維持微秒級、低延遲的物理同步。
- 解決方案:設計了基於幾何學空間劃分的 5 維連續感測器量化器(
discretizer.py),產生 3 × 8 × 3 × 3 × 3 = 648 維離散狀態;搭建了基於 TCP 5000 連接埠的極輕量級行分隔 JSON 套接字通訊管線。
- 落地成效:實作了 O(1) 複雜度的超高速 Q-Table 定址更新,確保了模擬器與 Python 端 32ms 物理模擬步長的一致無阻塞同步。
