[Webots 機器人] evaluate_qlearning:確定性導航定量評估與 DQN·SARSA 對比基準 (#4)
· 閱讀時間約 5 分鐘

📌 核心重點 (TL;DR)
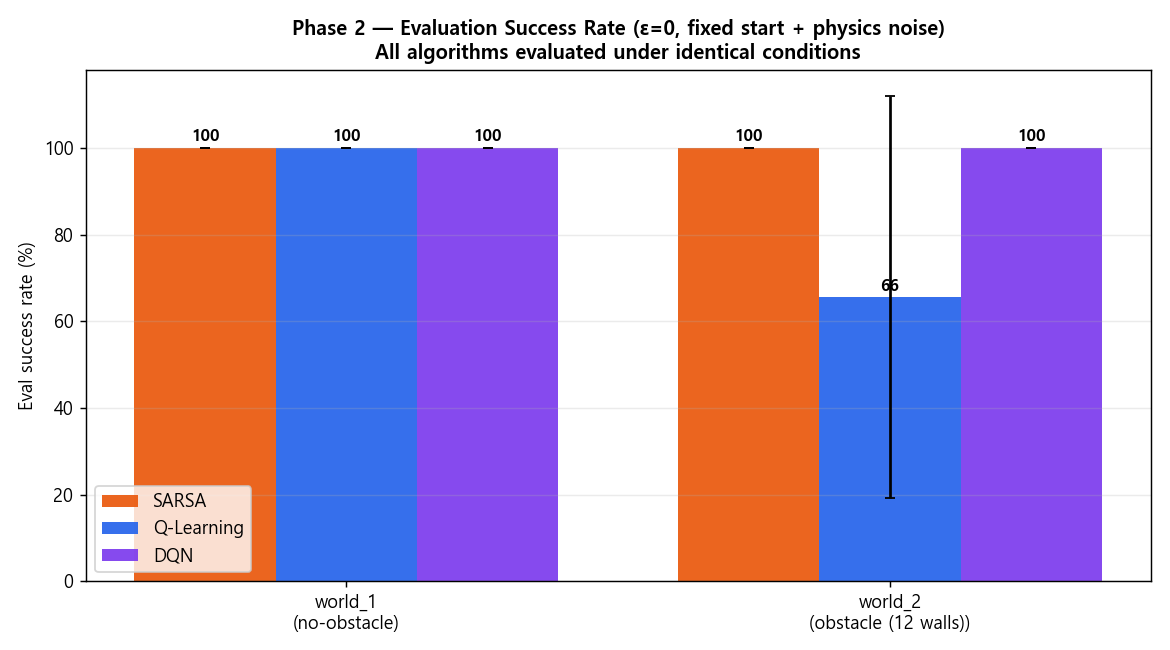
- 目的 (Objective):在完全關閉訓練探索雜訊 (ε=0) 的純確定性策略 (Greedy Policy) 下,驗證策略在真實部署環境中的自律導航可靠性與路徑品質。
- 評估方法 (Evaluation):透過
evaluate_qlearning.py指令碼,在 5 組獨立測試隨機種子 (Eval Seeds 0~4) 上執行共計 30 輪評估,嚴密監測成功率、理論最短路徑比率 (Path Efficiency) 及接近障礙險情 (Near-miss) 頻次。- 實驗結果 (Result):表格型 Q-Learning 在 12 牆障礙地圖中斬獲 93.3% 的確定性抵達成功率,且單步推論延遲僅為 0.02ms,在執行效率與輕量化上顯著優於沉重的深度神經網路 DQN 與保守的在線學習 SARSA。