[Maeumjigi 心語伴侶畢業專題開發日誌 #21] 語料混合配比黃金分割與第 4 輪微調全面打響
· 閱讀時間約 2 分鐘

5 月 21 日與 22 日兩天,Maeumjigi 畢業專題團隊全量投入了針對全新高品質語料的大規模批次產生,並正式拉開了第 4 輪微調實驗 (fine_tuning_4) 的帷幕。
5 月 21 日與 22 日兩天,Maeumjigi 畢業專題團隊全量投入了針對全新高品質語料的大規模批次產生,並正式拉開了第 4 輪微調實驗 (fine_tuning_4) 的帷幕。
5 月 19 日至 20 日的兩天時間裡,第三輪微調 (fine_tuning_3) 的評估自動化與面向生產級 App 服務的全端功能深度打磨實作了全面齊頭並進。
在徹底修復昨天排查出的別名硬編碼缺陷後,5 月 13 日,我們終於重啟了第二輪微調大模型真實端到端的推論產生能力基準測試。
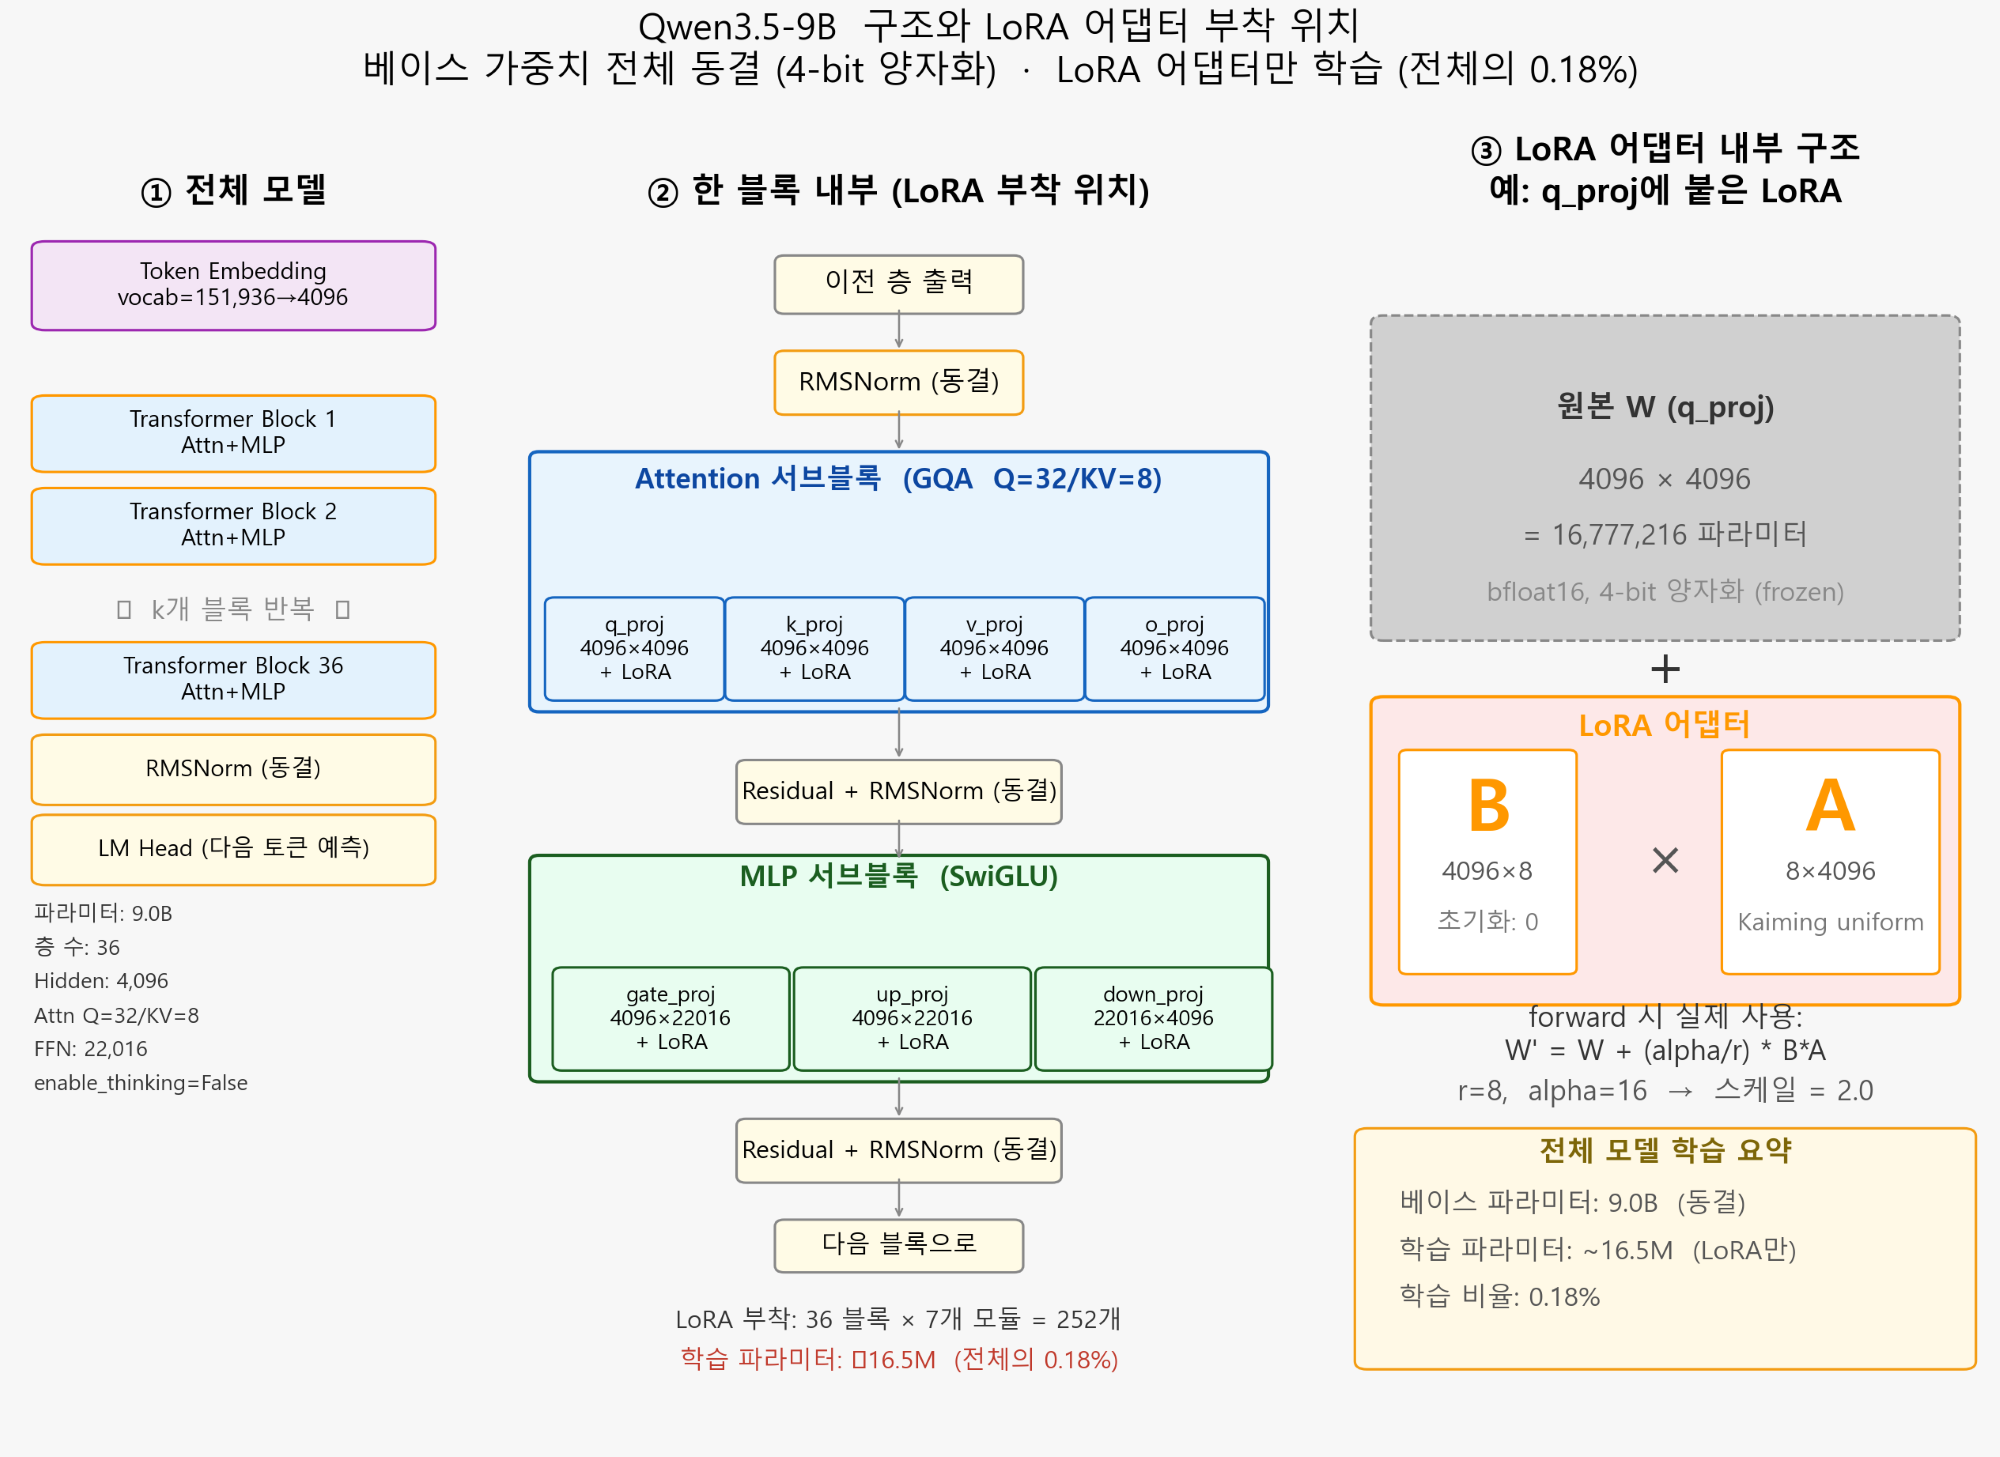
為了撥亂反正、糾正 LoRA 超參數配比倒置而倉促啟動的第二輪微調 (fine_tuning_2) 多卡平行長跑,終於在 5 月 12 日迎來了勝利的曙光!
5 月 8 日,原本是我們基於此前的全量微調成果緊鑼密鼓趕製畢業專題中期簡報投影片 (PPT) 的關鍵日子。 然而,正在滿懷欣喜填充評測表格時,我們卻突然揪出了一個令人毛骨悚然、顛覆前期結論的技術暗傷!
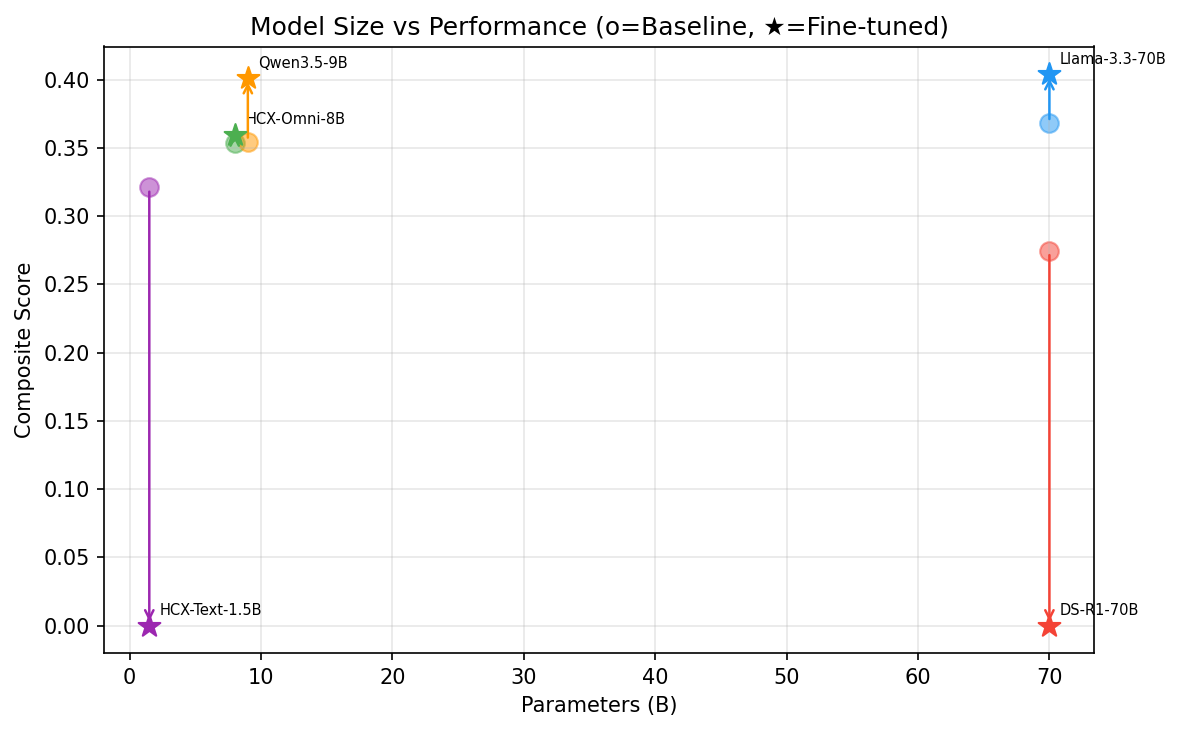
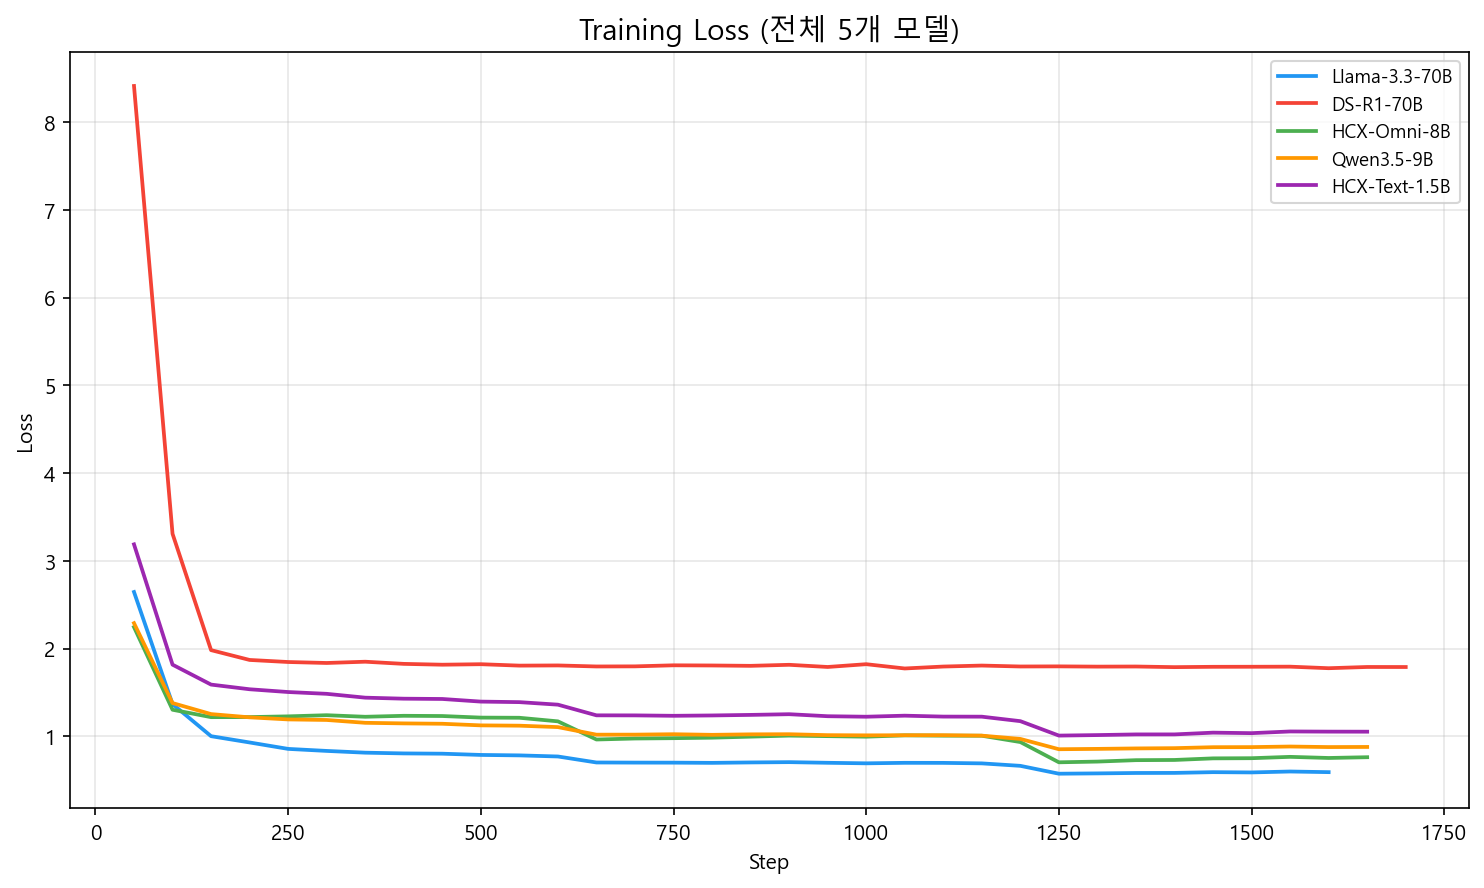
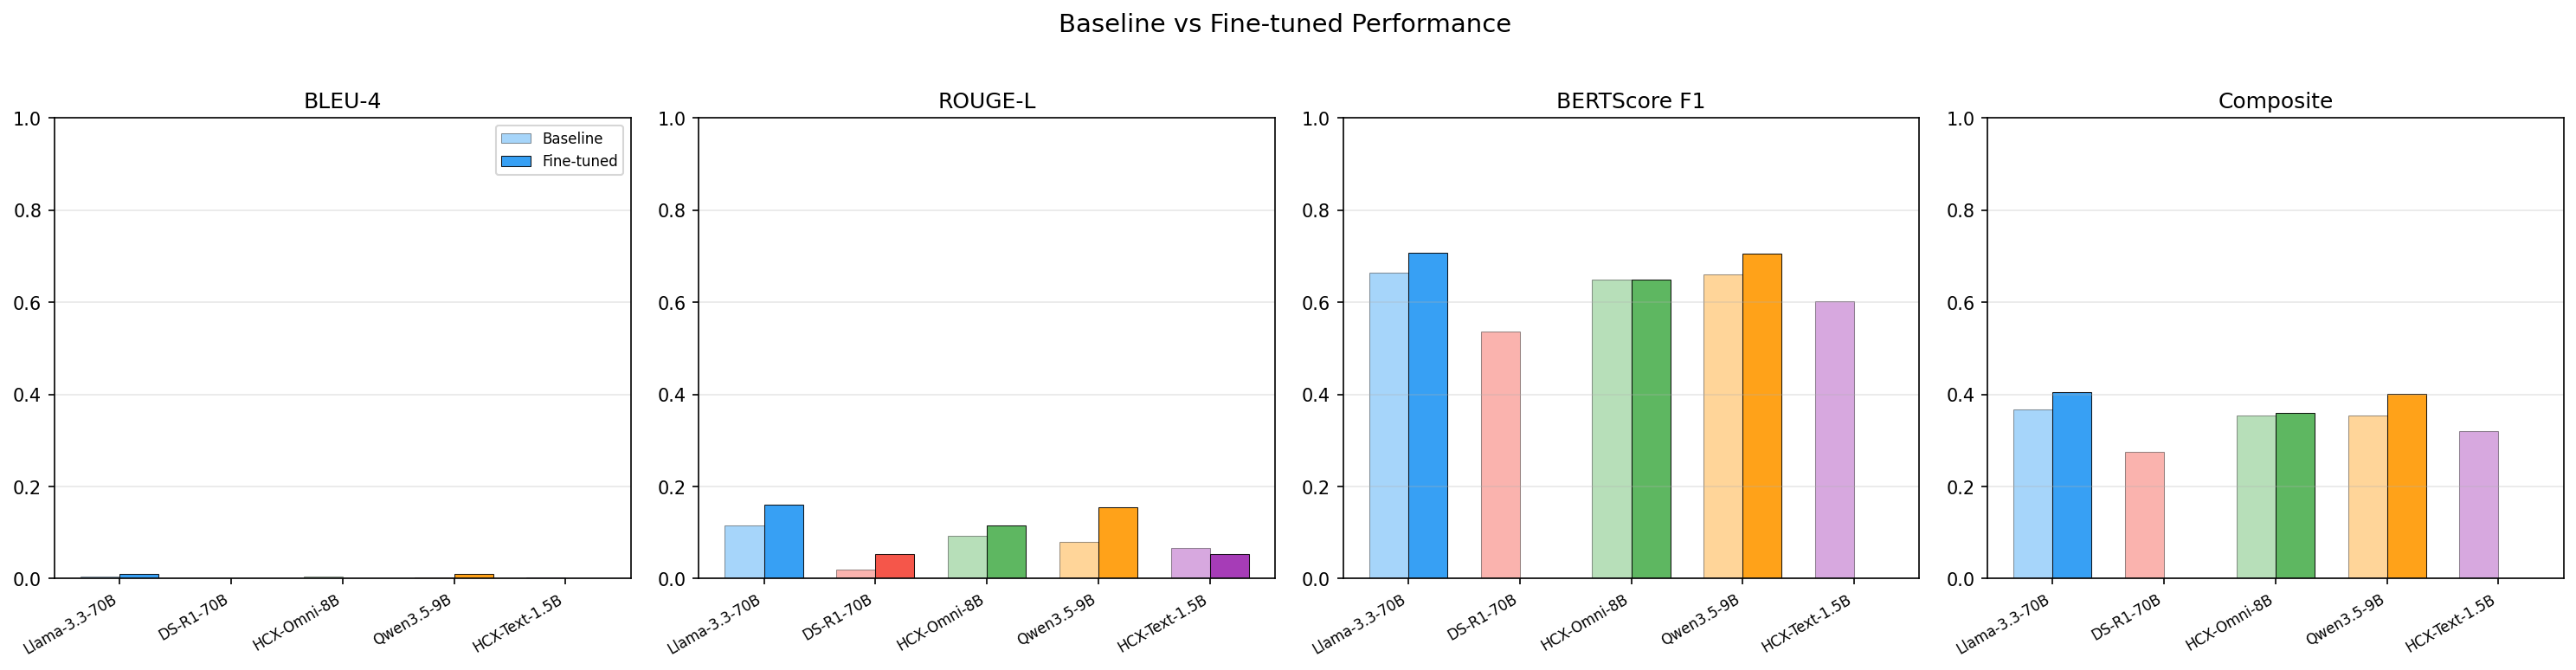
5 月 7 日,我們對傾注心血完成微調的 5 大代表性大模型(Llama 3.3-70B、DSR1-70B、HCX-Omni-8B、Qwen35-9B、HCX-Text-1.5B)的實驗資料進行了全景彙總, 並全面展開了深度視覺化與輕量化本地評測環境的建置。
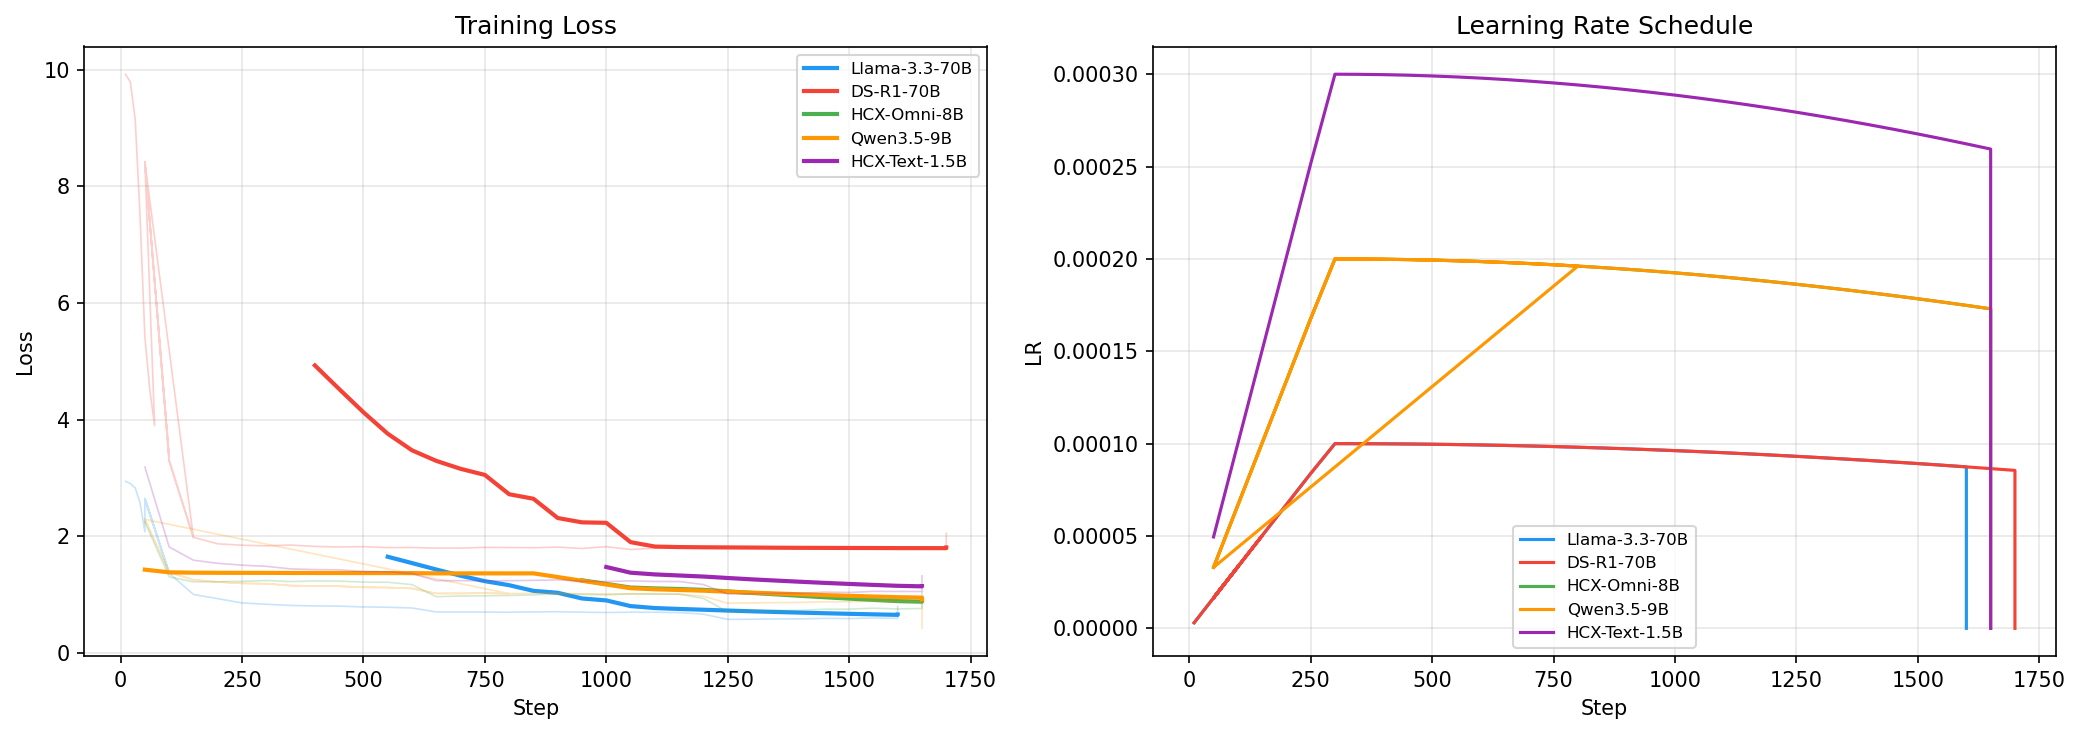
5 月 6 日,歷經數個不眠之夜與超參數反覆調試,我們終於從漫長的微調泥潭中成功破局! 以 HCX-Omni-8B 與 Qwen35-9B 為代表的中輕量級垂直大模型全量微調順利收斂完工。
在領教了 70B 龐大參數量在微調過程中的顯示記憶體地獄後,5 月 4 日,我們果斷決定實施戰略轉向。
儘管我們曾透過將 Batch Size 壓榨至極限,勉強將 70B 模型(Llama 3.3, DeepSeek-R1)推到了 checkpoint-1200 與 1300,但極其漫長遲緩的訓練週期使得整體科研迭代效率極度低下。
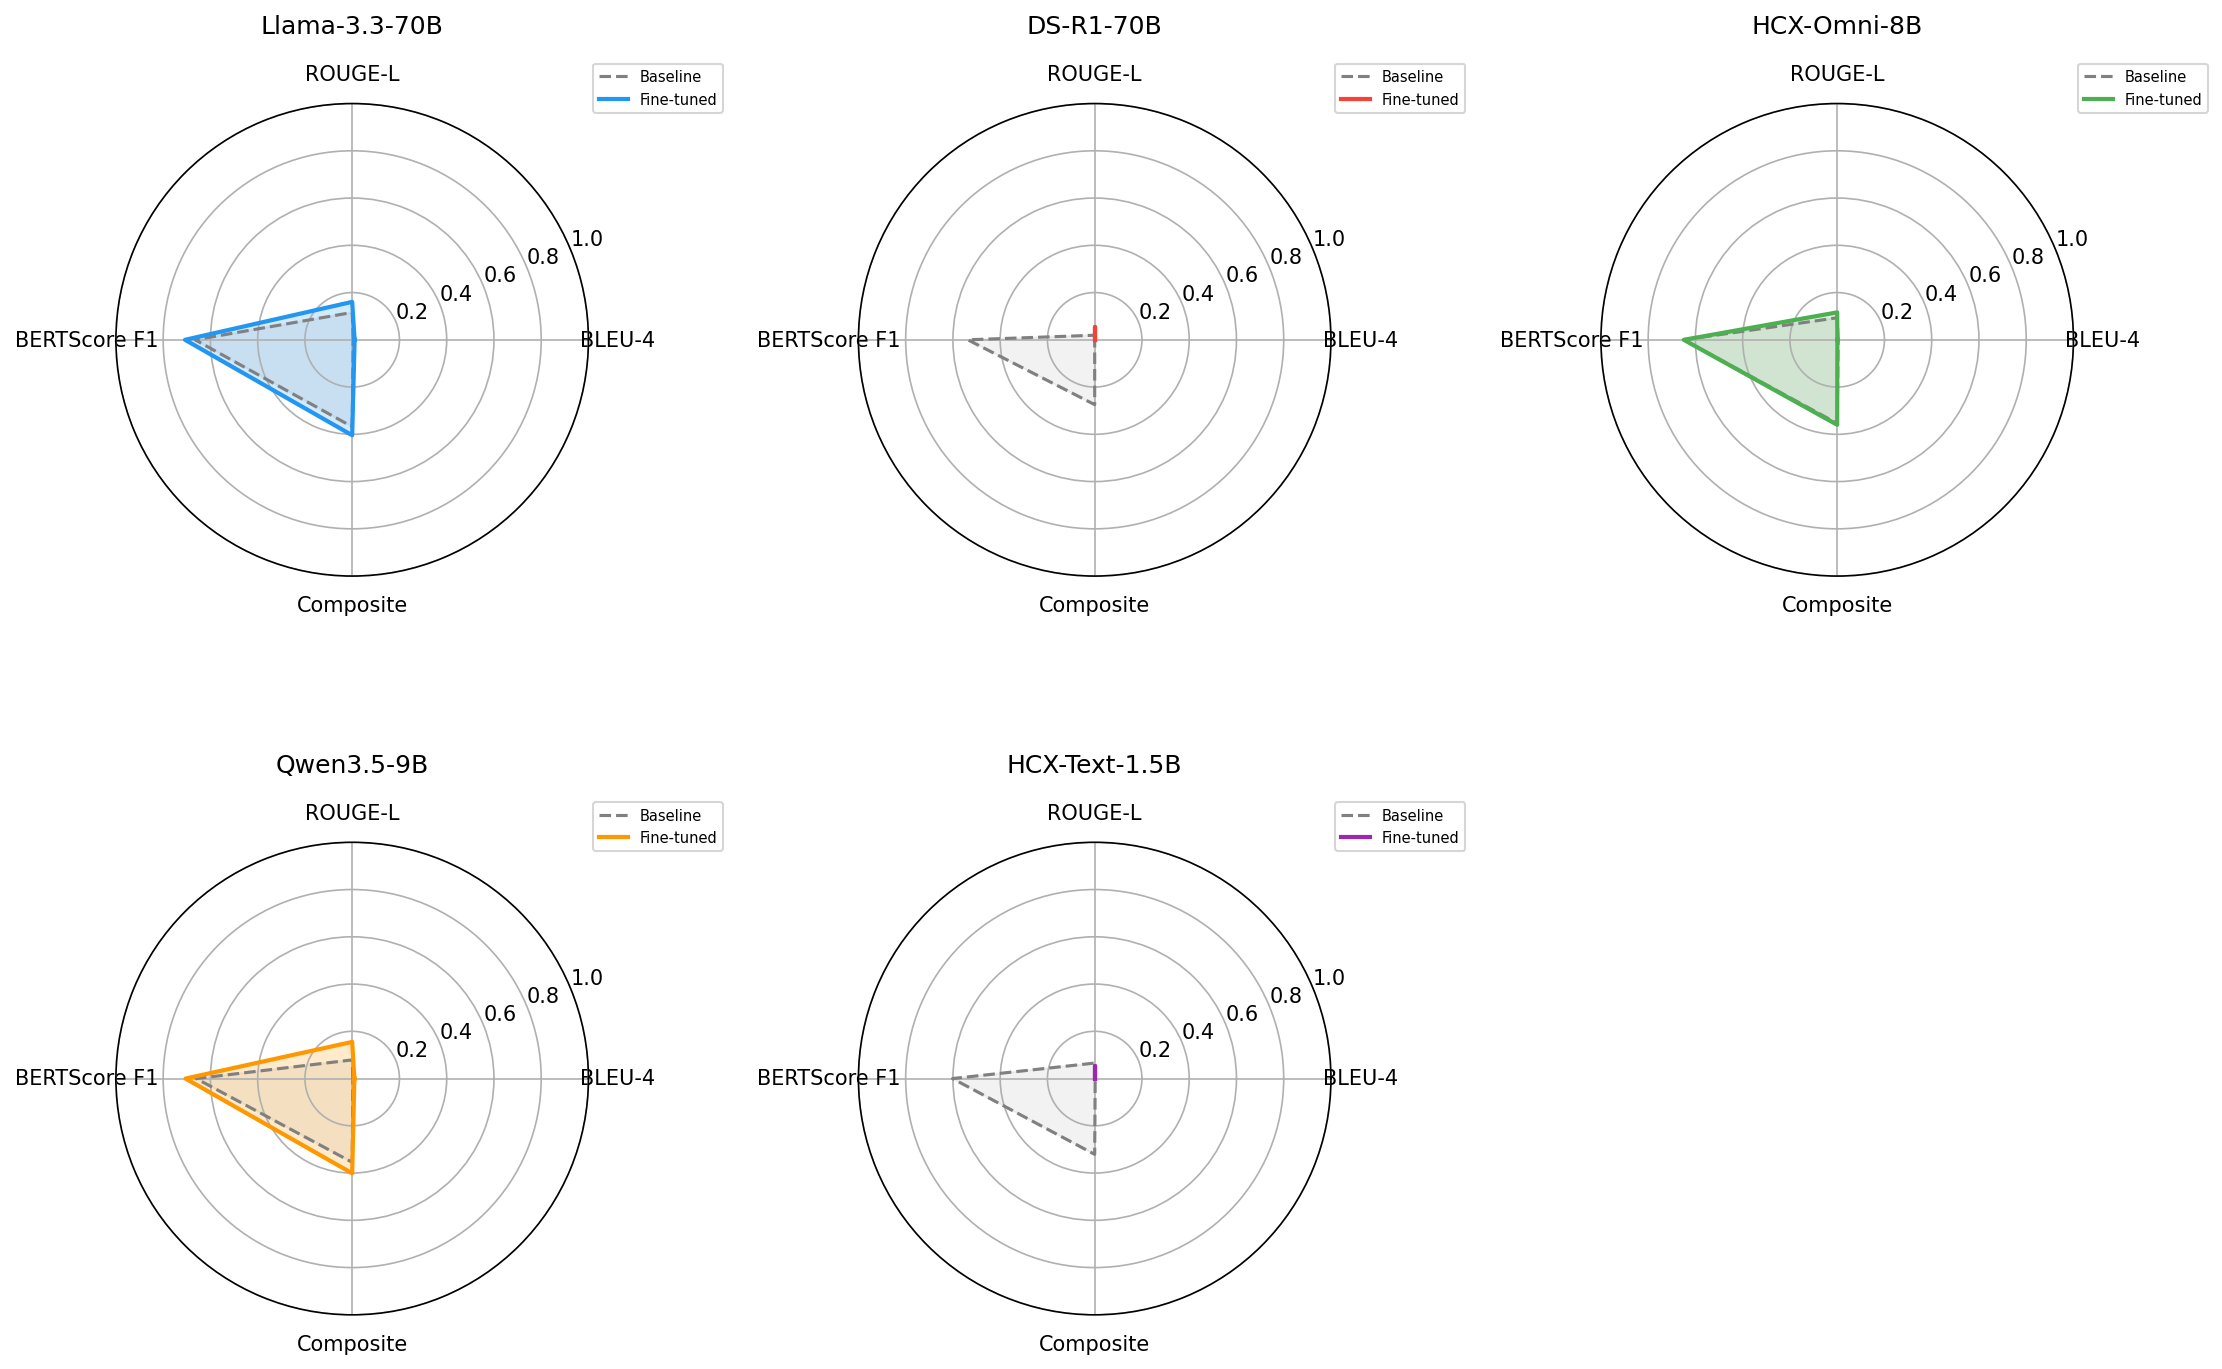
5 月 3 日,在徹底摸透 8B 小參數模型的技術脈絡後,我們團隊終於向大型語言模型的效能天花板發起衝鋒——挑戰 70B (700 億超大參數量) 模型的領域微調。 我們同時鎖定了 Llama 3.3 70B 與 DeepSeek-R1 70B 兩大旗艦底座,但不出所料,瞬間迎面撞上了嚴苛的物理顯示記憶體高牆。
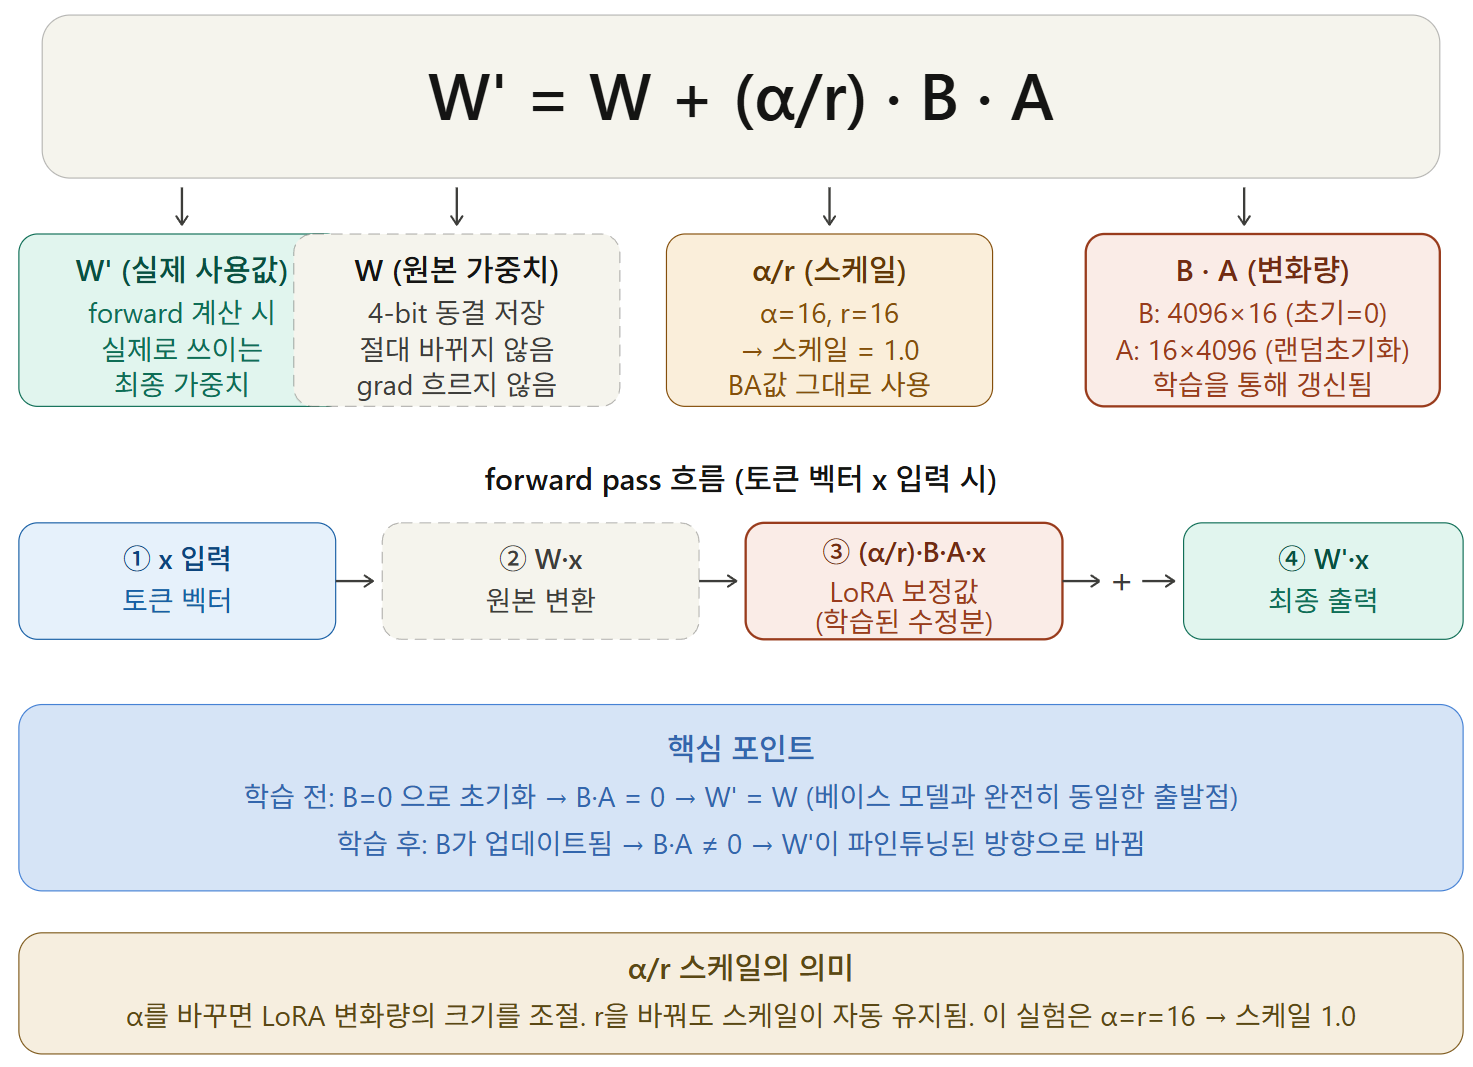
4 月 9 日,依托昨天完成的自動化 Notebook,我們終於迎來了人工智慧大模型 (Llama 3.1) 的首輪正式微調訓練。 然而現實充滿荊棘,無數報錯接踵而至。與此並行的,還有必須在深夜同步趕製第 6 週畢業專題中期簡報資料的極限挑戰。
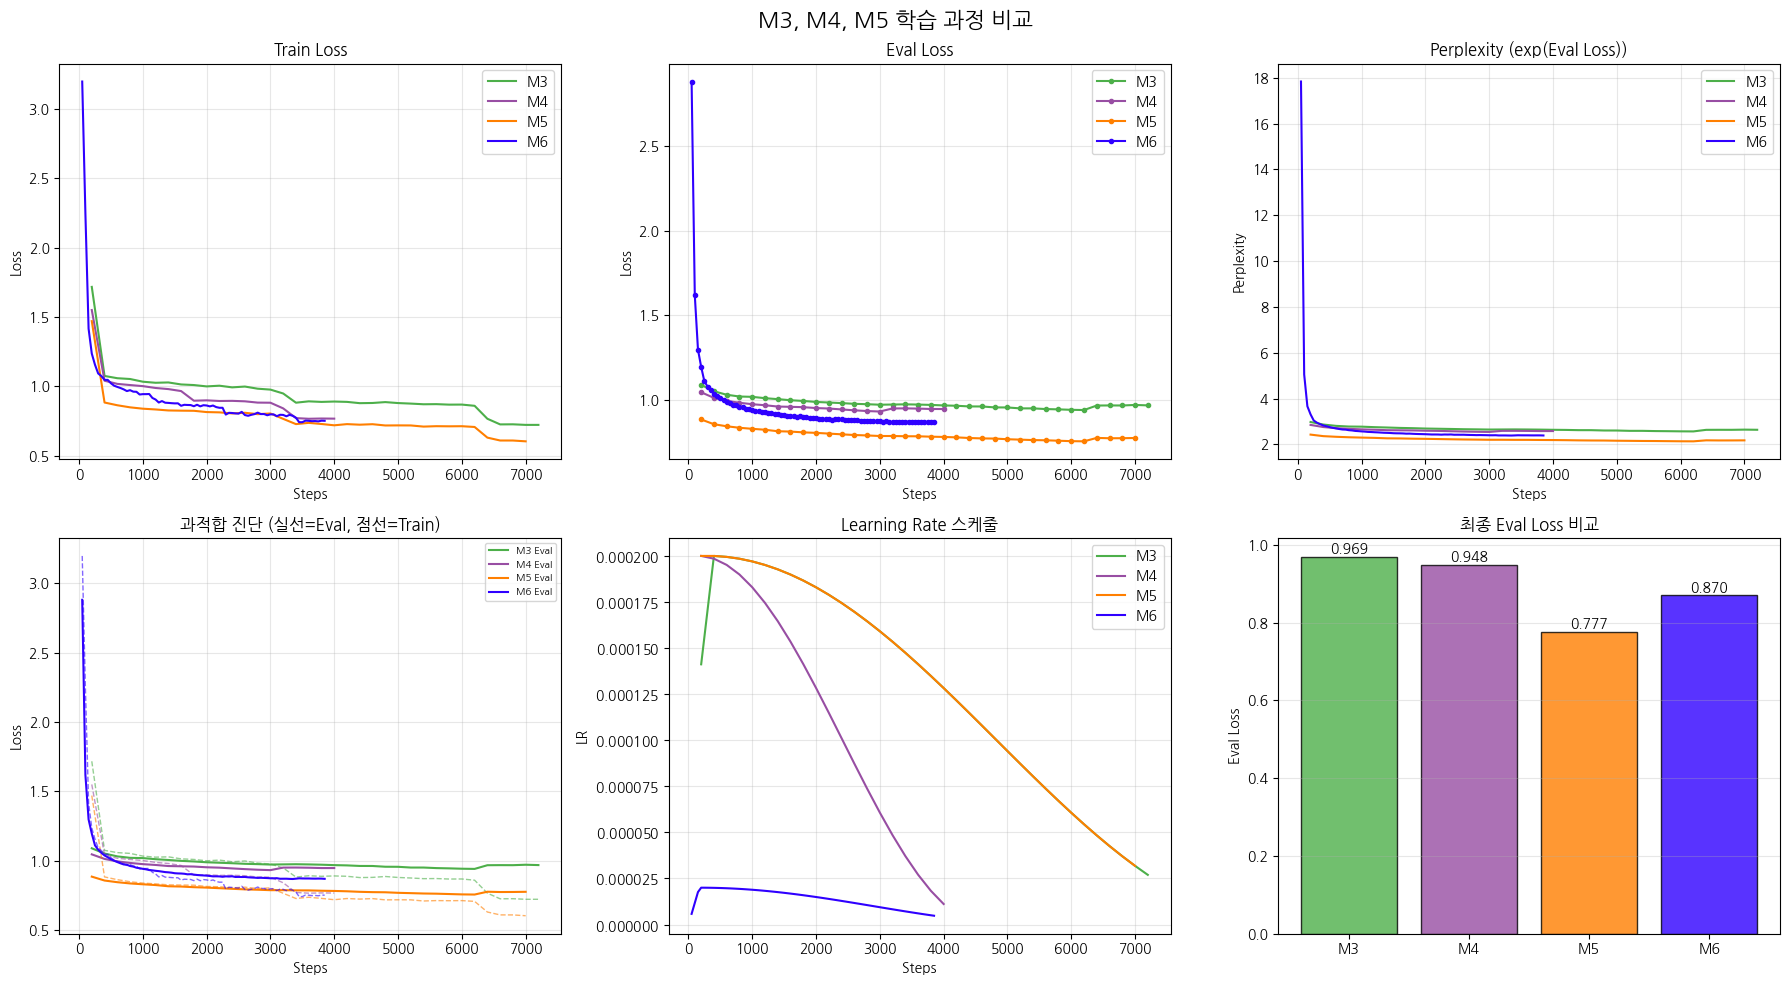
4 月 8 日,是我們在推進 Maeumjigi 專案期間經歷的最嚴峻危機,也是令人哭笑不得的技術插曲——Claude API 達到月度配額上限與突發扣費帳單危機。