[Maeumjigi 心語伴侶畢業專題開發日誌 #21] 語料混合配比黃金分割與第 4 輪微調全面打響
· 閱讀時間約 2 分鐘

5 月 21 日與 22 日兩天,Maeumjigi 畢業專題團隊全量投入了針對全新高品質語料的大規模批次產生,並正式拉開了第 4 輪微調實驗 (fine_tuning_4) 的帷幕。
5 月 21 日與 22 日兩天,Maeumjigi 畢業專題團隊全量投入了針對全新高品質語料的大規模批次產生,並正式拉開了第 4 輪微調實驗 (fine_tuning_4) 的帷幕。
5 月 19 日至 20 日的兩天時間裡,第三輪微調 (fine_tuning_3) 的評估自動化與面向生產級 App 服務的全端功能深度打磨實作了全面齊頭並進。
在徹底修復昨天排查出的別名硬編碼缺陷後,5 月 13 日,我們終於重啟了第二輪微調大模型真實端到端的推論產生能力基準測試。
為了撥亂反正、糾正 LoRA 超參數配比倒置而倉促啟動的第二輪微調 (fine_tuning_2) 多卡平行長跑,終於在 5 月 12 日迎來了勝利的曙光!
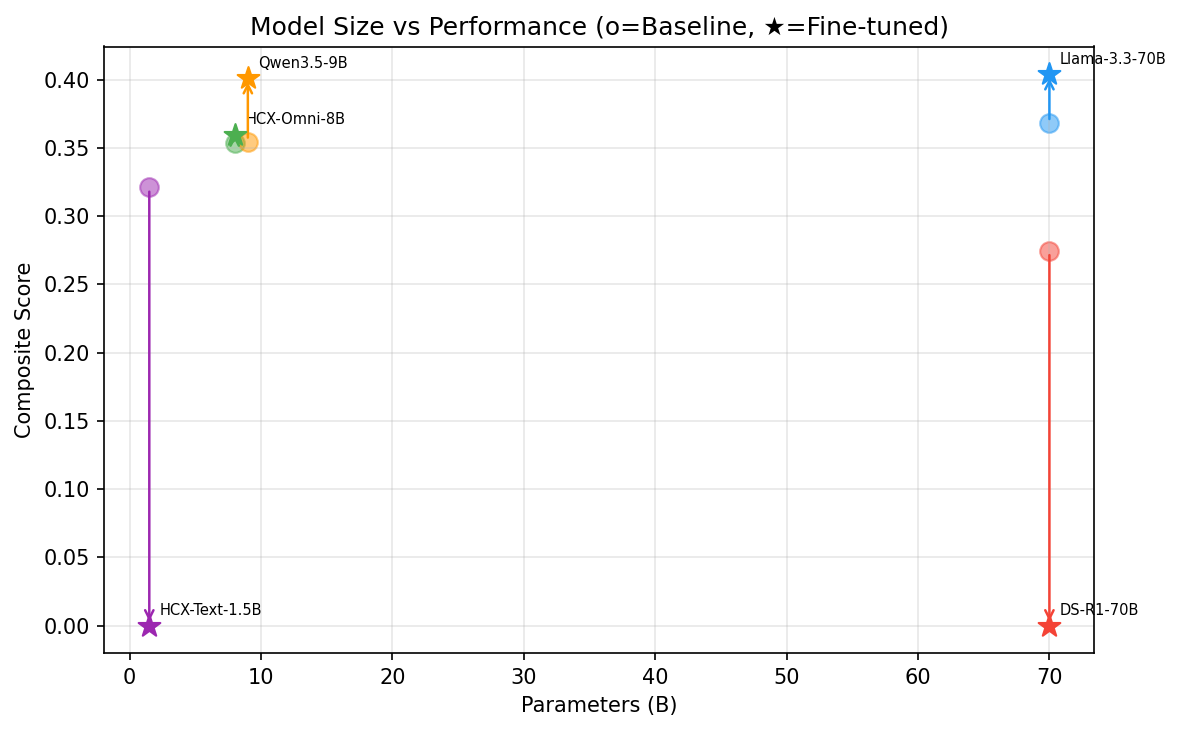
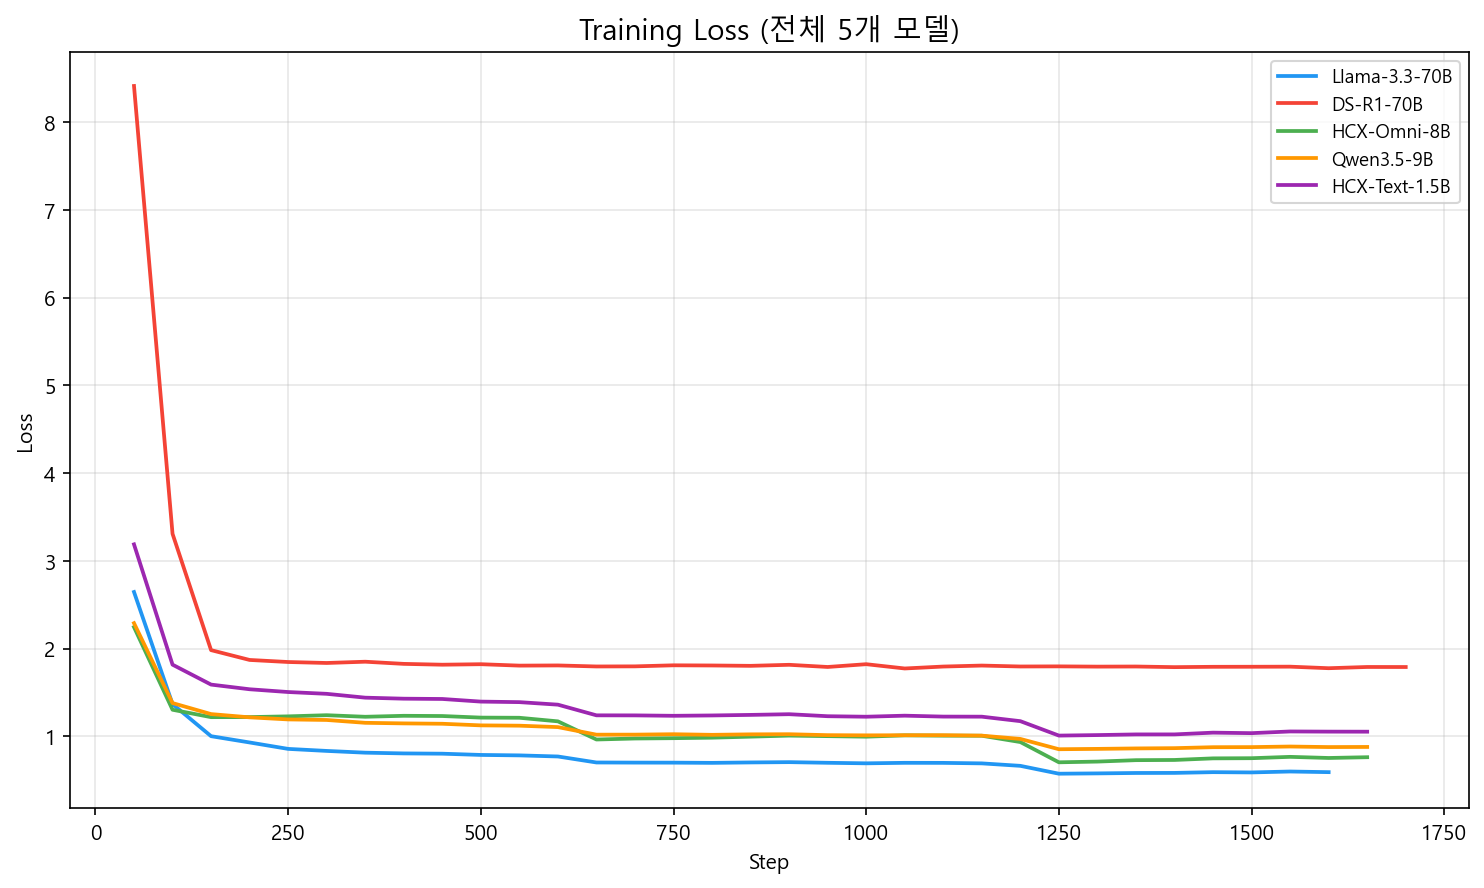
5 月 7 日,我們對傾注心血完成微調的 5 大代表性大模型(Llama 3.3-70B、DSR1-70B、HCX-Omni-8B、Qwen35-9B、HCX-Text-1.5B)的實驗資料進行了全景彙總, 並全面展開了深度視覺化與輕量化本地評測環境的建置。
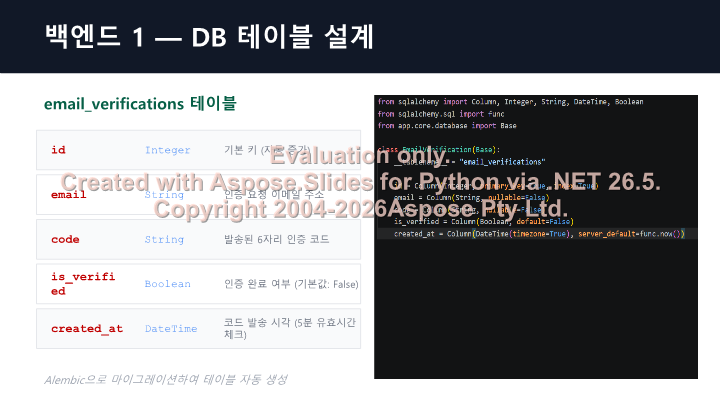
這是記錄 3 月 31 日的開發實錄。在這一天,我們既對國防會議中心預約提醒 App 進行了 Android 端建置測試, 又正式啟動了暗示專案將徹底轉型為前沿 AI 專案的 Llama 3.1 領域微調資料前處理管線。
這是記錄 3 月 30 日、正式啟動 Maeumjigi 專案雛形「國防會議中心預約提醒」應用程式研發的開發實錄。 依托上次確立的團隊編程規範,我們制定了詳盡的專案推進計畫,並為測試驅動開發 (TDD) 築牢了基底。